生成一份报表,嵌入一个 TrueType 字体,输出文件在你试过的每个查看器里都能正常打开。字形正确,文本可选,文件有效。唯一不对的是大小。一个只用了几十个拉丁字符的文档,却带着整套 350 KB 字体;一份打印了一段中文的文档,带着 14 MB 的 CJK 字体,而不是它本该只需要的那半兆级切片。没有抛异常,没有记录警告,文件也通过了验证。这就是收尾步骤顺序错位在外部的样子:没有任何东西失败,唯一的证据只是一个大得不合理的数字
它值得被当成一堂课写下来,因为这个错误的形状具有普遍性。任何文档引擎都有一个收尾阶段,会在写出对象之前对它们做最后变更,而这个阶段的正确与否,完全取决于各步骤相对于序列化的顺序。只要有一步落在写出的错误一侧,它就什么也不做,而且悄无声息
字体子集化应该做什么
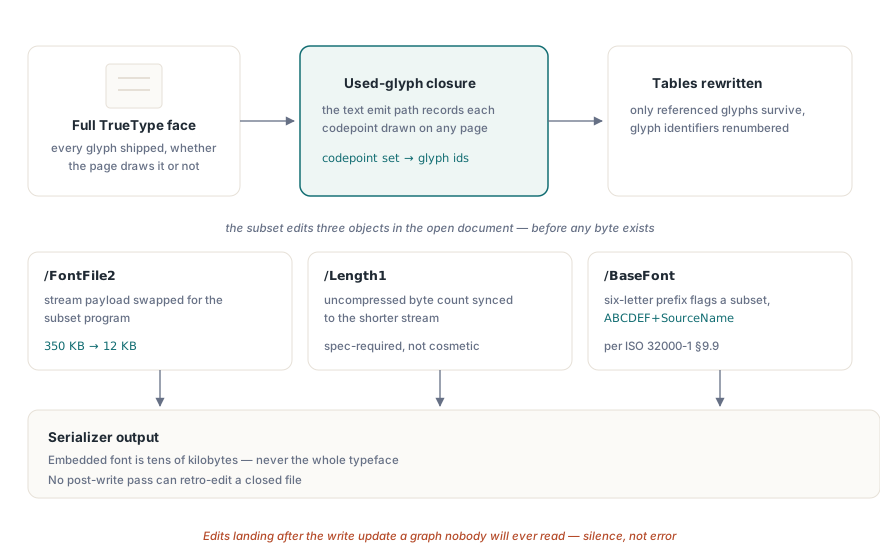
子集字体是 TrueType 文件中被文档实际使用的部分。ISO 32000-1 §9.9 描述了嵌入的字体程序如何存放在字体描述符引用的流中,对 TrueType 程序而言该流是 /FontFile2,并带有一个给出未压缩字节数的 /Length1。子集化会重写 glyf 和 loca 表,使其仅包含文档引用的字形,重新编号字形标识符,并在 /BaseFont 名称前加上 ABCDEF+ 这样的六字母标记,把字体标明为子集,与规范的要求完全一致。一个被子集化到十或十五 KB 的拉丁字体,就是精简的 PDF 与为了一个标题而携带整个字体之间的差别
这发生的时间点至关重要。子集化并不是对磁盘上已有字节施加的变换。它编辑的是内存中的对象图:缩小 /FontFile2 流的内容,修正 /Length1,重写 /BaseFont 字符串。序列化器遍历对象图并输出字节时,这些修改必须全部就位。如果编辑发生在字节写出之后,它们更新的对象就再也不会被任何人读到
症状,以及为什么没有任何报错
子集化落在写出的错误一侧时,症状就是输出带着全量字体,且没有任何诊断。注册一个 Unicode TrueType 字体,生成一份普通文档,嵌入的字体对象出来的长度和源 .ttf 文件一样,/BaseFont 名称上也没有六字母子集前缀。用十个字形的运行和用一万个字形的运行之间,输出从不缩小
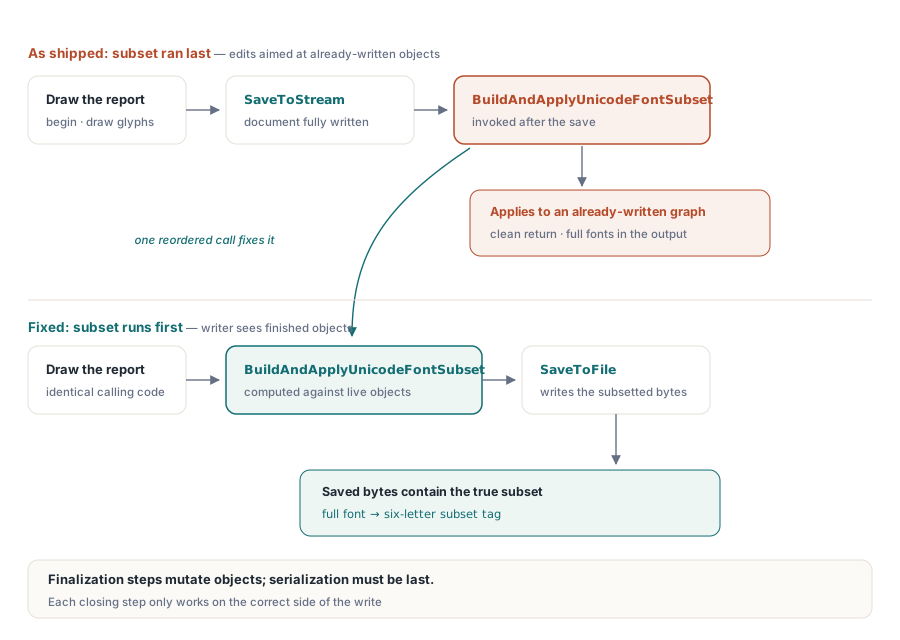
没有任何报错,正是这类错误代价高昂的原因。在错误时间运行的子集化例程照样运行。它遍历累积的码点使用情况,构建一个完全正确的子集,并把它应用到内存中的对象图。在内部,工作已完成,调用干净地返回。唯一的问题在于,它编辑的对象图已不再是即将写出的内容,因为写入器已经完工。从调用方的角度看,文档顺利生成并保存——这正是静默失败给人的印象
子集化在收尾顺序中的位置
在 HotPDF 中,关闭工作发生在 EndDoc 内部。子集化步骤是一个名为 BuildAndApplyUnicodeFontSubset 的内部例程。它读取每个文档已用码点的集合——该集合保存在文本输出路径在显示字形时填充的位图中——把每个已用码点经缓存的码点-字形映射表映射到真实的字形标识符,并围绕这个闭包重写字体程序。注册 Unicode TrueType 字体后,输出路径会为它绘制的每个字符在已用码点集合中置一个位,因此在文档关闭时,引擎确切地知道子集必须保留哪些字形
陷阱在于那个调用的位置。如果 BuildAndApplyUnicodeFontSubset 在 SaveToStream 或 SaveToFile 已经序列化文档之后才被调用,子集化对 /FontFile2 的编辑、修正后的 /Length1 和六字母 /BaseFont 前缀,就全是针对一个已经变成字节的对象图计算的。正确的顺序是先跑子集化、后序列化,这样写入器输出的才是子集化后的字体,而不是原始字体。做对它只关乎一个调用的位置,别无其他
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansSC-Regular.ttf');
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Noto Sans SC', [], 12);
    Pdf.CurrentPage.TextOut(72, 760, 0, '报表标题 Report Heading');
    Pdf.EndDoc;                 // 子集化在这里执行,早于写出
    Pdf.SaveToFile('Report.pdf');
  finally
    Pdf.Free;
  end;
end;
这一切在调用代码里都看不见。一旦注册了 Unicode TrueType 字体,子集化默认就是开启的。你注册字体、开始文档、绘制内容并结束文档,子集就会在字节离开内存之前,根据你用到的字形构建出来
为什么一个放错的步骤是一整类问题
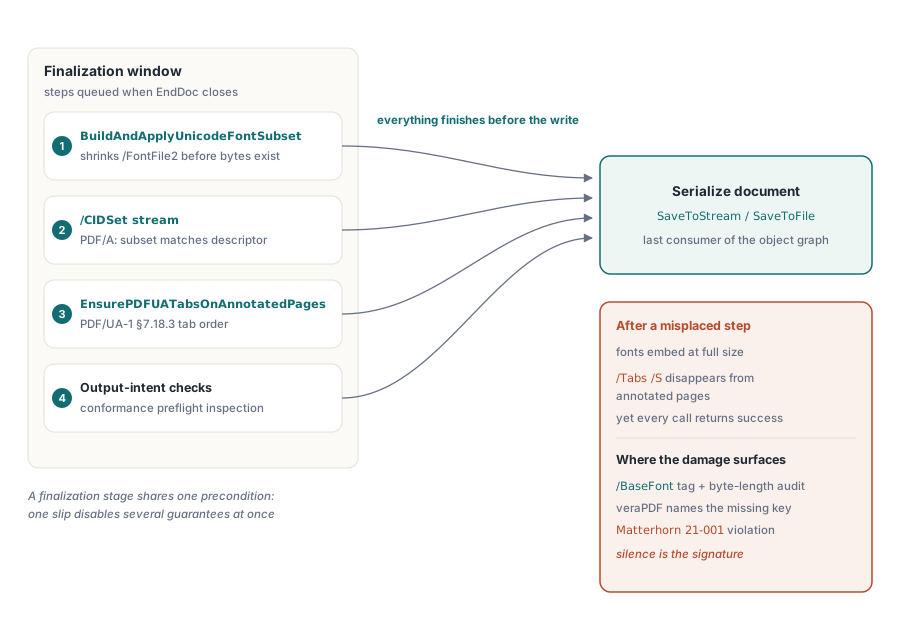
这件事值得作为一个教训而不是脚注,原因在于 EndDoc 会发出一串关闭步骤,而其中每一步都对其相对于写入的位置敏感。字体子集化是其中之一。PDF/A 输出需要一个 /CIDSet 流来精确列出子集中存在的字形标识符,这是 ISO 19005 施加的约束,好让验证器确认嵌入的程序与字体描述符声明的内容一致;该流在同一个收尾窗口中输出,并且依赖先建好的子集。PDF/UA-1 按 ISO 14289-1 §7.18.3 的要求,每个带批注的页面都必须声明值为 /S 的 /Tabs,一个名为 EnsurePDFUATabsOnAnnotatedPages 的内部例程在同一阶段盖印这个键。输出意图检查也在那里运行
让子集化失效的同一个顺序错误,也会把带批注页面上的 PDF/UA 制表顺序键一并弄丢,因为那一步就在同一个窗口里。veraPDF 和 PAC 会把缺失的 /Tabs /S 报告为违反 Matterhorn 协议检查点 21-001。所以一个放错位置的调用不只是撑大文件体积;它同时静默破坏一项可访问性合规要求,同样不带任何报错。这就是收尾阶段的危险:各步骤共享同一个前提条件,一个顺序失误可以同时打掉其中好几个,而每个调用依然返回成功
静默的输出失败实际上如何被抓住
不抛异常的失败无法靠运行程序来抓住。它靠检查输出、并把它与输入本应产出的结果做对比来抓住。对字体子集化而言,检查是具体的。把输出文件大小和一个粗略预期做对比:只碰了少数字形的文档,不应该有整套字体的个头。打开嵌入的字体对象,读它的字节长度;拉丁字体的子集化 /FontFile2 只是源文件的一小部分。读 /BaseFont 名称,确认六字母前缀存在,因为它的缺失就是未应用子集的直接信号
var
  Pdf: THotPDF;
  Output: TMemoryStream;
begin
  Output := TMemoryStream.Create;
  try
    Pdf := THotPDF.Create(nil);
    try
      Pdf.RegisterUnicodeTTF('C:\Fonts\DejaVuSans.ttf');
      Pdf.BeginDoc;
      Pdf.CurrentPage.SetFont('DejaVu Sans', [], 11);
      Pdf.CurrentPage.TextOut(72, 760, 0, 'Subset me');
      Pdf.EndDoc;
      Pdf.SaveToStream(Output);
    finally
      Pdf.Free;
    end;
    // 约 700 KB 字面里的少数字形,绝不该产出几百 KB 的流
    if Output.Size > 100 * 1024 then
      raise Exception.Create('Font subset did not shrink the output');
  finally
    Output.Free;
  end;
end;
对 PDF/A 输出,检查还可以更锋利,因为验证器会替你干活。设置合规级别,再把结果送进 veraPDF:缺失的 /CIDSet,或与描述符不匹配的子集,会被报告成一条失败条款,而不是留给你靠肉眼发现。驱动这些收尾动作的合规开关都是文档上的属性。PDFACompliance 接受 '2B' 这样的字符串,表示 PDF/A-2 Level B;PDFUACompliance 是一个布尔值,用来打开 tagged PDF 和制表顺序要求
Pdf := THotPDF.Create(nil);
try
  Pdf.PDFACompliance := '2B';     // PDF/A-2 Level B,驱动 /CIDSet 输出
  Pdf.PDFUACompliance := True;    // 在带批注的页面上盖印 /Tabs /S
  Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansSC-Regular.ttf');
  Pdf.BeginDoc;
  Pdf.CurrentPage.SetFont('Noto Sans SC', [], 12);
  Pdf.CurrentPage.TextOut(72, 760, 0, '合规报告');
  Pdf.EndDoc;
  Pdf.SaveToFile('Report_PDFA.pdf');
finally
  Pdf.Free;
end;
工程教训
从这里能提炼出两条规则。第一,任何会修改对象的收尾步骤都必须在这些对象被序列化之前运行,文档引擎的关闭阶段应该当成一条有序流水线来读,序列化是最后一个动作,而不是若干并列动作之一。第二条最容易被忘:对一个输出步骤来说,没有报错不是成功的证据。一个构建出正确子集、却把它应用到已经写完的对象图上的例程,不会报告任何异常,因为从它自己的视角看确实什么都没发生。验证必须看产物,而不是返回码。检查输出大小,读嵌入字体的字节长度和 /BaseFont 前缀,PDF/A 输出交给 veraPDF 判断——缺失的 /CIDSet 会把一个静默缺口变成一个有名字的失败
字体处理的生产侧——字面如何为报表输出注册和嵌入——见报表输出中的字体与图像一文。验证侧——这些收尾步骤如何对照标准接受检查——见PDF/A 与 PDF/UA 验证演练一文。两者都与本文描述的子集化和合规能力搭配,作为面向 Delphi 和 C++Builder 的 HotPDF Delphi Component 的一部分,随本博客其他文章介绍的加载、编辑、加密和签名 API 一同提供