解析器遇到畸形 PDF 时挂死,通常是因为某个分支读了一个字节、拒绝处理它,然后原样返回而光标纹丝不动。调用方的循环看不到任何进展,也没有理由停下,于是永远空转。HotPDF 恰恰在三个相互独立的解析器里带着这个缺陷发布过,而这三个解析器都能被不到五十字节的输入触达
这是一类值得单独命名的拒绝服务,因为它长得不像大家早就防着的那一类。没有解压、没有分配增长、没有能让看门狗触发的内存压力,进程就占着单核 100% CPU,缓冲区里只有几十个字节。如果你读过嵌套过滤器放大与 PDF 炸弹之后加了解码预算,这个预算在这里不会生效:没有东西在解码,也没有东西在分配。不同的故障,不同的修法
为什么一个四十字节的文件比解压炸弹更贵?
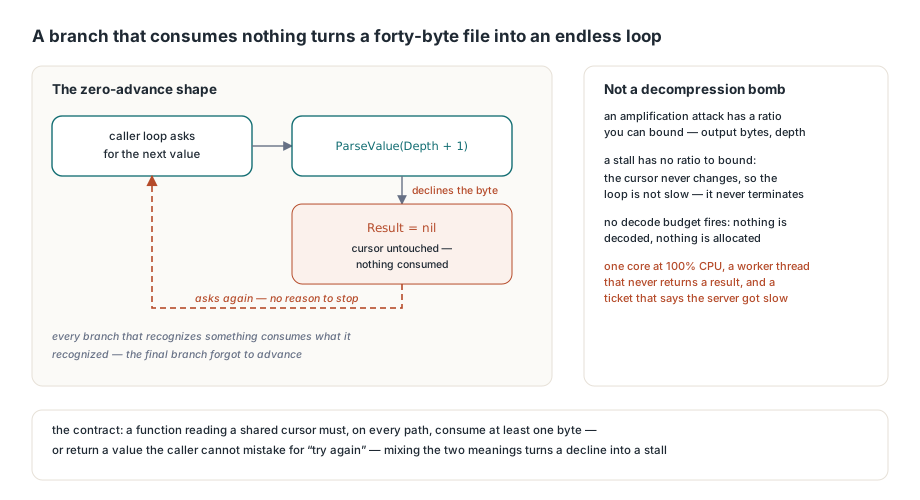
因为代价和输入大小根本无关。放大攻击有可以约束的比例:限制输出字节、限制递归深度,最坏情况就是有限的。零前进的循环没有任何比例可以约束。循环条件是某个永远不会变化的光标的函数,所以它不是慢,而是根本不终止,上游任何基于大小的限制都拦不住它。这也让它在运维上格外难缠。崩溃会给你一份堆栈,内存不足会给你一行日志,而停滞的解析器给你的是一个永远不返回结果的工作线程、一个永远不会超时的请求——下游根本没人知道它开始了——以及一张写着"服务器周二变慢了"的工单。结构上的成因永远是同一个形状。分词器或取值解析器有一串以当前字节为键的分支。每个识别出内容的分支都会消费它识别到的东西。然后还有一个最终分支,或者链路前的守卫,为没人认领的字节返回,而作者把它当作错误路径而不是扫描步骤来推理。错误路径会返回。扫描步骤会前进。当同一个函数必须同时扮演两种角色时,被忘掉的往往是前进
对象解析器:两个没人消费的分隔符
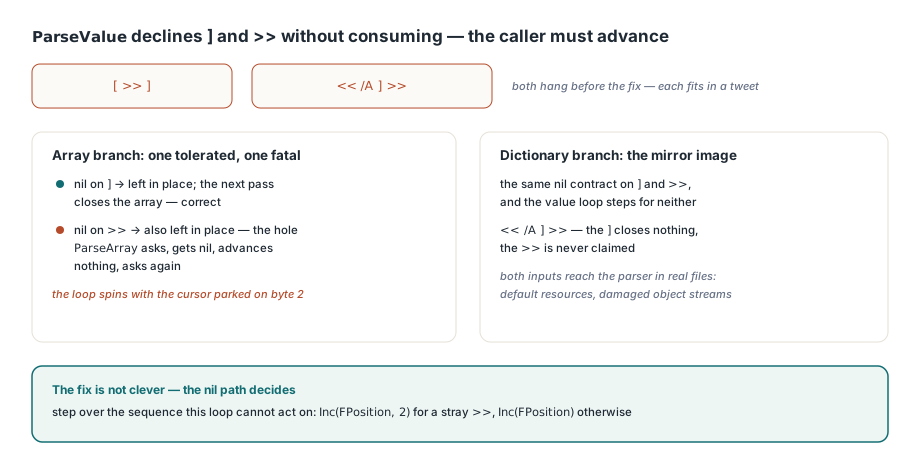
在 HPDFParser 中,方法 THPDFSpanObjectParser.ParseValue 一开始就直接拒绝两种字节序列。按 ISO 32000-1 第 7.3 节,值不能以 ] 或 >> 开头,因为它们是闭合容器而不是开启值,所以 ParseValue 对两者都返回 nil 且不消费它们。这是正确的契约,也把前进的全部责任推给了调用方。数组分支只兑现了一半:拿到 nil 结果时它检查 ],把它留在原地让下一轮闭合数组,然后跳过其他一切——只不过那个检查碰巧写成了让游离的 >> 也被留在原地。于是 [ >> ] 挂死,因为 ParseArray 要一个值、拿到 nil、什么都不前进、再要一次。字典分支有着镜像的漏洞,<< /A ] >> 以同样的方式挂死。两个输入都足以进入解析器,又短得能塞进一条推文
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // 修复前,下面这两个调用都不会返回
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
修复并不巧妙,而这正是要点:nil 路径必须明确决定当前循环能处理两条未消费序列中的哪一条,然后跳过另一条
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue 对 ']' 和 '>>' 都返回 nil,且不消费
  // 它们。']' 在下一轮结束数组,但多余的 '>>'
  // 数组内部的这种符号必须跳过去,否则解析永远无法前进
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;这里还有一件事值得注意。THPDFSpanObjectParser.RecordError 只递增 THPDFParserViewStatistics 里的 ErrorCount,它不封顶任何东西。解析器把 HPDFParserMaximumDepth 设为 64 来约束嵌套深度,却没有等价的错误数上限,而一个没人读的计数器就是错过的熔断器。即使前进被修复了,一个每字节产出一个错误的输入也会以值得提前退出而不是完整遍历的速度啃完一个大对象。每次解析后检查统计记录里的 Valid,把很大的 ErrorCount 当作停止信任该对象的理由,而不仅仅是诊断信息
CMap 分词器与 XFDF 读取器里同样的形状
HPDFCMapReader.NextToken 在它的 fallback 分支里带着一模一样的缺陷。函数返回一个 TCMapTok,用专用分支处理 <、( 和 /;其余一律落到"读到空白或分隔符为止"。当起始字节本身就是 ISO 32000-1 第 7.2.2 节集合里的分隔符时,这个循环跑零次,token 空手而归,调用方于是再要同一个 token。能落到这里的六个字符里,只有 [ 会被更早的 bfrange 处理截住,所以 ToUnicode CMap 里任何位置的游离 )、>、]、{ 或 } 都足以让文本提取停滞
// 关键字或数字:一直读到空白或分隔符为止
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// 上述分支都不认领的分隔符(多余的 ')'、'>'、
// '[', ']', '{' 或 '}') 会让 P 停在原地并返回一个
// 空关键字,调用方就会永远请求同一个 token
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
XFDF 那边有个变体,来源不同、效果相同。HPDFXFDFXml.ParseElement 在开头就 Result := P,此时 P 还指着开头的 <,之后才递增自己的局部光标,所以后面每一个提前退出都会返回入口位置,除非它先覆盖 Result。按 XML 1.0 第 2.8 节的 doctype 声明,或任何没有可解析标签名的东西(比如 <1a>),都会走一个从不更新 Result 的退出,子元素循环于是收到它传进去的位置。属性循环还有三处同样的问题,因为 ReadName、空白跳过和 = 处理全都拒绝一个既不是名字字符、也不是空白、也不属于 =、>、/ 的字节,而它们谁都没消费它。旁边的 CDATA 修复是在搬移责任而不是加守卫:按 XML 1.0 第 2.7 节,CDATA 段以 < 开头,所以子循环过去会把它交给 ParseElement,后者再从段内容里读出一个标签名。在子循环里用 IsCDATAStart 认出它、把字节拷进文本缓冲区直到 IsCDATAEnd,这才是正确的分工;而且旧跳过也短了一个字节,因为标记从 ! 数起是八个字节
声明计数比数据活得更久
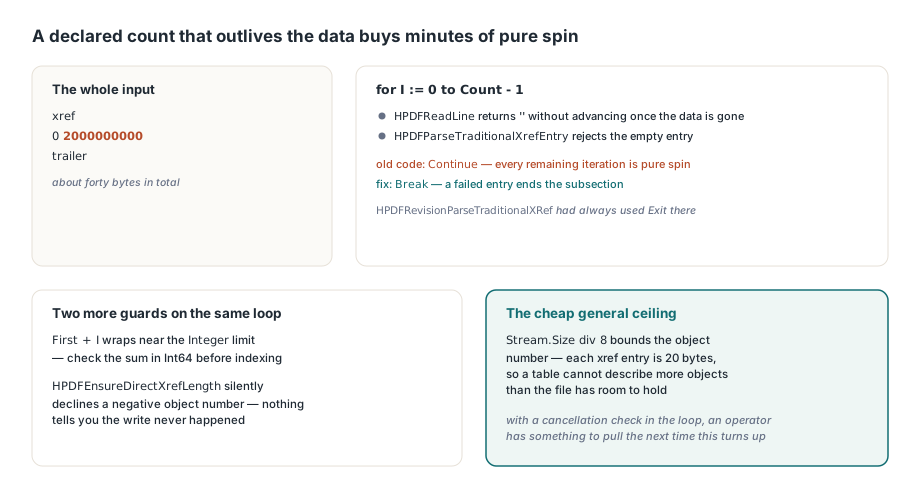
后来的一个版本从相反方向浮出了同样的模式,而这正是你自己的代码里最可能存在的变体。按 ISO 32000-1 第 7.5.4 节,交叉引用小节的节头是一个 first count 对,而 HotPDF 的两个 traditional-xref 解析器都用 for I := 0 to Count - 1 循环它,条目解析失败时用 Continue 而不是 Break。这读起来像是对一行坏数据的容忍。其实不是:HPDFReadLine 在数据耗尽后返回空字符串且不前进,HPDFParseTraditionalXrefEntry 会立即拒绝空条目,所以声明计数剩下的每一次迭代都是纯粹的空转。算术很不留情面——节头 xref\n0 2000000000\ntrailer 加上最小包装大约四十字节,就能让一个忙碌的核心转上几十秒,循环里没有任何取消检查。破绽就在同一个单元里躺着,因为 HPDFRevisionParseTraditionalXRef 在那个位置一直用的是 Exit。当两个函数解析同一套语法、却对"失败的条目是否结束小节"意见不一致时,其中一个就是停止接收修复的分叉,同样的特征也出现在混合交叉引用处理里——那里的传统表和 stream 描述着同一批对象
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // 若声明的计数大于表长,就会空转
  // 而此时已无数据可读
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First 来自子节头部,所以当声明的起始值
  // 接近 Integer 上限时,总和会回绕,增长辅助函数
  // silently refuses a negative index
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // …… 记录该条目 ……
end;
Break 后面的两个边界属于同一次修复。HPDFEnsureDirectXrefLength 拒绝为负对象号扩容数组,而且一声不吭;First + I 在声明的起始值接近 Integer 上限时会回绕,于是负索引会到达下面的写入。对象号上限 Stream.Size div 8 是廉价的通用答案——任何传统交叉引用表描述的对象都不可能多于文件能容纳的容量,任何声称更多的节头都是在描述一个不存在的文件。如果你在手工修复损坏的表,同样的推理从另一侧同样成立,这正是诊断与修复手工编辑的 PDF 笔记覆盖的领域
如何证明一个挂死修复真的有效?
靠运行旧代码,而不是重读它。停滞是少数几类可以用二值信号、无需任何插桩就能验证修复的缺陷——进程要么返回要么不返回;而推理控制流恰恰就是当初制造出这个 bug 的技能。机制值得照抄。把改动单元的修复前版本提取到 scratch 目录,然后编译一个小的 probe,让单元搜索路径把这个目录放在真实库之前:dcc32 -U<scratchdir>;<Lib> probe.dpr。编译器对先找到的源用旧代码,对其余一切用当前代码,所以单个 probe 二进制就能让旧解析器对着库的其余部分跑。在超时下运行它——四十秒绰绰有余——把退出码 124 当作断言。然后从 scratch 目录里逐个撤回单元并重新构建。三个停滞都这样复现了,每个都能归因到具体单元,修复后的源码回到路径里时三个也都能返回,成本是每个单元编译一次
动手前有两个坑值得知道。单元搜索路径是静默宽容的:从 shell 里给 -U 传一个 Unix 风格路径,比如 $PWD,编译器会一声不吭地忽略那个目录,这意味着你的 probe 是用当前源码编译的、因为错误的原因通过了。先把路径转成原生 Windows 形式。第二个坑是 scratch 目录不带 include 文件,所以你还得为 HotPDF.inc 加 -I<Lib>,否则构建会以"看起来像源码问题而不是路径问题"的方式失败。还要诚实面对这个方法给不了你的东西:它只确认某个具体输入在某个具体构建上不再挂死,对你没想到的那些输入什么也没说。零前进缺陷要靠 fuzzing 或通读每个分词器的每个分支来发现,而不是靠事后写的回归测试
你自己的解析器该审计什么
可复用的规则是一条契约,不是一个清单项。任何从共享光标读取的函数,必须在包括失败路径在内的每一条路径上,要么至少消费一个字节,要么返回一个调用方不会误认为是"再试一次"的值。把这两种含义塞进同一个 nil 或同一个空 token,正是把拒绝变成停滞的原因。所以要按形状审计,而不是按症状审计。找出每个终止条件依赖别的函数所拥有的光标的循环,问一问当那个函数拒绝当前字节时会发生什么。找出每个写成"读到 X 为止"的 fallback 分支,问一问当光标已经停在 X 上时它会做什么。找出每个由来自文件而非来自数据的计数约束的循环,让失败的条目结束循环而不是跳过一轮迭代。同一套语法在两处被解析的地方,把它们 diff 一下,因为其中一个可能收到了另一个没收到的修复。最后,在任何一个可能按调用方提供的迭代次数运行的循环里放一个取消检查,这样下一次这种问题在生产环境冒出来时,运维有东西可以拉
这里描述的解析器随当前版本的 HotPDF Delphi Component 一起交付,适用于 Delphi 和 C++Builder,统计记录与深度限制都已暴露,你可以在此基础上做自己的加固