HotPDF 可以把已加载的文档保存为一种便于人工阅读和编辑的诊断形式,并在你编辑完之后修复这个文件。SaveLoadedDocumentDiagnostic 会以确定的字典键顺序写出文档,每个对象都是普通的间接对象,没有对象流,没有交叉引用流,也不做线性化。随后 RepairDiagnosticDocument 会重建被你的编辑破坏掉的字节偏移量、流长度、交叉引用表和文件尾
这一对方法专为一种工作流而存在:搞清楚或修正一个 PDF 内部实际的样子。每个调试过渲染问题的开发者都曾想过打开文件、改一个字典里的一个数字、然后看看结果如何。在一份正常的 PDF 中这是不可能的,因为内容被压缩进对象流,而你插入的每一个字节都会移动交叉引用表精确记录的偏移量
诊断保存有什么不同?
六项设置会一起改变。字典键按确定顺序写出,因此同一文档的两次保存能产生可比较的文件。诊断输出模式会为结构添加注解。强制执行完整重写,因此没有任何内容会被当作未触动的增量修订保留下来。线性化被关闭,因为线性化文件是为网页查看器组织的,而不是为阅读者组织的。交叉引用流被关闭,因此该表是纯文本形式。对象流也被关闭,因此不会有任何对象被隐藏在压缩容器里
结果是一个文件头在常规 %PDF- 签名旁带有诊断标记的文件,其正文可以在任何编辑器中逐页翻阅。对象逐个排列,字典清晰可读,内容流也能一眼找到。修复工具会检查这个标记,并拒绝没有该标记的文件,因为一份正常 PDF 的紧凑结构,不是字节区间修复工具应该去尝试解读的东西

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // 可读格式,每个块一个对象,对象流中没有隐藏内容
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
为什么编辑会破坏文件,需要重建哪些内容?
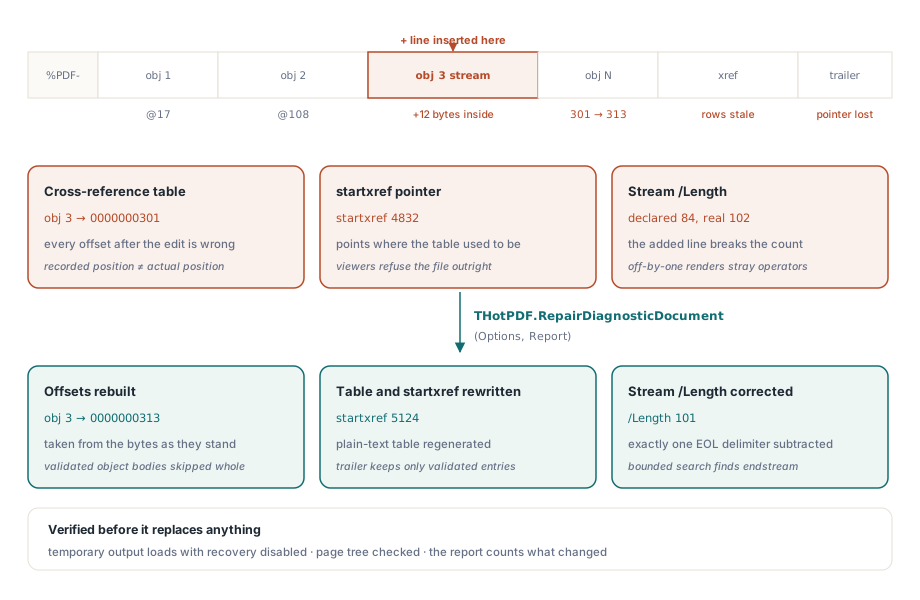
PDF 中有三处编码了字节位置或字节数。交叉引用表把每个对象编号映射到一个字节偏移量。文件末尾的 startxref 值指向该表。而每个流字典都带有一个 /Length,说明流主体占用了多少字节
只要在文件结尾之前的任意位置改动一个字符,之后的所有偏移量就都错了。往内容流里加一行,它的 /Length 也就错了。大多数查看器会直接拒绝这样的文件,而能恢复它的那些查看器,靠的是扫描,这只是掩盖了错误,而不是修正了错误。修复过程会根据字节现在实际的样子,重建这三处内容
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // 替换前先加载结果

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
复制字节,而不是重新序列化
让这个工具值得信赖的设计决策,是它从不把文档整个加载后再重新写出。它只复制那些已经通过校验的对象的字节区间,只改动那些确实错误的 /Length 值,并围绕它们重建交叉引用表、文件尾和 startxref
加载后再重新序列化会实现得容易得多,但也会悄悄改变一些东西。未知的对象语法会被规范化,字符串转义会被改写成写入器偏好的形式,已经编码过的流数据也可能被重新编码。对于一个调试工具来说,这是不可接受的:你只改了一个数字,diff 就应该只显示一个数字,而不是一千处无关的格式变动。如果你想知道两个文件之间到底发生了什么变化,那属于比较问题,见 按结构和像素比较两个 PDF 文件

防止误判对象的两条解析规则
字节区间扫描器面临一个明显的陷阱:看起来像对象头的文本,可能出现在流数据内部,也可能出现在字符串内部。一次朴素的扫描会生成一条指向内容流中间某处的交叉引用记录,而生成的文件会以一种新的、更令人困惑的方式损坏
HotPDF 通过跳过每个已校验对象的整个字节区间来避免这一点,做法是使用其记录的结束偏移量,因此对象主体内部的任何内容都不会被当作候选对象。在对象之间,只允许出现 PDF 空白符和注释;其他任何内容都意味着这段区域未被理解,其字节就绝不能被拉入输出
流长度同样需要小心处理。真正的负载长度不包括写入器在 endstream 之前插入的行尾分隔符。当声明的长度恰好落在该标记上时,这个声明会被接受。当它不吻合时,修复器会对 endstream 和 endobj 这一对标记做一次有界搜索,并精确减去一个分隔符——CR、LF 或 CRLF 之一。如果在这一步出现一个字节的误差,就会产生一个能打开、也能渲染出页面,但内容流末尾多出一个游离操作符的文件
文件尾允许保留什么
重建后的文件尾并不是旧文件尾的副本。/Size、/Prev 和 /XRefStm 都描述的是旧的文件布局,因此要么被重新计算,要么被丢弃。只有目标已经过校验的条目才会保留下来:/Info、/ID 和 /Encrypt。而 /Root 必须恰好解析到一个 Catalog 对象——不能是零个,也不能是多个,后者正是通过复制粘贴对象块拼凑出来的文件常见的产物
输出安全性的处理方式,符合一个作用于人们真正在意的文件之上的工具应有的样子。结果会先写入目标目录下的一个临时文件,然后通过关闭交叉引用恢复的正常路径加载它来验证,因此一个仅靠恢复机制才能打开的文件会被算作失败。只有在页面树通过验证之后,临时文件才会原子性地替换目标文件。一次失败的修复永远不会覆盖已有的输出
预算与诚实的失败代码
三项限制约束着这项工作:输入字节数、候选对象数量和最大对象编号,默认值分别为 8 GiB、两百万和两百万。对象编号上限比看起来更重要,因为一个只有几个对象、却编号到数十亿的稀疏表,否则会让重建后的交叉引用表膨胀得极其庞大。经典交叉引用表还会拒绝需要十位以上十进制数字才能表示的偏移量,这是格式本身的限制,而不是实现上的取舍
失败时报告的是一个具体的状态码,而不是一个布尔值:参数无效、源文件过大、不是诊断文件、超出对象数上限、对象无效、对象重复、缺少 Catalog、文件尾无效、输出错误,或校验失败。每一种都对应不同的修复方式。对象重复意味着你把某个对象块粘贴了两次。缺少 Catalog 通常意味着持有 /Type /Catalog 的那个对象被破坏了。校验失败意味着结构现在已经一致,但页面树无法加载,这通常是 /Kids 数组被编辑得与其 /Count 不同步所致
最后有两点实用建议。请保留诊断文件本身,而不只是修复后的文件,这样下一次编辑就能从一个可读的基础开始。并且不要把诊断输出发给终端用户:由于没有任何内容被压缩进对象流,它比正常保存的文件更大,面向生产环境的紧凑文件走的是 对象流与增量更新 中所述的常规保存路径。当目标是找出问题所在而不是修改它时,预检报告自动化 中的自动化路径比逐字节阅读更快得到答案
诊断保存、修复、预检和比较,都作用于 Delphi 与 C++Builder 中同一个已加载文档模型;完整功能列表见 HotPDF Delphi PDF 组件页面