一份裁掉封面页的带标签报告,打开时页数可以完全正确,却仍然在三处坏掉:「目录」书签点了没反应,无障碍检查器报告一个不属于任何页面的结构元素,严格的校验器则标出一条指向空闲对象的引用。页面树没有任何问题。ISO 32000-1 §7.7.3 只要求页面离开 /Kids 且 /Count 减一,而一份文件可以满足这一条,同时 catalog 里还有一半的指针继续指着那页已经消失的页面
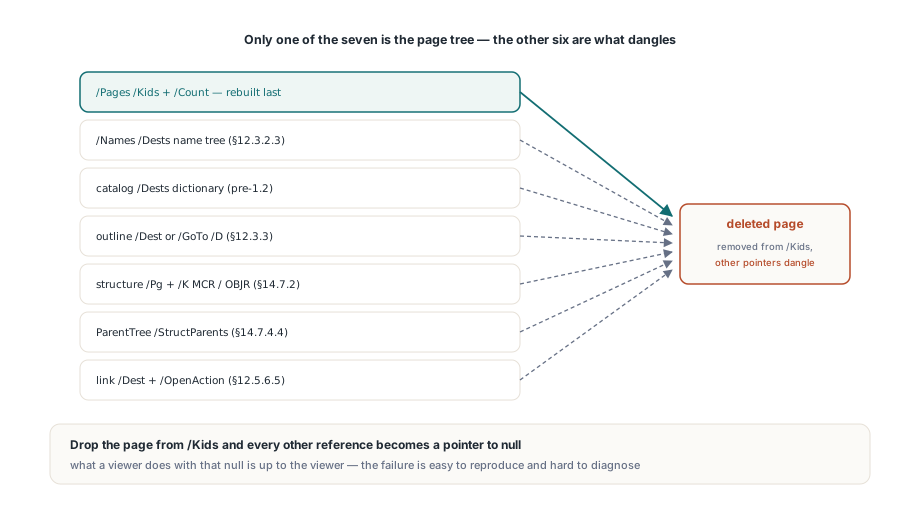
七种结构可以持有对同一页面的引用
七种里只有一种是页面树。其余的散布在 catalog、大纲、逻辑结构和其他页面的注释里,而一旦页面对象从文件中消失,它们每一条都会解析成 null。查看器拿这个 null 怎么办是它自己的选择,所以同一份裁过的文件在两个阅读器里的表现可以不一样
/Names/Dests下的名称树(§7.7.4、§12.3.2.3)把名字映射到以页面为首元素的目标数组- 1.2 之前就有的、直接挂在 catalog 里的
/Dests字典,按名字为键装着同一类数组 - 大纲项(§12.3.3)到达页面的途径,要么是内联的
/Dest,要么是带/S /GoTo和/D数组的/A动作 - 结构元素(§14.7.2)带一个
/Pg键,指明它们的标记内容住在哪一页上,而它们的/K子项可能是与那一页绑定的标记内容引用和对象引用(§14.7.4.3) ParentTree(§14.7.4.4)把页面和注释的/StructParents编号映射回结构元素,而一个元素可以只住在那里、完全不出现在从根开始的/K链上- 其他页面上的链接注释(§12.5.6.5)带一个指向该页的
/Dest或/GoTo动作,而 catalog 的/OpenAction也可能如此
在碰 /Kids 之前,THotPDF.DeletePage 做了什么
THotPDF.DeletePage(PageIndex) 在已加载的文档上先清扫上面列出的每一种结构,最后才重写页面树。索引是 0 基的。在任何改动发生之前有两道守卫:越界的索引抛出 Invalid page number,而要求删掉仅剩的最后一页同样抛异常,因为一个没有任何子项的 /Pages 节点描述的不是一份合法文档
清扫顺序是固定的:/Names /Dests 树、catalog 里遗留的 /Dests 字典、/OpenAction、大纲、/StructTreeRoot 连同它的 ParentTree,最后是每个留下来的页面的 /Annots 数组。只有在这之后,页面对象才被标记为已删除,它的 widget 注释才从 AcroForm 字段树上摘下,/Kids、/Count 和每个幸存页面的 /Parent 才被重写。表单这边,widget 被拿走后一个子项都不剩的父字段也会被移除,一路清理到 /Fields,所以裁过的表单不会留下任何屏幕背后空无一物的字段条目
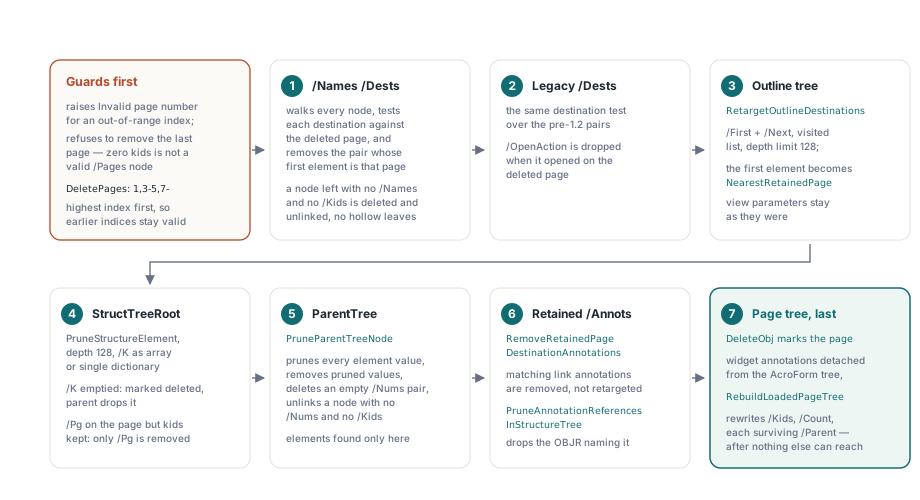
DeletePages 接受 1 基的区间字符串,比如 '1,3-5,7-'——这是其他已加载文档页面操作共用的记法——并从选中的最大页码往下删除。自顶向下走,页面在脚下不断消失,你写的编号却始终有效。覆盖全部页面的区间会抛异常,理由与 DeletePage 拒绝删最后一页相同;函数返回它删掉了多少页
var
  Pdf: THotPDF;
  Removed: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile 返回它加载的页数
    if Pdf.LoadFromFile('tagged-report.pdf') > 0 then
    begin
      // 0 基:页面 0 是封面
      Pdf.DeletePage(0);
      // 1 基区间,按文档当前的状态编号
      Removed := Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
名字消失,书签改指
指向被删页面的命名目标被移除,指向它的书签被改指。在 /Names /Dests 树里,每个节点都会被走访,每个目标都按规范允许的两种形式——裸数组和带 /D 键的字典——接受测试;数组首元素是被删页面时,这对名字与值就被移除。/Names 和 /Kids 都不剩的中间节点会从父节点上摘下来,所以树里不留空心叶子。catalog 里遗留的 /Dests 字典逐键跑同一套测试,而打开在被删页面上的 catalog /OpenAction 直接丢掉,打开时的视图交给查看器的默认行为
失去条目的节点同时也失去它的 /Limits 数组。新的最低和最高键不会重算,查看器没有它们照样解析名字。不过 §7.9.6 确实要求中间节点和叶子节点带 /Limits,所以如果你的流水线里有一个严格执行这条规则的预检步骤,把裁过的文件也在同一批任务里过一遍它
大纲沿 /First 和 /Next 遍历,带一个已访问列表和 128 的深度上限,所以损坏成环的 /Next 链挂不住这个调用。对每个指向被删页面的 /Dest 数组或 /GoTo 的 /D 数组,首元素被替换成它后面那一页;被删的是最后一页时,则替换成它前面那一页。页面引用之后的视图参数保持原样,于是一个 /XYZ 跳转保住它的 left、top 和 zoom 值,并把它们应用到新的页面上
这种不对称是有意为之。解析不到任何东西的名字合法且无害;GoTo 指向一个缺失的目标,结果只是什么都不发生。而目标为 null 的书签更糟:它还挂在侧边栏里,看起来能点,点了却失败。落到最近的幸存页面,是两种不完美结果里更好的那个。改指只覆盖显式目标数组。大纲项的 /Dest 若是一个名字字符串,它会通过名称树解析;清扫把那个名字移除之后,书签就哪儿也去不了了,所以重度使用命名书签的文档在删除之后值得检查一遍。下面的检查用 ResolveLoadedNamedDestination 读名字,它只看根节点的 /Names 数组:对扁平的名称树它给出有意义的答案,而在拆成 /Kids 的树上它对每个名字都返回 -1。大纲本身的结构,包括并不直观的 /Count 语义,见在已加载 PDF 上添加书签与命名目标的指南
// 检查结果,而不是想当然。
// Memo1 是你自己窗体上的一个 TMemo。
Pdf.DeletePage(0);
// ResolveLoadedNamedDestination 只读根 /Names 数组,
// 所以这个检查对扁平的名称树有意义;在一棵
// 用 /Kids 的树上,无论删没删,它对每个名字都返回 -1
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  Memo1.Lines.Add('"cover" is not resolvable from the root /Names array');
// 原本指向封面页的书签现在解析到它后面那一页,
// 也就是删除之后的 0 基索引 0
Memo1.Lines.Add(Format('Bookmark "Contents" -> page index %d',
  [Pdf.GetLoadedBookmarkPageIndex('Contents')]));
清理结构树和 ParentTree
只因被删页面而存在的结构元素被移除,跨多页的元素丢掉 /Pg 键但保留子项。遍历从 /StructTreeRoot 开始,沿 /K 下潜到 128 层,同时接受 §14.7.2 允许的 /K 数组形式和单字典形式。每个元素先清理子项,再评估元素本身:如果清理让它的 /K 空了,元素被移除,父节点把它丢掉。如果元素自己的 /Pg 指名被删页面,但它还有子项、还有 /P 父节点,那只移除 /Pg——元素上的 /Pg 只是那些没有自己页面的标记内容子项的默认页面,而这些子项完全可能住在其他页上。/Pg 是被删页面、下面又空无一物的元素被整体移除;/Pg 指名该页的标记内容引用字典同样适用最后这条规则
ParentTree 得到同样的处理,原因很容易漏掉:一个元素可能从 ParentTree 可达,其他任何地方都到不了它。这棵 number tree 把 /StructParents 整数映射到单个元素或元素数组。每个值都按上面的规则清理,被移除的值从数组里掉出去,数组变空的 /Nums 对被删除,/Nums 和 /Kids 都没有的节点被摘下来。跳过这一遍,这些孤儿就会继续通过 /Pg 指向一个已被释放的页面。对按标签顺序提取文本的人来说这很直接:按结构顺序提取文本走的正是这些树,而一个 /Pg 为 null 的元素就是一个从阅读顺序里掉出去的段落
为什么幸存页面上的链接是被移除而不是改指?
幸存页面上 /Dest 数组或 /GoTo 动作指向被删页面的链接注释,会从那一页的 /Annots 里移除,它的标签也随之而去。/Obj 指名该注释的 OBJR 字典从它的结构元素里拿掉;如果那个 OBJR 是元素唯一的子项,元素也被移除,ParentTree 再清理一遍。把 OBJR 留在原地会破坏 §14.7.4.3——那一条要求 /Obj 引用一个真实存在的对象——而 PDF/UA 检查器会看到一个对象引用无处可去的 Link 元素
书签改指,链接不移。正文里一句「见第 3 页」的交叉引用,在第 3 页消失之后就是错的,悄悄把它指向第 4 页只是把坏链接变成误导性链接。书签落到下一章是导航;正文链接是对内容的断言。移除是更安全的默认。如果你的工作流需要保住这些链接,请在调用 DeletePage 之前先改写它们的目标,因为调用之后它们已经不在 /Annots 数组里了
增量保存与直接子项的陷阱
在 BeginIncrementalUpdate 和 SaveIncrementalUpdate 之间,DeletePage 的行为完全一样。追加段里放着清扫改动的对象,加上对被移除、且拥有自己对象号的对象的空闲条目,比如页面本身和被删的链接注释。原始 %%EOF 之前的所有字节原样保留,§7.5.6 正是这么要求的
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
  // 丢掉直接 /MCR 子项的结构元素
  // 以重写后的形式、带着更短的 /K 数组进入追加段
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
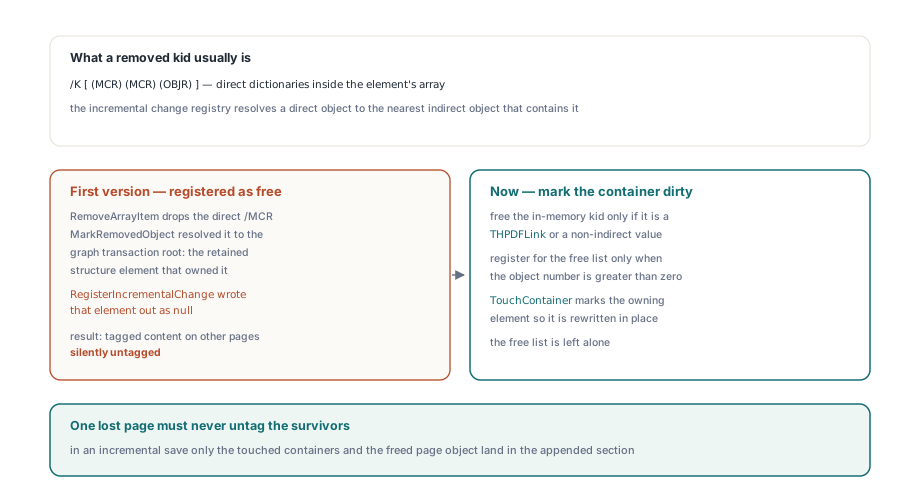
end;手写的清理器正是在这里出错。标记内容引用(/Type /MCR)和对象引用(/Type /OBJR)通常是待在父元素 /K 数组里的直接字典。直接对象没有对象号、也没有 xref 条目,所以它自己无法被释放。想当然的做法是把这些被移除的子项也「释放」掉,而任何把直接对象映射到容纳它的间接对象的写入器都会因此释放那个容纳者——也就是幸存的结构元素。这个元素被写成 null,从未被碰过的页面上的带标签内容就此失去标签。HotPDF 只在对象拥有自己的对象号时才把它送进空闲列表;对直接子项,它把容纳元素标记为已改动,于是元素带着子项消失后的形态被重写,空闲列表保持干净
同样的谨慎也决定了 DeletePage 在已加载文档上刻意不碰什么。被删页面的内容流、XObject 和非 widget 注释都作为对象保留,因为已加载的文件可能把它们中的任何一个与留下来的页面共享,而在删除时刻没有廉价的办法证明并非如此。拿掉页面树里的那条引用,对一份正确的文件来说就够了。这些遗留物还占着多少字节是另一个测量问题,对象依赖图与保留字节分析正是做这件事的工具
DeletePage 还是 DeleteLoadedPage?
用户要求的任何页面删除都调 DeletePage。THotPDF.DeleteLoadedPage(PageIndex) 是轻量变体:它执行同样的两道守卫,移动已加载页面列表,重写 /Kids 和 /Count,让渲染页面缓存失效,并触发 OnLoadedDocumentModified。它不碰名称树、大纲、结构树或其他页面的注释,也不把页面对象标记为已删除。ComposeLoadedPagesNUp 就是它适合的场合:它追加新拼好的版面页——把源页面画成 form XObject——然后用 DeleteLoadedPage(0) 丢掉每个原始页面,因为版面页引用的是页面的内容而不是页面对象。对一份带标签、带书签、交叉链接的文件执行「从这份合同里删掉第 7 页」,DeletePage 才是让每条引用保持一致的调用,无论你用 SaveLoadedDocument 保存还是用 SaveIncrementalUpdate 追加
这两个方法、基于区间的 DeletePages,以及上面用到的增量更新路径,都属于HotPDF Delphi Component——它让 Delphi 和 C++Builder 代码编辑已加载的 PDF,机器上不需要任何查看器运行时