一份 400 页的报告内嵌了一个 2 MB 的字体,若按"每页为它引用的一切买单"来算,会得出一个古怪的总数:各页加起来总共引用了 800 MB 的字体,而文件在磁盘上可能才 30 MB。改成把字体均摊到每一页,每页只摊到约 5 KB,于是什么都显得不贵,内存却像是凭空冒出来的。这两个数字都没有回答真正的问题:某个对象一旦消失,究竟能释放出多少字节
这个数字在堆分析里有名字,叫保留大小(retained size),而图论恰好有一套干净的办法来算它。每个对象都记到它的支配节点(dominator)账上——也就是从根出发通往它的每条路径都必须经过的最近对象。共享对象会一路上浮,直到抵达一个真正拥有它的节点,独占对象则原地记账,总和因此得以相加而不重复计数
HotPDF 中的浅层大小、保留大小与支配规则
HotPDF 通过 THotPDF.BuildLoadedObjectDependencyGraph 为已加载的文档完成这项计算。调用会为每个已加载的间接对象返回一个 THPDFObjectDependencyNode,为每个间接引用返回一条 THPDFObjectDependencyEdge,然后以文档 Catalog——即 trailer 的 /Root 条目指向的对象(ISO 32000-1 §7.7.2)——为根运行支配分析。每个节点带两个大小:EstimatedShallowBytes 是对象自身的开销,EstimatedRetainedBytes 则是自身开销加上它支配的所有对象的浅层开销
回到那个字体。每个页面都引用它,所以没有任何一个页面支配它;各条路径只在上方的页树节点汇合,在扁平树里就是根 /Pages 对象。字体的 2 MB 就记在那里,再向上卷入 Catalog。只在第 12 页绘制、别处都不出现的图像 XObject 正好相反:通往它的每条路径都经过第 12 页,所以第 12 页的保留大小包含整张图。保留列表的顶部,因此就是一份"移除即可释放内存"的对象清单
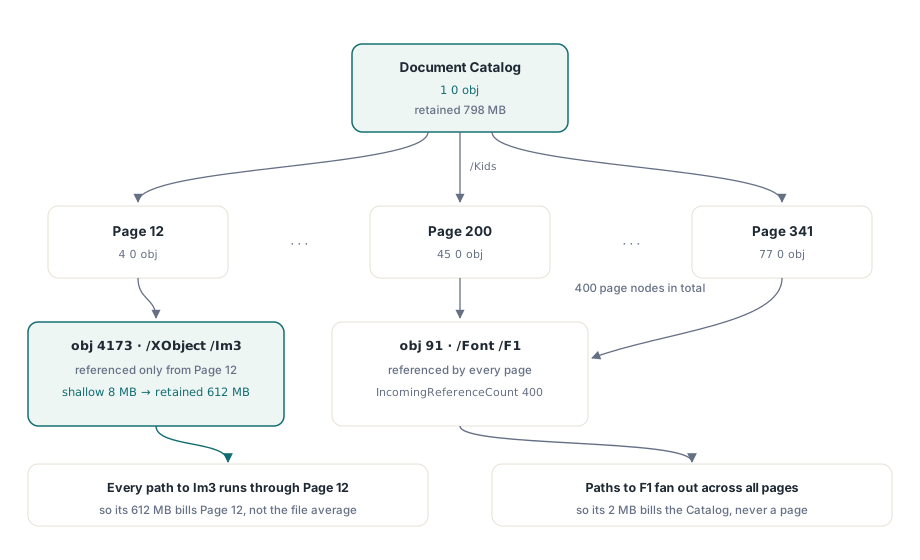
同一套算术还免费附赠一个交叉校验。THPDFObjectDependencyGraphInfo.CatalogRetainedBytes 等于所有从 Catalog 可达对象的浅层大小之和,而 TotalEstimatedBytes 是所有已加载对象(无论可达与否)的浅层大小之和。两者的差值,就是文档已经不再指向、却仍被占用的那部分内存
运行图分析并读懂失败结果
只有整个分析跑完,方法才返回 True,这个返回值就是你要检查的东西。返回 False 时 info 记录仍会被填充,但那两个数组已经不值得一用。对象数超过 MaxObjects(默认 250,000)时,方法在构建任何节点之前就停下,并把 ObjectCount 设为上限加一,于是你只知道上限设小了,不知道文档有多大。扫描途中触及边预算(默认 2,000,000)或直接对象 256 层嵌套上限时,返回的节点只有部分的浅层大小,保留大小和可达性则完全没有
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile 返回页数;0 表示加载失败
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // 为离线取证跑批调高上限
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Log 是你自己的日志例程
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // 不要对残缺的节点数组做排名或求和
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;
失败分支里还有两个标志值得看一眼。在已加载对象里找不到 Catalog 对象,或者某个直接对象竟然包含它自己(只会出现在畸形输入里)时,会置起 InvalidObjectGraph。LimitExceeded 还涵盖支配分析跑满 128 轮仍未收敛的情况。Diagnostic 会用一行话解释每种情形。给 MaxObjects 传零或负数、给 MaxEdges 传负数,则直接抛出 EArgumentOutOfRangeException,而不是返回 False
调用因上限而失败时,把数组扔掉,换更大的界限重跑。残缺的浅层大小在日志里看着头头是道,而它错的方式恰恰是把你引向完全不相干的对象。设上限是因为图本身有成本:每条边都存一个 Path 字符串,一次八百万条边的分析,要在被度量的文档之外再分配八百万个小字符串。它应该待在有人主动触发的诊断路径上
EstimatedShallowBytes 到底统计什么?
EstimatedShallowBytes 估算的是常驻内存,不是文件里的字节数。对每个对象,它累加已解析对象及其直接子对象的实例大小、字典和数组列表占用的槽位、每个键、名称和字符串的长度,以及流的载荷——前提是载荷在内存里:内存流,或者已读入内存的惰性加载流。字节还留在源文件里、或者已被挪到临时文件的流,只计入对象本身的开销
这带来一个实际影响。扫描型文件刚加载完就去画像,图像的保留大小可能很温和,因为还没人解码它们。在让进程内存涨起来的那一步(渲染、文本提取、合并)之后再跑图,具体化的流就会带着真实体重现身。想要一个可复现的检查,就对同一个文件画像两次:一次紧跟 LoadFromFile,一次在昂贵操作之后,然后对比排在前面条目
ObjectType 是粗粒度的。它报告的是 PDF 值类型,otStream、otDictionary 之类,所以图像、字体程序和页面内容流全都显示为 otStream。角色要看入边。THPDFObjectDependencyEdge.Path 记录引用在源对象里的位置,以 $ 开头,字典条目是 /Key,数组项是 [n],流的字典是 /dictionary。来自页面的 $/Resources/XObject/Im3,或来自独立资源字典的 $/XObject/Im3,说明这个对象被用作名为 Im3 的 XObject;来自字体描述符的 $/FontFile2 说明是嵌入的 TrueType 字体程序;$/Contents[0] 说明是页面内容
// 你自己的辅助例程,不是库的一部分:按保留大小给前 Count 个节点排名,
// 并为每个节点打印一条入边引用的路径
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;
对大多数对象来说,一条入边路径就足以完成分类。共享对象用 IncomingReferenceCount 看引用有几条,支配分析之后归谁所有则看 ImmediateDominatorObjectNumber 及其世代号。Catalog 本身以及所有 Catalog 到达不了的对象,这个字段是 -1。Resolved 标志为 False 的边指向一个未加载的对象号;它们被计入 UnresolvedReferenceCount,其他方面完好的文件上这个计数居高,通常说明交叉引用区已经受损
不可达对象从哪来?
ReachableFromCatalog 为 False 的节点已经加载、确实占内存,但从 Catalog 出发没有任何引用链能到它,文档结构里也没有什么能引导阅读器找到它。它的保留大小等于浅层大小,因为支配分析只在可达对象上运行。因此把不可达节点的 EstimatedRetainedBytes 加总,会得到与 TotalEstimatedBytes - CatalogRetainedBytes 相同的答案
增量更新是常见来源,但不是人们常以为的那种方式。后续修订重定义对象 2120 时,最新的交叉引用条目获胜,旧定义根本不会被加载,所以同一对象号的被取代副本不会出现在图里。真正会出现的,是后续修订干脆不再引用的对象:从重写的 /Annots 数组里删掉的批注、被新对象号顶替的图像、从 AcroForm 里移除的表单字段。ISO 32000-1 §7.5.6 没有任何条款要求更新把这些条目标记为空闲,只要交叉引用数据仍把它们列为在用,加载器就把它们当作活对象对待。那篇讲对象流与增量更新的文章介绍了修订如何叠加
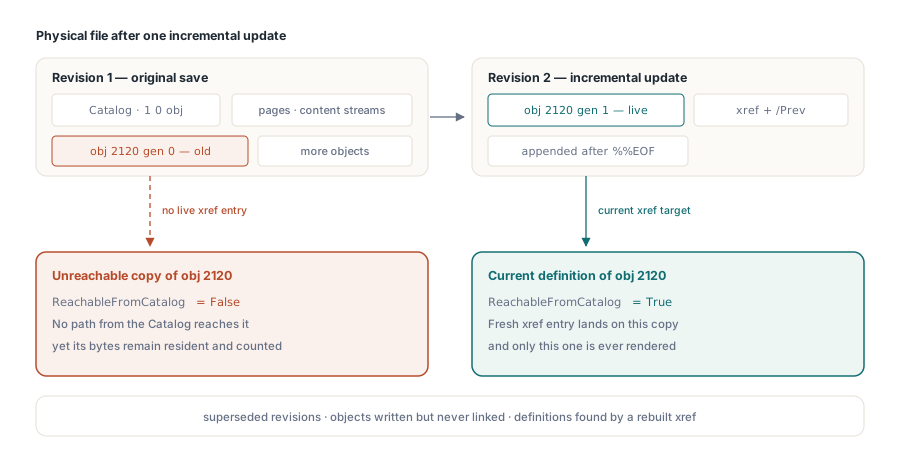
另外两个来源是写了对象却没能链接起来的生成器,以及交叉引用数据只能靠扫描重建的受损文件——后者可能捡回一些无人引用的对象定义。当估计总量里有大块落在不可达节点上时,把文件干净地重写一遍胜过再追加一个修订版本,图会给你所需的字节数,去说服别人接受较慢的保存
占着内存的会不会是解析器?
先别急着怪文档,看看加载过程本身表现如何。有两个调用描述的是解析器而非内容,而且两者都会在每次 LoadFromFile 或 LoadFromStream 开始时复位,所以它们描述的永远是最近一次加载
GetLastParserArenaStatistics 填充一个 THPDFParserArenaStatistics 记录,对应解析期间存放短命记号和缓冲区的块竞技场(block arena)。块大小为 64 KiB(BlockSize),超过一个块的分配会得到一块按自身大小专设的内存。AllocationCount 减 ReusedAllocationCount 等于 BlockAllocationCount,即竞技场不得不向内存管理器要新块的次数。块在 THotPDF 实例的整个生命周期内保留,实例销毁时释放。如果一个实例处理整批文件,RetainedBytes 大致反映该批文件里最大工作集的需求,这解释了组件释放之前内存高原一直不退的现象。TemporaryObjectElisionCount 统计直接读入竞技场、而不是先建临时 name 对象的字典键
GetDocumentStringInternStatistics 描述每个文档的驻留池(intern pool),负责去重 PDF 名称、内容流操作符和短字符串。1 到 64 字节的字符串符合入池条件。池最多容纳 65,536 个条目和 4 MiB,这些上限会以 MaxStringLength、MaxEntryCount 和 MaxRetainedBytes 的形式随记录返回。空字符串、超过 64 字节的字符串、或池满时新来的字符串,都计入 BypassCount 并作为普通字符串保留。因此,一个生成海量唯一名称的文件,成本与没有这个池时大致相当,不会更糟
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // 你自己的检查,不是库调用:标记已触及上限的驻留池
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;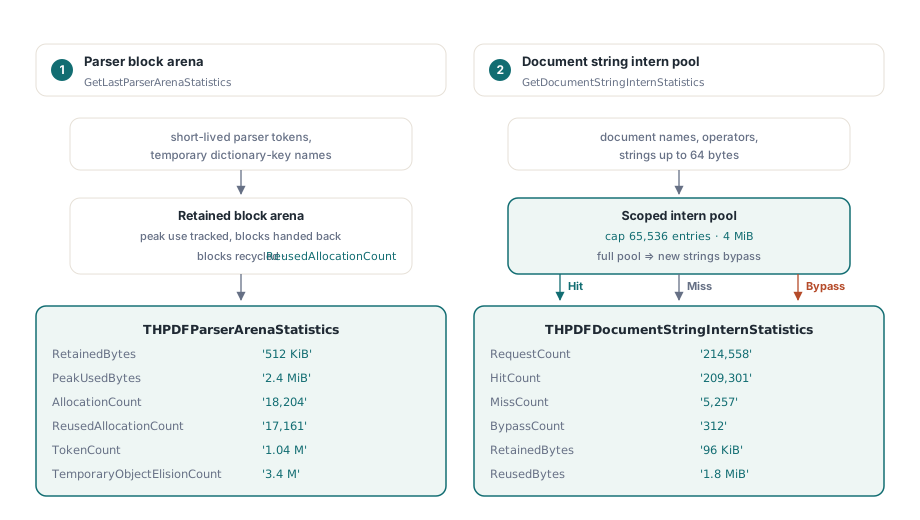
典型的 PDF 会重复使用一小撮名称和操作符,所以 HitCount 紧贴 RequestCount,ReusedBytes 随页数增长。一个不大的文件上 BypassCount 却逼近 RequestCount,就不正常了。在不可信上传的入口路径上,把它记进日志
内存投诉的排查顺序
先看 CatalogRetainedBytes。如果它接近你测到的进程增长,内存就在文档里,保留列表的头部会点名。如果远低于此,内存就在图够不着的地方——你自己的缓存、渲染出的位图或解析器竞技场——接下来该读的就是竞技场记录
- 按
EstimatedRetainedBytes给节点排名,读出前十名的入边Path。排在前面的 XObject 目标通常指向扫描型内容,降采样有回报;/FontFile、/FontFile2或/FontFile3目标说明嵌入了完整字体程序,其实子集就够用;大的/Contents流多半来自生成的矢量输出,比如地图或 CAD 导出 - 用
TotalEstimatedBytes减去CatalogRetainedBytes。差值大说明存在被搁浅的对象,修法落在保存环节 - 最后读竞技场和驻留池记录。它们很少能解释几个 GB 的量级,但能解释为什么每个文档都关掉了、进程还是降不下来
按这个顺序来。第一步就能了结大多数投诉,而对特别大的文档,结构性答案往往是别把整个对象图都攥在手里——直接文件 API 工作流正是为此而生
这三项诊断都是返回普通记录的普通方法调用,可以径直接进 Delphi 或 C++Builder 应用已有的日志或遥测管道。HotPDF 以带完整源码的原生 VCL 组件交付;文档和试用版下载在HotPDF Delphi PDF 组件页