一张从 PDF 里出来颜色发闷、偏色或反相的 CMYK JPEG,几乎总是意味着解码器搞错了两件事中的一件:样本是按 YCCK 存的需要转换,还是按 Adobe 约定反转存了。HotPDF 的解码器对三通道和四通道图像遵守 DCTDecode 的 /ColorTransform 参数,拒绝规范未定义的取值,并按 ISO 32000-1 Table 13 的要求,让 JPEG 数据内的 Adobe APP14 标记优先于该字典条目。同一族陷阱还有两条相邻规则:多 filter 流必须带按阶段对齐的 /DecodeParms 数组,JPEG 2000 图像保留显式 /Decode 映射
这三条共享同一个主题:PDF 已经把意思写清楚了,坑在于渲染器回答了一个稍有不同的问题
为什么 CMYK JPEG 在 PDF 里会反相或发灰?
CMYK JPEG 在 PDF 里出问题无非两种原因,屏幕上的样子也不同。负片样的图像——白纸变黑、浅色调变深——指向反转存储。发灰或偏色的图像——皮肤发绿、黑色发灰而 K 通道细节依然锐利——指向颜色转换在该做时被跳过、不该做时被做了
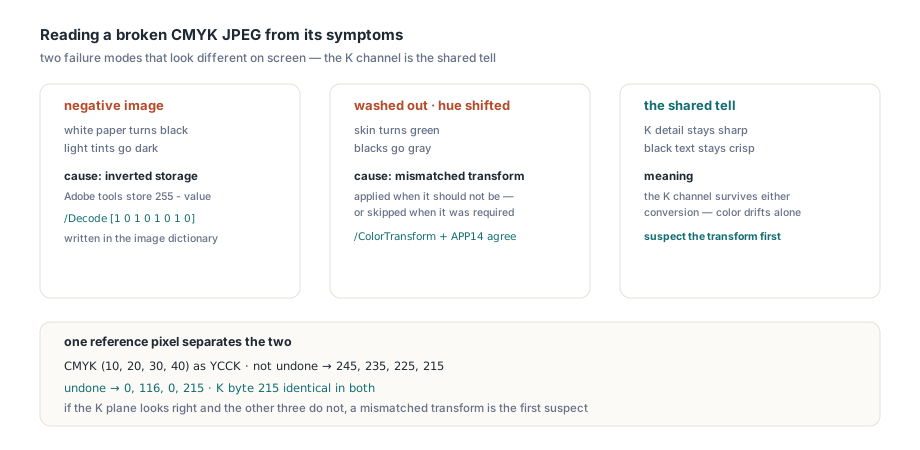
转换问题源自 JPEG 压缩颜色的方式。亮度与色度分离时 baseline JPEG 压缩效果最好,所以编码器通常先做 RGB 到 YCbCr 的转换;四通道编码器把 CMY 转成 YCC、让 K 原样通过,这就是 YCCK 格式。解码器必须精确撤销编码器做过的那次转换。撤销一场从未发生的转换,或跳过一场确实发生的,每个像素都会跑偏。黑色通道无论如何都活着——这就是为什么坏掉的 CMYK 图像常常黑色文字依然锐利,其他一切都在漂
反转问题是历史遗留。Photoshop 和其他 Adobe 工具写 CMYK JPEG 时把每个样本存成 255 - value,并用 Adobe APP14 标记给文件做记号。JPEG 标准里没有任何这样的规定;这是约定,每个消费方都得知道。在 PDF 里,反转应由生产者在图像字典里明确表达,而不是留给人猜
/ColorTransform 告诉解码器什么?
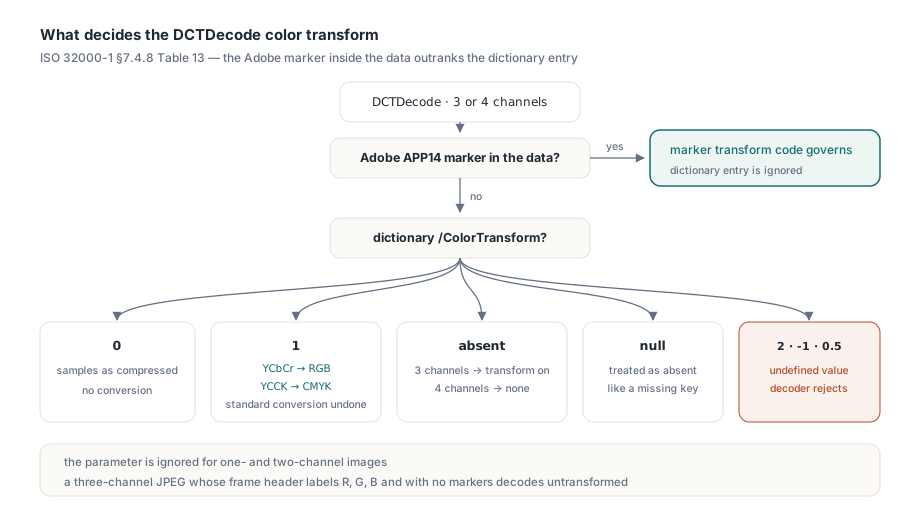
/ColorTransform 是 PDF 层面对“解码器必须撤销哪次转换”的声明。ISO 32000-1 §7.4.8 的 Table 13 定义了两个值:零表示不转换,解码器按压缩原样返回样本;一表示编码器做过标准转换,三通道图像从 YCbCr 回到 RGB,四通道图像从 YCCK 回到 CMYK。单通道和双通道图像忽略该参数。Table 13 还定了一条容易漏掉的优先级规则:编码数据带有自带 transform 代码的 Adobe 标记时,以标记为准,字典条目被忽略。只有不带该标记的 JPEG 才回退到字典;条目也缺省时,三通道图像默认做转换,四通道图像默认不做
最容易犯的错,是图像路径收下了参数字典却从不把它交给 JPEG 解码器。一个存着颜色 (128, 63, 31) 的单像素 RGB JPEG 会让它当场现形:这种解码器对 /ColorTransform 0 和 /ColorTransform 1 都返回 [128, 63, 31],而零的正确答案应是原始 YCbCr 三元组 [79, 101, 163]
HotPDF 在字节层面落实这个参数。HPDFDecodeHeadlessTerminalImage 先沿 JPEG 段结构走到 start-of-scan 标记,寻找 Adobe APP14 段;comment 段里那些只是长得像的字节不算数。数据带标记时,以它的 transform 代码为准,字典值被忽略。不带时,解码器构造一份 JPEG 私有副本,在 start-of-scan 标记前插入一个 APP14 段,携带 transform 代码 0、1,或者对取值为 1 的四通道图像,插入 YCCK 代码 2。只要三通道图像的有效 transform 是 0,副本还会解除 JFIF 头的武装,因为单凭 JFIF 头会让 libjpeg-turbo 假定 YCbCr。调用方的缓冲区绝不被触碰;插入段时,多出的 16 字节会在解码器分配任何东西之前先计入工作字节预算
只在无标记时插入,这一点很重要,原因在 libjpeg 的一个细节:它采用看到的最后一个 APP14 段。若把段插在既有标记之后,显式字典值就会悄悄压过数据里与之冲突的标记——这恰好与 Table 13 相反。HotPDF 在完整 image XObject 路径和 inline image 路径上都执行 Table 13 的顺序
某张图像看着不对、又不想渲染整页就想看它的样本时,可以直接调用同一个终端解码器。函数在 HPDFHeadlessImageCodecs 单元里,参数是 filter 名称、编码字节、可选参数字典,以及来自图像字典的几何信息——它必须与 JPEG 帧头一致
uses
  SysUtils, HPDFObjs, HPDFHeadlessImageCodecs;

// ColorTransform < 0 表示“条目缺省”:让 JPEG 标记说了算
function DecodeDCT(const Encoded: TBytes; Width, Height, Channels,
  ColorTransform: Integer): TBytes;
var
  Parms: THPDFDictionaryObject;
begin
  Parms := nil;
  if ColorTransform >= 0 then
  begin
    Parms := THPDFDictionaryObject.Create(nil);
    Parms.AddNumericValue('ColorTransform', ColorTransform);
  end;
  try
    Result := HPDFDecodeHeadlessTerminalImage('DCTDecode', Encoded, nil, Parms,
      Width, Height, Channels, 8, 64 * 1024 * 1024, nil);
  finally
    Parms.Free;
  end;
end;
解码器对什么算合法取值很严格。显式 -1、2,或 0.5 这类非整数,都会抛 EHPDFHeadlessImageError 而不是回退到默认值,因为规范没定义的值给不了解码器任何可信的行事依据。即使数据里的 Adobe 标记让该条目变得无关紧要,检查依然保留,因为未定义的值本身就是文档的结构性错误。预算小到装不下转换副本时同样失败,错误信息会点名工作字节预算
显式 null 是另一回事,因为它根本不是值。ISO 32000-1 §7.3.9 规定取值为 null 的字典条目等价于条目缺席,所以 /ColorTransform null 直接落到标记或分量数默认值上,与键不存在毫无区别。HotPDF 在所有路径上都这么处理,headless 与 VCL、流与 inline 一视同仁
还有一个默认值值得一提,因为这是 HotPDF 刻意超出 Table 13 字面规定的地方。一个既无 JFIF 头也无 Adobe 标记的三分量 JPEG,若帧头把分量标成 R、G、B,它自己的字节就在说:我装的是 RGB。按 Table 13 它仍默认做转换,但 libjpeg 和建立在其上的阅读器都不做转换地解码它,HotPDF 也一样。headless 与 VCL 解码器都这么对待它,红和蓝留在数据放的地方。显式字典值 0 或 1 仍然可以推翻这个推断
uses
  System.IOUtils;

var
  Jpeg, Stored, Converted, ByMarkers: TBytes;
begin
  // 从 PDF 流里取出的 640 x 480 CMYK 图像原始 DCTDecode 字节
  Jpeg := TFile.ReadAllBytes('suspect-image.jpg');
  try
    // 若数据里带 Adobe APP14 标记,三个调用结果一致:
    // 标记说了算,字典值被忽略
    Stored    := DecodeDCT(Jpeg, 640, 480, 4, 0);   // 无标记:样本保持压缩原样
    Converted := DecodeDCT(Jpeg, 640, 480, 4, 1);   // 无标记:YCCK 还原成 CMYK
    ByMarkers := DecodeDCT(Jpeg, 640, 480, 4, -1);  // 无标记:四通道默认,不做转换
    Writeln(Format('pixel 0: stored %d,%d,%d,%d  converted %d,%d,%d,%d',
      [Stored[0], Stored[1], Stored[2], Stored[3],
       Converted[0], Converted[1], Converted[2], Converted[3]]));
  except
    on E: EHPDFHeadlessImageError do
      Writeln('Decoder refused the image: ', E.Message);
  end;
end;
一个四通道参考像素能说明该看什么。存成 YCCK 的 CMYK 像素 (10, 20, 30, 40),在 YCCK 转换未被撤销时返回 [245, 235, 225, 215],被撤销时返回 [0, 116, 0, 215]。K 字节 215 在两边完全一致。如果 K 平面看着对、其他三个不对,第一个嫌疑就是转换不匹配
反转 CMYK 约定归 /Decode 管
HotPDF 终端解码器返回的 CMYK 样本与 libjpeg-turbo 产出的完全一致,不会凭一个 Adobe 标记就翻转它们。上面的数字把这个约定摆得很清楚:245、235、225、215 就是 255 减 10、20、30、40,Adobe 系编码器存的就是这种反转形态。把它变回油墨量是图像字典的职责——嵌入这类 JPEG 的生产者应写上 /Decode [1 0 1 0 1 0 1 0]。渲染器把 /Decode 数组作用到每个分量,写得正确的文件印出来就是对的
另一面也得明说:嵌入了 Adobe 反转 CMYK JPEG 却没配对应 /Decode 数组的 PDF,在 HotPDF 里就渲染成负片,因为文件本身就是这么描述这幅图像的。一些阅读器会探测 APP14 标记并悄悄补偿。HotPDF 不加这种启发式,这类文件的修法在生成它的软件里
为什么两个 filter 共用一个 DecodeParms 字典是错误?
/Filter 为多阶段数组的流,必须提供等长的 /DecodeParms 数组,每阶段一个参数字典或 null。ISO 32000-1 §7.3.8.2 的 Table 5 写明了这条规则,HotPDF 强制执行:提供单个共享字典的多 filter 流会被报告为无效文档,而不是被解码
宽容的做法比看起来更糟。只在 /DecodeParms 已经是数组时才检查长度的解码器,面对单个字典加两个 filter,会悄悄在每一阶段复用这个字典。字典为空时无害,不为空时是破坏性的:给内层 Flate 阶段准备的 /Predictor 12 也会被套到外层上,输出变成看起来像模像样的垃圾,而不是干脆的报错。由于这类文件的意图已无法还原,HotPDF 直接拒绝,连空字典的情形也不放过——比如带 /Filter [/FlateDecode /FlateDecode] 和 /DecodeParms << >> 的页面内容流
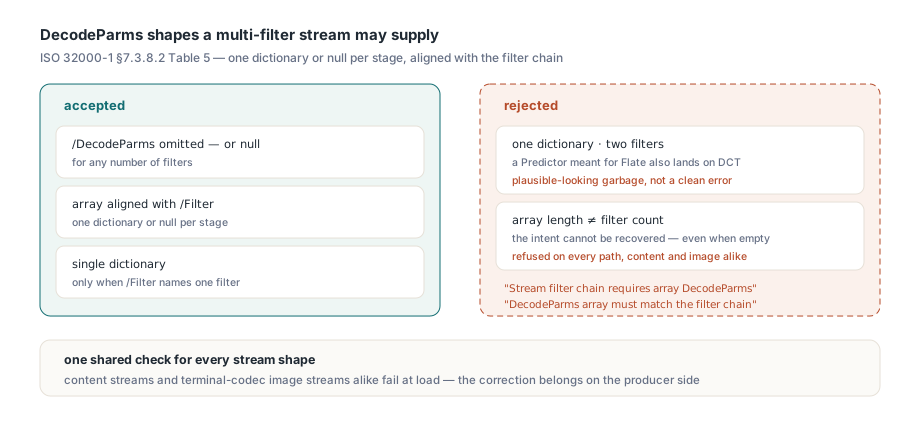
接受与拒绝的形态很容易列举:
- 接受:
/DecodeParms缺省,或为null,filter 数量不限 - 接受:长度等于 filter 数的数组,每项为字典或
null - 接受:
/Filter恰好只写一个 filter 时的单个字典 - 拒绝:被两个及以上 filter 共享的单个字典,诊断信息为 “Stream filter chain requires array DecodeParms”
- 拒绝:长度与 filter 数不符的数组,诊断信息为 “DecodeParms array must match the filter chain”
同样的检查也用于普通内容流,以及最后一个 filter 是 DCTDecode 这类终端编解码器的图像流,所以无论流里装的是什么,畸形链都在同一处失败。与解压预算的交互在 filter 链预算与 PDF 解码炸弹一文里。从应用代码看,错误在页面渲染时浮出
uses
  SysUtils, HPDFHeadlessDocument, HPDFHeadlessCairoDevice;

var
  Document: THPDFHeadlessDocument;
  Options: THPDFHeadlessRenderOptions;
  Info: THPDFHeadlessRenderResult;
begin
  Document := THPDFHeadlessDocument.Create;
  try
    try
      Document.LoadFromFile('catalog-cmyk.pdf');
      Options := THPDFHeadlessRenderOptions.Default;
      Info := HPDFRenderHeadlessPagePNGFile(Document.GetRenderAccess(0),
        'page1.png', Options);
      Writeln('images=', Info.Images, ' decoded bytes=', Info.DecodedBytes);
    except
      on E: Exception do
        Writeln('Rejected: ', E.ClassName, ': ', E.Message);
    end;
  finally
    Document.Free;
  end;
end;
JPEG 2000 图像保留显式 /Decode
只有当字典没有 /ColorSpace 且它不是图像掩膜时,JPEG 2000 图像才忽略 /Decode。ISO 32000-1 §8.9.5 把这一点写成了条件,HotPDF 照做。对每个非 stencil JPX 图像一律丢掉 /Decode 是省事的捷径,但它会让显式反转凭空消失:/Decode [1 0] 之下取值 64 的 DeviceGray JPX 样本必须渲染成 191,而不是 64
只把这一个条件做对还不够。Lab 和 ICCBased 这类只要图像是 JPX 就设置默认分量范围的颜色空间分支,会把一次合法生效的数组再覆盖一遍,所以渲染器会记录有效 /Decode 数组是否真的生效过,只在没生效时才填默认范围。显式的 Lab 和 ICCBased 范围因此得以存活;字典沉默时,仍由码流自身的颜色声明说了算。该格式的解码一侧见 JPEG 2000 与 JPXDecode 一文
哪些解码路径遵守这些规则?
两条管线都遵守。headless 一侧指 THPDFHeadlessDocument 加载、共享流解码器,以及 HPDFRenderHeadlessPagePNGFile 背后基于 Cairo 的页面渲染器。VCL 一侧指已加载图像提取到 TBitmap 和 VCL 页面渲染,整图与区域缩略解码同样按 Table 13 顺序执行,所以 JFIF 头无法在 Adobe transform 为 0 时强行套上 YCbCr,非法取值也会让图像在那里变得不可解码。Inline DCT 图像遵循与 image XObject 相同的标记、null、默认值和拒绝规则,缩写与全名键一视同仁,包括 /DP << … >> 字典和 /F [/AHx /DCT] 这类缩写 filter 数组;参数非法的 inline 图像被跳过,页面其余部分照常渲染。从已加载 PDF 提取图像指南覆盖了该 API 其余的 filter 处理
把行为当作依赖之前,几条实用备注:
- JPEG 解码在运行时需要一个兼容的 TurboJPEG 库;
HOTPDF_TURBOJPEG_LIBRARY可覆盖默认的turbojpeg.dll或libturbojpeg.so.0 - 严格的结构检查会拒绝宽松阅读器能打开的文件,最典型的就是共享的空
/DecodeParms字典;这类文件要修得改生产者一侧
对色彩受管理的印刷工作流,实用结论很短:写 CMYK JPEG 时带上与数据内任何 Adobe 标记一致的显式 /ColorTransform,配上与其存储方式匹配的 /Decode 数组;给每个多 filter 流配按阶段对齐的 /DecodeParms 数组;然后放心让 HotPDF 按文件自己说的话来要求它
本文展示的 headless 加载器、流解码器和 Cairo 页面渲染器随 HotPDF Delphi PDF component(面向 Delphi、C++Builder 与 Lazarus)提供,经典的 VCL 文档引擎也在其中