HotPDF 嵌入带 CFF2 轮廓的 OpenType 可变字体的方式,是在选定轴值处把它转换成 PDF 阅读器早已理解的 CID 编码 CFF1 字体程序。通过 RegisterUnicodeTTF 注册的普通原生文本使用字体自己的 cmap 和 hmtx 表,写入器把转换后的程序放在 /FontFile3 下并标 /Subtype /CIDFontType0C,让每个 CID 都等于原始 glyph ID
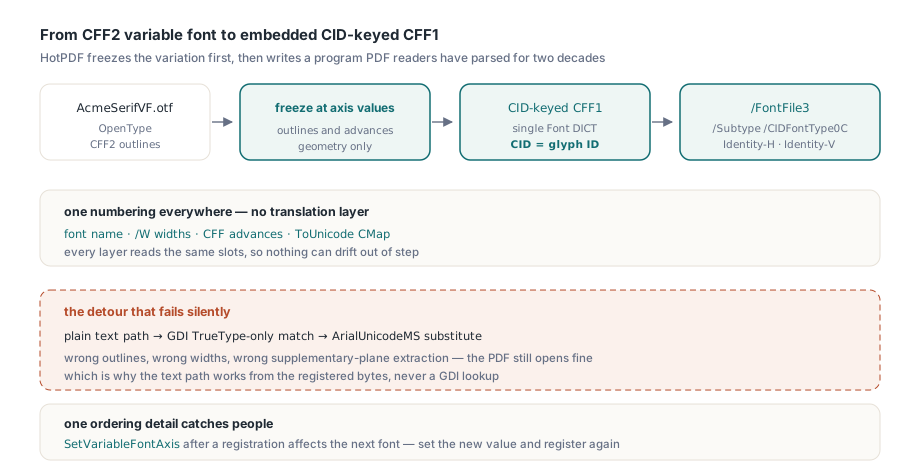
那条显而易见的路线值得描述一下,因为它失败时不声不响。解析并缓存 CFF2 表,然后让纯文本路径经 Windows GDI 解析字体,且只按 TrueType 匹配:GDI 根本不知道拿 CFF2 轮廓怎么办,会悄悄替换成 ArialUnicodeMS。下游任何读到替换字体的地方都会拿到错误的轮廓、错误的宽度,补充平面字符的提取也是错的。PDF 能正常打开,只是排版用的不是你要的那款字体——所以文本路径必须基于注册的字节,而不是 GDI 查询
PDF 为什么不能直接嵌入 CFF2 字体?
PDF 没有给 CFF2 程序留位置。ISO 32000-2 §9.9 列出了阅读器必须处理的内嵌字体程序类型:/FontFile 下的 Type 1,/FontFile2 下的 TrueType,以及 /FontFile3 下的裸 CFF 程序(Type1C 或 CIDFontType0C)或包裹 TrueType / CFF 轮廓的 OpenType。这张清单里的每种 CFF 都指 CFF 版本 1——阅读器解析了二十年的格式
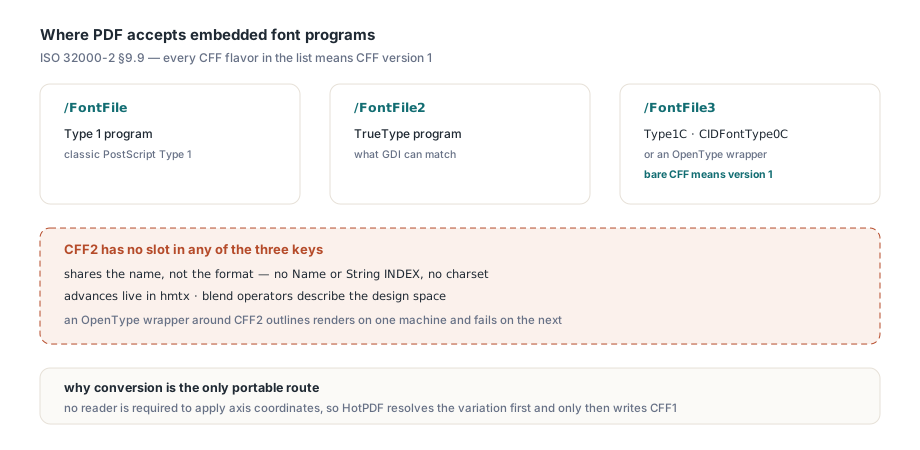
CFF2 是一种碰巧同名的不同格式。它去掉了 Name 和 String INDEX,去掉了 charset,把 glyph advance 从 CharStrings 里挪出去交给 hmtx,并加入 blend 算子,让单个轮廓能描述整个设计空间。CFF1 解析器遇到 CFF2 表没有任何猜测依据,PDF 规范也没有任何条款要求它去尝试。把 CFF2 字体包进 OpenType 流然后听天由命,正是那种在这台机器上渲染正常、到下一台就失败的东西,所以 HotPDF 不这么干
转换还必须是静态的。正如 可变字体静态实例化一文所解释的,PDF 字体是一组轮廓和度量都固定的东西,没有任何阅读器被要求应用轴坐标。所以 HotPDF 先解析变化,然后才写 CFF1
用 CFF2 字体写原生文本
对应用代码来说,CFF2 字体的行为与其他任何已注册的 Unicode 字体一样:选轴值、注册文件、按名称选家族、绘制。RegisterUnicodeTTF 单独保留一份原始 name 表副本,所以 SetFont 能按家族名、全名、PostScript 名或排版家族名匹配,并选中冻结下来的静态字体字节,全程不涉及 Windows 安装或 GDI 查询
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'brochure.pdf';
    Pdf.BeginDoc;
    // 轴值只影响这次调用之后注册的字体
    Pdf.SetVariableFontAxis('wght', 650);
    Pdf.RegisterUnicodeTTF('C:\Fonts\AcmeSerifVF.otf');
    // name 表里的家族名、全名、PostScript 名或排版家族名
    Pdf.CurrentPage.SetFont('Acme Serif VF', [], 12, DEFAULT_CHARSET);
    Pdf.CurrentPage.UnicodeTextOut(72, 100, 0, 'Variable weight 650, CFF2 outlines');
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
glyph ID 来自注册的 cmap,advance 来自注册的 hmtx。advance 真的为零的 glyph 保持为零,不会回退到 GDI 测量;UTF-16 代理对精确产出一个 advance,而不是两个。BMP 字符、补充平面字符和合成的 shaping 载体都保留按字体隔离的 Unicode 映射,切换到另一个内嵌字体或开新页面时,那个字体既不会更新这个字体的子集状态,也借不走它的 glyph ID
测量同样基于这批字节。THPDFPage.GetWideTextWidth 和 THPDFPage.GetWideCharAdvances 读取所选字节字体自己的度量,断行和右对齐与实际绘制一致。一个顺序细节容易坑人:注册之后再改 SetVariableFontAxis,影响的是你下一个注册的字体,而不是已经冻结的实例。想要第二个字重,设好新值再注册一次
HPDFConvertCFF2ToCFF 如何构建 CID 编码程序?
HPDFConvertCFF2ToCFF 产出一个带单一 Font DICT 的裸 CID 编码 CFF1 程序,其中每个槽位的 CID 都等于原始 glyph ID,空槽和未用槽也不例外。这个恒等关系就是全部设计。字体名、PDF 的 /W 宽度、CFF advance 和 ToUnicode CMap 指的都是同一套编号,任何一层都不必在 glyph ID 与 CID 之间翻译,也就没有什么会慢慢错位
PDF 这一侧,后代字体是带 Identity-H 或 Identity-V 编码的 CIDFontType0,程序流放在 /FontFile3 下并标 /Subtype /CIDFontType0C。因为 CID 已经等于 GID,后代字体不带 /CIDToGIDMap;该流也被排除在后面用于已注册 TrueType 字体的流替换钩子之外。与 /Subtype /OpenType 包装不同,转换后的流不会抬高 PDF 1.6 的版本要求
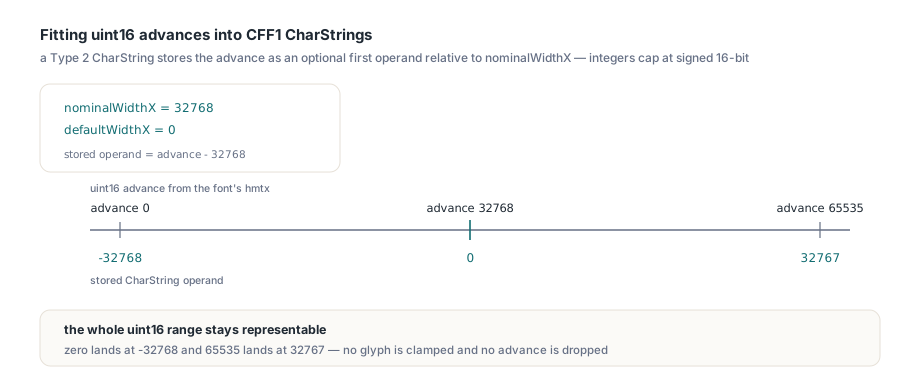
宽度上需要一个小技巧。CFF1 的 Type 2 CharString 把 advance 存成相对 nominalWidthX 的可选首个操作数,而整数操作数限制在有符号 16 位范围内。OpenType 的 advance 是无符号 16 位值,最大 65535。HotPDF 把 nominalWidthX 设为 32768、defaultWidthX 设为 0,然后把每个 advance 显式写成 advance - 32768。零 advance 变成 -32768,65535 的 advance 变成 32767,整个 uint16 范围都能表示,一个 glyph 都不用截断
几何信息得到同样的照顾。FontMatrix 是 [1/UnitsPerEm 0 0 1/UnitsPerEm 0 0],2048 单位的字体保留原生坐标。单个操作数装不下的相对移动和连线被拆成可表示的步长,三次曲线的细分方式保持其形状。原始版权与许可记录、原始 name 表和嵌入标志都随 CFF Notice 字符串一起带上
在文档之外调用转换器
转换器是 HPDFOpenTypeAdvanced 单元里的一个公开函数,纯 Pascal 实现,不依赖 HarfBuzz,也没有安装系统字体的步骤。因此它可以单独使用,比如在构建期预转换字体,或检查 PDF 写入器将会嵌入什么
uses
  System.SysUtils, System.IOUtils, HPDFOpenTypeAdvanced;

procedure ConvertWeight650;
var
  Source, Cff: TBytes;
  Axes: THPDFVariableFontAxisValueArray;
begin
  Source := TFile.ReadAllBytes('C:\Fonts\AcmeSerifVF.otf');
  SetLength(Axes, 1);
  Axes[0].Tag := 'wght';
  Axes[0].Value := 650;
  Cff := HPDFConvertCFF2ToCFF(Source, Axes);
  if Length(Cff) = 0 then
    raise Exception.Create('Not convertible: not CFF2, embedding denied or bad axes');
  TFile.WriteAllBytes('AcmeSerif-650.cff', Cff);
end;
可变输入在给定坐标处走仅几何的静态实例化,轮廓和 advance 都覆盖。静态 CFF2 字体只接受空选择;给它传轴值会当作错误处理,而不是忽略。结果是裸 CFF1 程序,不是 sfnt 容器,别把它交给期望 OpenType 文件的代码
对预期中的失败情形——输入不是 CFF2、实例化器不接受该轴选择、NaN 之类的非有限值,以及 OS/2 fsType 设了受限许可嵌入(0x0002)或仅位图嵌入(0x0200)的字体——失败表现为空 TBytes,而不是异常。务必检查长度。在 EndDoc 里写入器会替你检查并抛出“StoreFont: CFF2 outline conversion failed”,这是正确的取舍:发布出去的 PDF 里躺着一个空字体程序,远比日志里一条可见的错误糟糕
面向服务器负载的预算与取消
可选的第三个参数 THPDFVariableFontControl 用来限制内存,并允许取消耗时的转换。不传时转换器使用默认值:字体输入和输出各 128 MiB 上限、1 GiB 累计工作预算,以及 CFF1 的每 CharString 65535 字节限制
type
  TFontJob = class
  private
    FCancelled: Boolean;
    procedure CheckCancel;
  public
    function Convert(const Source: TBytes): TBytes;
    property Cancelled: Boolean read FCancelled write FCancelled;
  end;

procedure TFontJob.CheckCancel;
begin
  if FCancelled then
    Abort;  // 从 HPDFConvertCFF2ToCFF 里向外传播
end;

function TFontJob.Convert(const Source: TBytes): TBytes;
var
  Control: THPDFVariableFontControl;
begin
  Control := THPDFVariableFontControl.Create(
    32 * 1024 * 1024,           // 输出字节上限
    Int64(256) * 1024 * 1024,   // 累计工作预算
    CheckCancel);
  try
    // nil 选择:可变字体的默认实例,或静态 CFF2 字体
    Result := HPDFConvertCFF2ToCFF(Source, nil, Control);
  finally
    Control.Free;
  end;
end;
预算超限和取消都以异常形式报告,刻意与空结果路径区分开。空数组意味着这个字体转不了;异常意味着这一次尝试被中止了。错误处理里要把这两者分开,因为换更大的预算去重试一个本来就无法转换的字体毫无意义
嵌入一个 CFF2 字体有多大代价?
最需要规划的是文件体积:无论 EnableFontSubsetting 开关与否,HotPDF 对 CFF2 字体都嵌入完整的转换后 glyph 集。一款几千个 glyph 的字体,会把自己全部塞进每个用到它的文档,哪怕页面上只有一行标题。做宣传册这可以接受;对一个要产出成千上万份小 PDF 的报表服务器,这是实打实的成本,动手前应当实测
相关的体积特性遵循同一条规则。转换后的 CFF2 字体整体嵌入,所以 CompressDocument 启用的紧凑字体子集和 持久化字体子集缓存都不适用于它们。同一文档里的 TrueType 字体仍照常做子集和缓存。完整保留每个 glyph 的唯一好处,是许可证禁止子集化的字体能以尊重许可证的形式嵌入
这些资源限制是有限的转换限制,CFF1 本身也封顶了单个 CharString 的容量。转换后 CharString 超过 65535 字节的 glyph,或把工作预算烧穿的字体,都会显式失败,而不会带着空轮廓被写出去。这就是设计好的取舍:一个罕见字体上的响亮失败,胜过一份 glyph 无声缺失的文档
原生 CFF2 文本和这个可移植的 CFF1 转换器随 HotPDF Delphi PDF component(面向 Delphi 与 C++Builder)提供,可变字体实例化、彩色 glyph 与字体子集等特性在本博客其他文章里另有覆盖