构造这样一份 PDF:/Dests 名称树的根有两个孩子。第一个孩子声明 /Limits [(a) (z)],它的 /Kids 数组直接指回根。第二个孩子握着 (chapter7) 的真实表项,但范围写反了:[(z) (a)]。拿教科书式的名称树查找去问 chapter7,它要么递归到栈爆掉,要么对一个阅读器明明能跳过去的目标回答「找不到」。整个文件不到两 KB,每个对象都解析得干干净净
这份文件把三个独立的陷阱装进一个结构:一个 /Kids 环、一个声称持有其实不持有的键的范围、一个永远匹配不到任何东西的范围。第四个陷阱需要大得多的文件。一旦单片叶子携带超过 32,768 个名称/值对,任何把「哪片叶子」和「哪个表项」塞进一个 32 位整数的代码都开始指向错误的对。本文其余部分逐个走完这些陷阱、读取者应当如何应对,以及这样构造的文件上 Delphi 调用的行为
踩在名称树与数字树上的四个 PDF 特性
名称树和数字树撑起 PDF 里所有「把一大组键映射到对象」的特性,PDFlibPas(losLab 的 Delphi PDF 库)经公开的 TPDFlib 方法暴露其中四个。ISO 32000-1 §7.9.6 定义名称树(字符串键,Table 36),§7.9.7 定义数字树(整数键,Table 37)。根与中间节点携带 /Kids;叶子把排好序的键值对放在 /Names 或 /Nums 里;每个非根节点按规范都应携带一个两元素的 /Limits 数组,记着它底下最小与最大的键
| 树 | 位置 | 规范章节 | PDFlibPas 读取 API |
|---|---|---|---|
| 命名目标 | 名称字典里的 /Dests | §12.3.2.3 | GetNamedDestination,随后 GetDestPage / GetDestType |
| 页面标签 | 目录里的 /PageLabels(数字树) | §12.4.2 | GetPageLabel |
| 附件 | 名称字典里的 /EmbeddedFiles | §7.7.4, §7.11.4 | EmbeddedFileCount、GetEmbeddedFileStrProperty |
| 文档级 JavaScript | 名称字典里的 /JavaScript | §7.7.4 | GlobalJavaScriptCount、GlobalJavaScriptPackageName |
有两行藏着褶皱。命名目标还存在更老的 PDF 1.1 形式——目录里一个以名称对象为键的普通 /Dests 字典——GetNamedDestination 先查那个字典,然后才下到 PDF 1.2 的名称树。JavaScript 那一行有个近乎同名的亲戚,读的却是完全不同的东西:GetDocJavaScript 返回挂在目录 /AA 字典文档触发器上的脚本(WS、DS、WP、DP、DC),而文档打开时运行的命名脚本包住在 /JavaScript 名称树里,由 GlobalJavaScriptPackageName 列出
这些结构统统来自文件。规范告诉写入者应当产出什么,读取者收到的却仍是写入者、一次坏掉的增量保存或 fuzzer 实际放进去的东西。这与加固 Pascal PDF 解析器以抵御恶意文件是同一课,只是用在树的形状而非缓冲区长度上
成环的 /Kids 数组为什么会让递归树遍历器崩溃?
递归遍历器在成环的 /Kids 数组上崩溃,因为递归里没有任何东西记得自己进过哪些节点,于是子节点指向祖先的一处引用,就把有限文件变成无尽下潜。合法的树不用成环也能造成同样的伤害:一条 4,096 层的单子节点链是完全合法的语法,却要收走递归读取者 4,096 个栈帧
温和些的变体根本不崩溃。两个 /Kids 表项引用同一片叶子时,朴素的枚举会访问它两次,附件计数于是高于文档里实际的文件数,脚本列表把同一个包列出两遍
PDFlibPas 用堆上的显式后进先出栈加一个以字典同一性为键的已访问集合遍历两种树。节点在弹出时标记。环引用可以在栈上稍作停留,但它一冒头就被丢弃,每个不同的节点恰好展开一次子节点。总工作量以不同字典的数目加上它们 /Kids 数组的总长度为界;4,096 层的链不过是 4,096 次循环迭代加 4,096 个哈希集合表项
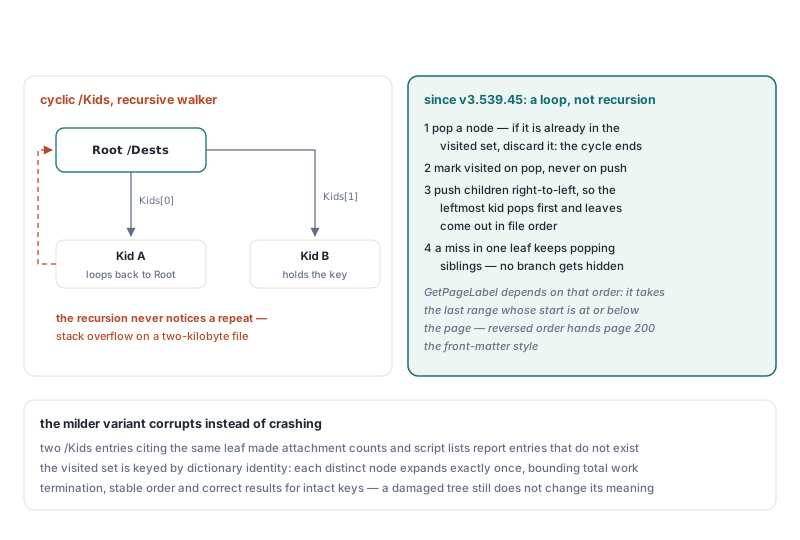
顺序是把递归改循环时最容易做错的部分。栈会反转你喂给它的东西,所以子节点必须从最后一个索引压到第一个;这样最左的孩子先弹出,叶子按写入者书写的从左到右顺序出来。弹出时标记而非压入时标记,道理相同:若压入即标记、又从右向左压,位置 0 和 2 共享的叶子会被位置 2 抢走,它的表项就会晚于文件所说的顺序出现。页面标签依赖这个顺序,最后一节会展示
如果你针对别的对象模型写自己的树代码,这就是我们推荐的形状。下面的节点类型刻意保持抽象,两个函数都是读取侧代码,不是库调用
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // 叶子上为空
    Keys: TArray<string>;      // 叶子键,按规矩的写入者会排好序
    Values: TArray<Integer>;   // 与 Keys 平行
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// 你自己的辅助函数:/Limits 只有在良构、有序的对时才可用于剪枝
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

// 你自己的查找:显式栈、已访问集合、弹出时标记
function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // 环或共享子节点:见过了
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // 从右向左压入,最左边的子节点先弹出
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // 这片叶子里没找到:继续弹它的兄弟
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
一个分支落空,对整棵树说明不了任何事
最常见的查找捷径是挑第一个 /Limits 覆盖该键的孩子,钻进去,从此不再看任何兄弟。干净的树上这是正确且快的。在开头那段构造的文件上它就失败:第一个孩子声称拥有 chapter7,把搜索带回根,于是空手而归,而下一个兄弟正握着那个表项
PDFlibPas 不在第一个看似可信的分支上停手。GetNamedDestination 背后的按键查找把范围不排除该键的每个孩子都压栈,持续弹出直到命中或栈空。范围互不重叠的良构树上,每一层至多一个孩子通过范围检查,额外代价为零;损坏的树上多访问几个节点,换来正确的答案
叶子得到同样的待遇。ISO 32000-1 要求 /Names 数组里的键按字节值排序,所以库先试二分查找。落空时回退到对键值对的线性扫描,否则乱序的叶子会让真实存在的键隐身。每一次真实落空都付一次线性扫描的代价,我们接受:对确实不存在的名字做查找是少数情况,而把一个能用的链接报成「找不到」,远比多扫一遍叶子昂贵
有一处结构矛盾靠拒绝处理。Table 36 允许节点携带 /Kids 或 /Names,绝不同时携带两者。按键查找把两者都带的节点当畸形处理,直接跳过,而不去猜写入者指的是哪一半。数字树的枚举——比如 GetPageLabel 背后的遍历——更宽容,两者都在时跟 /Kids 走,因为丢掉一整个范围会让其后每一页贴错标签
读取者可以拿 /Limits 信什么?
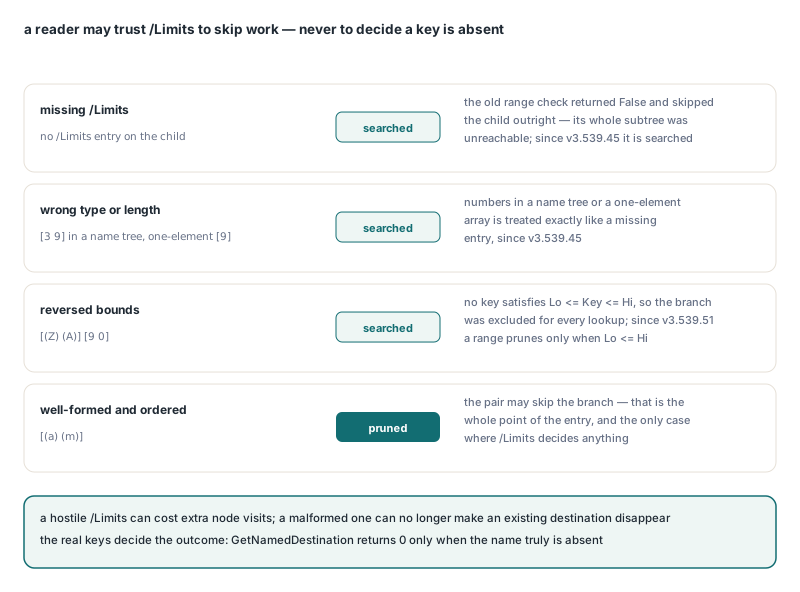
读取者可以拿 /Limits 跳过工作量,且仅当那对值良构时;绝不能拿它断言键不存在。Table 36 说中间与叶节点应当携带它,但实践中这个表项会在手工编辑后消失、会在名称树里装着数字、或者上下界颠倒着到达。PDFlibPas 对每一种情形的处理一致:让那个孩子保持可搜索
- 缺失
/Limits:跳过这种孩子的范围检查,会让写入者一忘写表项,整棵子树就不可达,所以会搜索该孩子 - 类型错或长度错,比如名称树里装数字、或只有一个元素的数组:按缺失表项完全一样的方式处理
- 颠倒的边界,如
[(Z) (A)]或[9 0]:Lo > Hi时没有任何键满足Lo <= Key <= Hi,信任这一对会把该分支从每次查找里排除;只有下界不超过上界的范围才用于剪枝 - 良构且有序:用于跳过分支——这正是这个表项存在的意义
调用侧有两个零要分清。GetNamedDestination 在名字确实不存在时返回 0,否则返回目标 ID。GetDestPage 对有效 ID 返回 0,意思是名字存在、但它的目标解析不到本文档里的页面——那是另一种 bug 报告。GetDestType 报告视图:1 是 XYZ,2 是 Fit,依此到 8 是 FitBV
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID, Page: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // 先查目录 /Dests(PDF 1.1),再查 /Dests 名称树
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
    begin
      WriteLn('No destination named ', DestName);
      Exit;
    end;
    Page := Lib.GetDestPage(DestID);
    if Page = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Page,
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ,2 = Fit ...
  finally
    Lib.Free;
  end;
end;
这正好是一个紧凑的回归检查。构造开头那段的两孩子文件,把 chapter7 的真实表项指到第 2 页、/Fit 视图,这个过程应打印第 2 页、视图类型 2。首个匹配式的查找打印「No destination」,因为绕环的孩子赢了赛跑;信任颠倒范围的查找出于相反的原因打印同样的内容。目标解析通了之后,指向它们的书签条目见在 Delphi 里读取 PDF 书签与注解动作
越过 32,768 个表项的叶子与打包索引陷阱
当代码需要用一个整数句柄表示「第 M 片叶子的第 N 个表项」,诱人的编码是把叶子位置塞进 Integer 高 16 位、把该叶子 /Names 数组内的偏移塞进低 16 位。每对占两个数组槽。于是对 32,768——第 32,769 对——从偏移 65,536 也就是 $10000 开始。这个位进位到高半段,解码回来就成了下一片叶子的偏移 0
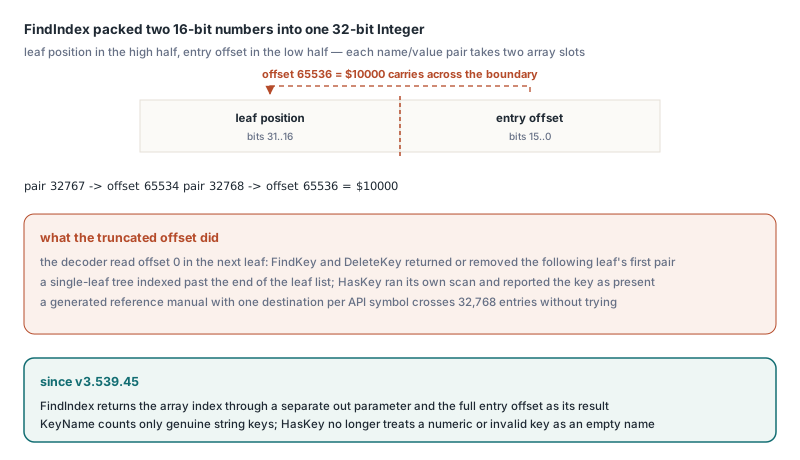
症状取决于树的形状。单叶子树没有下一片叶子,解码出的句柄索引到叶子列表末尾之外。多叶子树里,查找或删除落在下一片叶子的第一对上,而单纯的键扫描仍报告请求的键存在。这种尺寸的文件并不稀奇:一份每个符号一个命名目标的生成版 API 参考手册很快越过 32,768 个表项,而且有些写入者把它们全塞进一个扁平叶子,不去平衡树
PDFlibPas 把叶子位置和表项偏移放在两个全宽整数里,任何叶子尺寸下谁也溢不进谁。同一个读取器只统计真正的字符串键。对形如 [(Valid) 42 123 456] 的叶子,EmbeddedFileCount 报告 1,数字键 123 不会被误当空名称,索引为 0 或更低时 GetEmbeddedFileStrProperty 返回空字符串,而不是后面碰巧跟着的对象。该函数的 tag 1 是文件名,tag 2 是 MIME 子类型
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // /PageLabels 数字树;没有它的文件返回普通页码
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // /EmbeddedFiles 名称树;索引从 1 起,非字符串键跳过
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // 名称、MIME 子类型
    // /JavaScript 名称树:列出包名,不执行任何东西
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
一份两页的测试文件能很好地展示预期输出。给它的 /PageLabels 根一个把同一片叶子列两次、又引用根自身的 /Kids 数组,范围是第 1 页起的小写罗马数字和第 2 页起带前缀 A- 的十进制。审计应打印 i 和 A-1,每个区间一次。把页面标签写进这样的树另有讲究,见修复存进 /Kids 数字树的 PDF 页面标签;AddPageLabels 插入前会先把 /Kids 根拍平成单个 /Nums 叶子,用的正是同一套防环枚举
遍历把界线画在哪里
遍历保证终止、顺序稳定,以及对任何真实键完好的树给出正确答案。它按原样读取损坏的树,不去重构作者的本意,这个选择带来五条后果
- 定义节点的是同一性,不是内容。表项完全相同的两个不同字典是两个节点,所以复制而非引用叶子的写入者,那些表项就会出现两次
- 良构、有序的
/Limits对即使撒谎也照样剪枝。一个撒得像真的范围——比如[(a) (m)]盖住一片还握着(q)的叶子——就藏住了q。唯一的防御是无视所有/Limits、扫描每片叶子,而在有几万表项的目标树上,这丢掉了这个表项存在的理由。我们保留剪枝 - 枚举保持文件顺序。
GetPageLabel遍历每个枚举出的区间,应用起始索引不大于页码的最后一个,所以乱序写区间的写入者得到文件序语义,反过来遍历就会让第 200 页拿到前置内容的样式 - 内存随不同节点与表项的数量增长。遍历在已解析对象之上只多出一个列表和一个哈希集合
- 一片叶子内部的重复键按确定性解决:二分查找返回它最先落到的那个匹配对,线性回退保留它扫到的最后一个匹配
预检工具、归档器和文档阅读器在渲染第一页之前就读这些树,上传队列里进来的任何东西,它们都首当其冲。本文描述的树读取器随 PDFlibPas, the PDF Library for Delphi 发布,Delphi 与 Free Pascal 都能构建