在一份刚合并的申请包的第 1 页 Applicant 框里输入名字,按下 Tab,在很多查看器里第 6 页的 Applicant 框会填上同样的文字。没有人把这两个控件连在一起。包的第 1 部分和第 3 部分出自不同作者之手,都把顶层字段命名为 Applicant,而 PDF 表单用完全限定名来标识字段。对文件格式来说,同名的两个字段就是被画了两次的同一个字段
解决办法是在合并发生之前就决定共享的名字意味着什么:拒绝、有意保留,还是给新来的改名。事后才做决定比听起来难得多
ISO 32000 对字段名的定义
字段名就是身份,规范明说了这一点。ISO 32000-1 §12.7.3.2 用字段及其每个祖先的部分名(T 条目)以句点连接构成完全限定名。同一节还允许多个字段字典共享一个完全限定名,并把它们描述为同一个底层字段的不同表示,彼此只应在外观上有差别。把两份独立创作的表单的 Fields 数组拼接起来,恰好就会意外产出这种布局
损害大小取决于相撞的字段装的是什么。一个表单上表示出生日期、另一个表单上表示签署日期的 Date,现在只有一个值槽,查看器定了哪个值就落在两处。费用表上的 Total 和押金单上的 Total,只要有一边参与计算就会立刻打架。签名字段是最坏的情形:不同页上的两个签名部件、一个名字,签署人到底认可了哪个部件没有干净的答案
大小写也重要。部分名是文本字符串,规范里没有任何折叠规则,所以 Total 和 total 是两个字段。比较前把名字转小写的冲突检查会报告根本不存在的冲突,而在改名策略下,它会给没人需要动的字段改名
在任何东西动起来之前检查名字
PDF Library for Delphi 把冲突处理放在 MergeDocumentEx(DocumentID, DuplicateFieldStrategy) 里,它把 DocumentID 标识的文档合并进当前选中的文档,并在任何一个对象被重新编号之前解决全部名称冲突。策略是一个 TPDFlibDuplicateFieldStrategy 值:dfsReject、dfsMerge 或 dfsAutoNumber。朴素的 MergeDocument 仍然原样拼接两份根字段数组——当你同时拥有两份表单、清楚它们的名称不相交时,这正是正确的选择
顺序就是整个设计。合并必须平移来源文档的对象编号以免与目标相撞,把它的页缝进目标的页树,再把它的字段附加到表单上。如果冲突在这些步骤之后才暴露,拒绝就不再是免费的了——目标已经吸收了页面,来源的对象带着两个文件原本都没有的编号,调用方除了把两个文件从磁盘重新加载之外没有任何状态可退。MergeDocumentEx 先把两份文档的顶层字段名收进一个有序、区分大小写的集合,再对着这个集合应用策略。在 dfsReject 下,冲突让调用返回 0,LastErrorCode 置为 705,两份文档保持加载时的原样:拒绝之后你立刻从来源文档读一个字段值,拿回来的仍是原文
扫描本身很便宜。目标 n 个名字、来源 m 个名字,把它们排成一个集合的代价是 (n + m) log(n + m) 量级的比较,几百个字段的包相对于解析文件的开销根本不构成可感知的增量
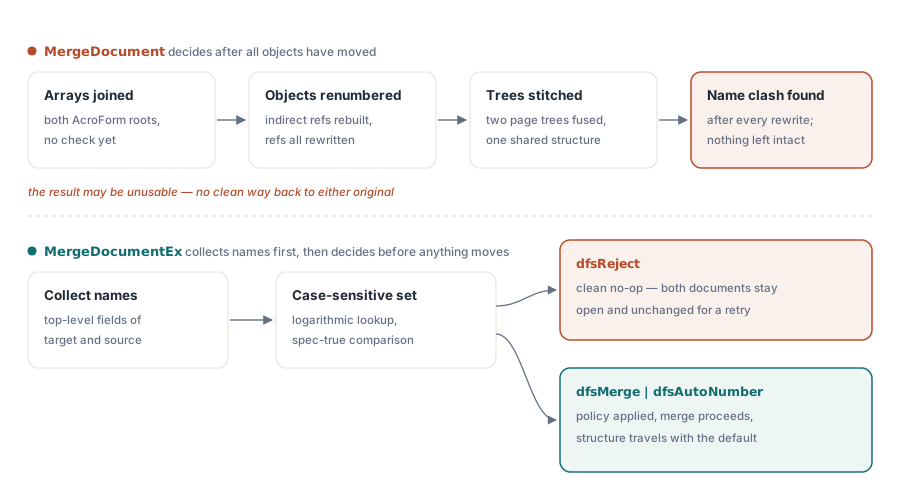
扫描有三条性质会出现在真实的表单包里:
- 只比较顶层字段。在层级表单里这意味着父字段的部分名,所以两份各有一个叫
applicant的父字段的表单即使子字段不同也会冲突,而自动编号改的是父字段的名字:新来的子字段随后读作applicant_2.name和applicant_2.address - 来源名字在检查的同时加入集合。一份已经带着两个同名顶层字段的来源文档,会在第二个名字上触发策略,哪怕目标根本没有同名字段
- 部分名为空的字段被跳过;任一文档没有 AcroForm 时无可比较,任何策略下合并都直接进行
加载侧有一个自己的陷阱。LoadFromFile 向库添加新文档并选中它,所以要留住的标识符是每次加载之后 SelectedDocument 返回的那个。加载之前先去拿,你手里握着的就是另一份文档,不是你以为要合并进去的那份
uses
  SysUtils, PDFlibrary;

procedure BuildPack(const Part1, Part2, OutFile: WideString);
var
  Lib: TPDFlib;
  TargetDoc, SourceDoc: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Part1, '') = 0 then
      raise Exception.CreateFmt('Cannot load %s', [Part1]);
    TargetDoc := Lib.SelectedDocument;   // 在加载之后读,不要在之前

    if Lib.LoadFromFile(Part2, '') = 0 then
      raise Exception.CreateFmt('Cannot load %s', [Part2]);
    SourceDoc := Lib.SelectedDocument;

    Lib.SelectDocument(TargetDoc);       // 被选中的文档接收合并
    if Lib.MergeDocumentEx(SourceDoc, dfsReject) = 0 then
    begin
      if Lib.LastErrorCode <> 705 then
        raise Exception.CreateFmt('Merge failed, error %d', [Lib.LastErrorCode]);

      // 顶层名称重复:两份文档都完好无损,
      // 所以 SourceDoc 可以直接用于第二次尝试
      WriteLn('Duplicate field names in ', Part2, ', retrying with auto-numbering');
      if Lib.MergeDocumentEx(SourceDoc, dfsAutoNumber) = 0 then
        raise Exception.CreateFmt('Merge failed, error %d', [Lib.LastErrorCode]);
    end;

    Lib.SaveToFile(OutFile);
  finally
    Lib.Free;
  end;
end;
先严格后宽松。这个两步形态之所以成立,是因为拒绝让 SourceDoc 保持加载且完好;若合并走到一半才失败,回退分支就得从重新加载两个文件开始。专门检查 705 也很要紧,因为无效的文档标识符或越界的策略值会以别的错误码失败调用,换一个策略重试对这两种情况都无济于事
选策略:拒绝、共享还是重新编号
无人值守的流水线,把 dfsReject 设为默认,把 705 当成给来源表单责任方开的工单。上游改一次字段名,比几个月后才发现某个导出映射因为合并发明了 Total_2 而悄悄失配便宜得多。自动策略值得用的场景,是人已经看过这些表单、想清楚了共享名字的含义
dfsMerge 是有意保留共享名。在附加任何东西之前,目标字段的值和默认值会被复制进新来的字段,所以合并出的文件一开始就一致,按名字归组部件的查看器看到的是一个逻辑字段、一个值。两个字段字典仍是分开的对象,各自保留自己的页面、外观和动作。把它们折叠成一个字典会丢掉属于来源表单的格式和行为,为了一点外观上的简化做这种交换不值
dfsAutoNumber 给新来的重复名字追加数字后缀,从 _2 起找第一个空位。目标已有 Shared 和 Shared_2,新来的就成了 Shared_3。结果只取决于在场的名字,从不受对象编号影响,所以同样两个文件合并两次得到同样的名字——下游的 FDF 导入和数据库映射依靠的正是这条性质
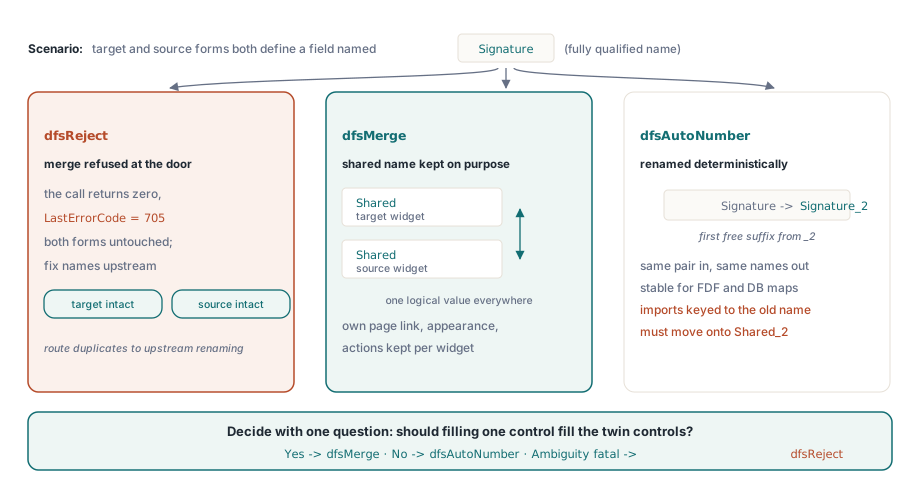
两个自动策略之间的选择归结为一个问题:填一个控件该不该填另一个?签署人姓名在包的每个部分重复出现,该,dfsMerge 合适。每张表单各算各的合计,不该。这里选 dfsAutoNumber,或者更好,在来源表单里把字段改名,让后缀根本不出现
合并之后表单里有什么?
目标有一个顶层文本字段 Shared,值为 “Target value”;来源有自己的 Shared。dfsMerge 之后,FormFieldCount 数出两个字段,标题都是 Shared,值都报告 “Target value”。dfsAutoNumber 之后,同样的输入得到 Shared 和 Shared_2,新来的字段保留它在来源文件里的原值
dfsMerge 的结果有一道锋利的边,位置就在你自己的填写代码里。FindFormFieldByTitle 返回第一个标题匹配的索引,SetFormFieldValue 只写一个字段。一个查一次 Shared 就设置的例程,更新的是目标的副本,新来的副本还握着合并那一刻收到的值。保存的文件里从此有两个同名字段、两个不同的值,查看器显示哪个全看它心情。把每个匹配都写一遍:
// 设置所有名为 Title 的字段;返回写入的个数。
// dfsMerge 合并后,一个逻辑字段可能出现在多个索引上
function SetAllFieldsNamed(Lib: TPDFlib; const Title, Value: WideString): Integer;
var
  I: Integer;
begin
  Result := 0;
  for I := 1 to Lib.FormFieldCount do
    if Lib.GetFormFieldTitle(I) = Title then
    begin
      if Lib.SetFormFieldValue(I, Value) = 1 then
        Inc(Result)
      else
        WriteLn(Format('Field %d (%s) not written, error %d',
          [I, Title, Lib.LastErrorCode]));   // 只读字段会落到这里
    end;
end;
把合并出的包接进数据源之前,先把合并实际产出的东西倒出来看。两行循环就够了,它会在导入任务之前抓住被改名的父字段和 _2 后缀:
for I := 1 to Lib.FormFieldCount do
  WriteLn(Format('%3d  %-30s  %s',
    [I, Lib.GetFormFieldTitle(I), Lib.GetFormFieldValue(I)]));
实践中组装表单包
成功的合并会消耗来源文档。它从库的文档列表中移除,DocumentCount 减一,旧的 SourceDoc 标识符不得再用。合并后的文档取两个 PDF 版本中较高的那个:把 PDF 2.0 表单合进 1.7 文档得到 2.0 文件——如果下游的归档步骤要求特定版本,这一点就有分量
合并顺序决定哪些名字活下来。被选中的文档保住自己的每一个名字,改名和值复制只落在新来的字段上,所以 A 合进 B 和 B 合进 A 得到不同的自动编号结果。当包里有一份主表单——后台系统已经认识它的字段名的那份——让它当目标,把补充表单合进去
最后签名。签名覆盖的是它签署的那个修订版的字节,而合并会重写文件,所以组装前签署的部分不再携带与文档匹配的签名。先组装包、检查字段列表,再对完成的文件应用签名。如果任务只是把页面拼在一起、表单无关紧要,通过字节引用偏移实现的快速 PDF 合并是更快的路
把数据侧和合并一起规划。如果字段值来自一个按名字寻址字段的外部系统,选 dfsAutoNumber 之前先谈妥命名,因为 Shared_2 不会匹配期待 Shared 的映射。值的导入导出格式见FDF、XFDF 和 XFA 表单数据交换。按名字引用字段的计算脚本和动作受改名的影响完全一样,交互式表单动作与 JavaScript 展示了这些引用的位置
感知重复的表单合并、字段填写和数字签名都属于同一个库,服务 Delphi、C++Builder 和 Free Pascal 项目。PDF Library for Delphi 产品页列出了其余的表单与文档组装 API