把几份 PDF 串接起来听起来应该很便宜。页面内容已经排好,字体已经嵌入,图像已经压缩。原则上合并只是记账:把对象重新编号让两个文件的编号空间不再冲突,把页面树拼到一起,修好交叉引用表,然后写出。实际上大多数合并代码把这份便宜丢掉了。它对每个输入文件里的每个对象跑一次完整解析、生成带标记的对象树,改动一两个间接引用,再把树序列化回字节。解析和重新序列化是贵的那两半,而对绝大多数对象来说,它们产出的字节序列和进去的几乎一模一样
PDF Library for Delphi 是面向 Delphi 和 C++Builder 的原生 Object Pascal PDF 引擎,它的快速合并路径就是为了在可证明安全的地方跳过这一趟往返。想法很窄,但在整批文档上很划算:对未修改过的非流对象,原样取用源字节,只对其中的间接引用做一次字节级重写,把每个 N G R 变成 (N+Offset) G R。没有分词器,没有对象树,没有序列化器。本文走一遍这条捷径在哪里合法、执行字节重写而不弄坏任何东西的解析器状态机、为什么书签合并需要完全不同的机制,以及普通合并路径如何共用同一条单趟线性扫描
为什么对象重新编号才是合并的真正成本
每个 PDF 都带着自己的对象编号空间。文件 A 有对象 1、对象 2,依此类推;文件 B 也有自己的对象 1、对象 2。你不能把 B 的对象原封不动放进 A 的文件,编号会冲突,B 内部的每个间接引用都会解析到错误的对象。解法是加偏移:如果 A 止于对象计数 Offset,B 的对象 N 在输出里就成了对象 N+Offset,而 B 的对象内部出现的每个引用 N G R 都必须平移成 (N+Offset) G R 才能对上
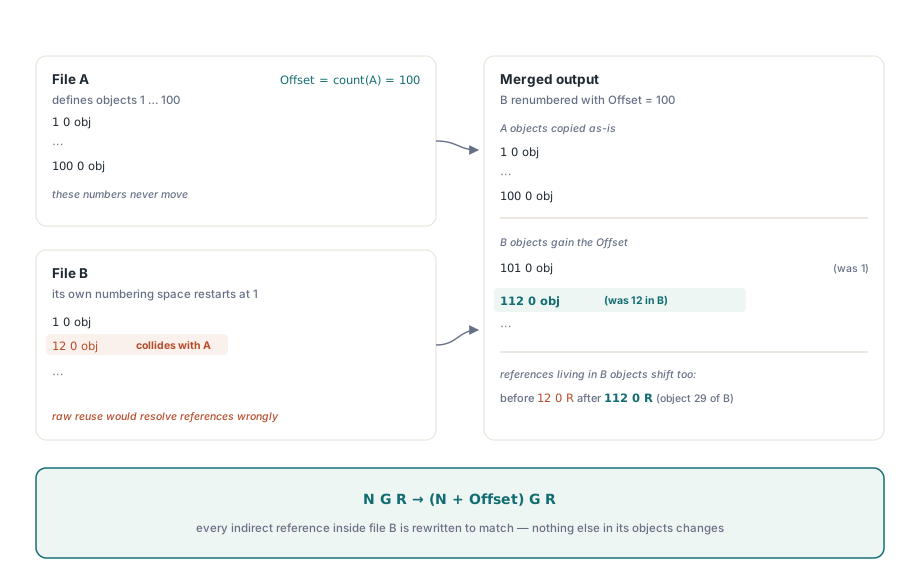
这个平移就是合并文档主体的全部语义工作。页面树修补和 AcroForm 合并只是对少数对象的小而有限的编辑。大头是把引用重写扫过数千个对象,天真的做法是解析每个对象以便从结构上找到引用。PDF Library for Delphi 的 MergeFileListFast 持相反观点:引用在原始字节里同样找得到,只要小心那些“数字-空格-数字-空格-R”不是引用的语境。跳过解析、就地平移,每个对象的成本就塌缩成对你本来就要复制的字节做一次线性扫描
什么时候复用源字节是可证明安全的
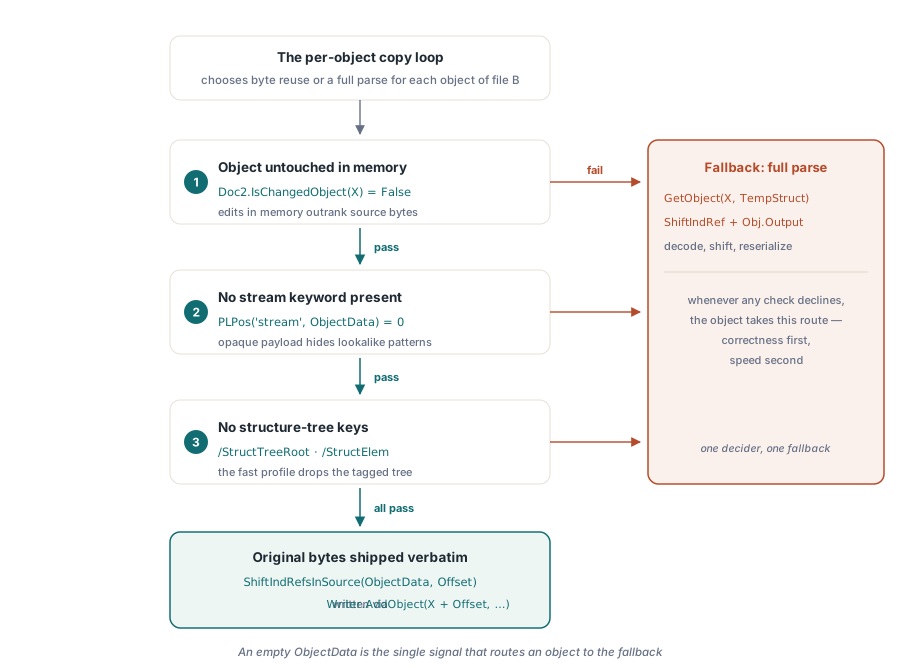
只有当从后续文档复制出来的对象同时满足三个条件时才走字节路径。任何一条不满足,对象就退回完整的解码-重新序列化路线,正确性永远优先于速度:
Doc2.IsChangedObject(X)为 False。合并引擎已经在内存里改过的对象(比如/Parent被重新指向的页面对象),内存里的树才是事实来源,原字节已过时。只有未动过的对象合格- 源字节里不含
stream关键字。流对象的主体是stream/endstream框起来的不透明二进制,对压缩或加密的流数据做天真的引用扫描,会愉快地“找到”并弄坏那些长得像引用的字节模式。流对象保留原来的流感知路径 - 源字节里既无
/StructTreeRoot也无/StructElem。快速配置下,tagged PDF 结构树被丢弃而不是合并,所以这些对象必须走解码路径,由引擎刻意把它们置空
决定落在逐对象的复制循环里。三项检查全过,对象的字节就直接交给 ShiftIndRefsInSource 再交给写入器;否则字节被丢弃,对象用 GetObject 重建、用 ShiftIndRef 平移、再序列化。这个分支的结构值得一看,因为检查的顺序正是安全性的来源:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // 回退到解码
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // 完整解析路径
  // ... 结构树对象置空、ShiftIndRef 平移、Obj.Output 输出 ...
end;
空的 ObjectData 就是字节路径拒收该对象的信号。这个单一哨兵让快慢两条路线不会漂移:做决定的地方只有一个,后备方案也只有一个
引用平移状态机及其边界情况
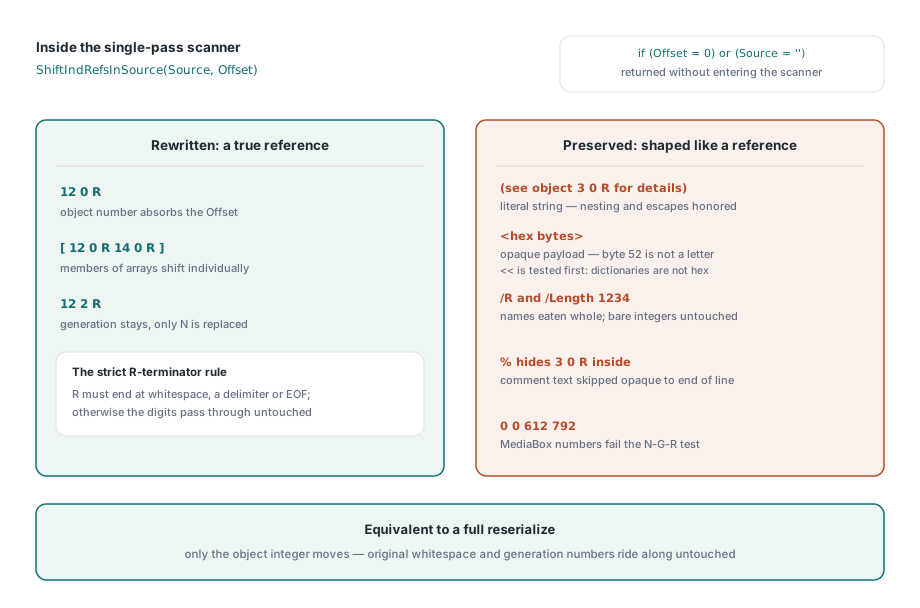
对间接引用做字节重写,错起来出奇地容易,因为 R 和数字串在 PDF 对象里到处出现,而语境并不是引用。ShiftIndRefsInSource 是一个手写的小扫描器,只把字节走一遍,只有当一个数字后面(标记之间隔着 PDF 空白)跟着另一个数字、再跟一个 R 分隔符时才重写它。便宜的出口放在最前面:偏移为零或源为空时,字节原样返回,根本不进扫描器
扫描器的正确性建立在认出那些“长得像引用也必须放行”的语境上。这些边界最容易漏,每一处都有显式处理:
- 以
(和)定界的字面字符串逐字复制,同时跟踪嵌套深度并遵守反斜杠转义,让转义括号不会弄乱深度计数。像(see object 3 0 R for details)这样的字符串里有一段教科书式的引用模式,其实只是行文,必须逐字节保留 - 以
<和>定界的十六进制字符串原样放行、不作解释。十六进制字符串里的52两个字节正是R的 ASCII 码,把十六进制负载当文本处理的扫描器会凭空造出幽灵引用。字典开头的<<先被识别,字典才不会被误认成十六进制字符串 - 以
/开头的名称对象整体吞掉,从斜杠直到下一个空白或分隔符。没有这条,像/R(常见的资源键)这样的名称会被当成引用的R - 由
%引入的注释延伸到行尾,按不透明文本跳过 - 数字后跟 R 的测试是严格的。引用只有写成
N空白G空白R、且R以空白、分隔符或输入结尾收尾时才被识别。产生编号缺失,或R后面跟着字母,数字就原样输出。正是这一点保护了/Length 1234里的整数和MediaBox的四个数字不被悄悄加一
那条严格测试的核心读起来几乎就是规范句子描述的样子:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // 平移后的对象编号
  AppendBytes(E1, P - E1);                 // 原始空白 + 产生编号
  AppendBytes(P, 1);                       // 那个 'R'
end;
只有对象编号被重写;产生编号和标记之间精确的原始空白原样复制,所以除那一个必须改变的整数外,输出与输入逐字节相同。这种精确就是全部要点——它让复用源字节等价于完整重新序列化,而不只是接近。如果你自己写这样的扫描器,拿裸引用、数组里的引用、非引用数字、字面字符串、十六进制字符串、以及套了偏移的非零产生编号去测它
为什么书签不能复用 AppendOutline
把多份文档的书签并进一棵大纲树,看上去像现有 AppendOutline 辅助例程的活儿——它已经会把一份文档的顶层书签嫁接到另一份上。它在这里是错的工具,原因是一个微妙的分层错配:AppendOutline 靠阅读器走原始文件字节来找当前最后一个顶层书签,而快速合并把编辑暂存在 ChangeObject 的新对象缓冲区里,阅读器根本看不到这些编辑。把三份或更多文档串起来,每次追加都会把第一份文档原来的最后一个书签重新指向最新文档,中间所有文档的书签就从链上掉出去了——只有累计的 /Count 仍然正确,这让问题很好藏,直到有人打开书签面板
快速路径用一套两阶段、元数据驱动的注入解决它,全程不重走阅读器。第一遍扫过所有输入,为每份文档收集大纲根对象及其产生编号、第一个和最后一个顶层书签的编号,以及根的 /Count。依据这份摘要,代码用纯对象编号算术算出它需要伪造的每条链接的全局对象编号——每份文档顶层书签的 /Parent 指向共享根、第一个书签的 /Prev 指向上一份文档的最后一个、最后一个书签的 /Next 指向下一份文档的第一个。这背后有一条写出顺序约束:第一份文档的对象在任何后续文档打开之前就已写出,所以第一份文档的所有大纲编辑(根的 /Count 和 /Last,以及旧最后一个书签的 /Next)都必须能表达成不需要后继文档在手的算术。每份后续文档的编辑在它被打开之后、写出之前就地套用,从同一条改动对象路径出去
把一切系在一起的偏移对齐不变量
引用平移和书签注入都依赖一条算术不变量,它是整个设计里最脆弱的假设。注入到后续文档的引用写成目标全局对象编号减去该文档的 Offset,这样等对象稍后被 ShiftIndRef(Offset) 平移时,值正好落在预期的全局编号上。第一份文档 Offset = 0,直接用全局编号。要让这个减法正确,注入期间用的运行偏移序列必须与最终写出对象时用的偏移序列一致
它确实一致,靠的是页面和表单合并的一个性质:AddPages、AddFields 和 AddFieldFonts 只修改第一份文档的既有对象——从不新增对象。于是第一份文档的对象计数在整个页面合并阶段不变,每份后续文档的偏移(前面所有文档对象计数之和)从注入到写出都稳定。一旦破坏——合并中途引入一个会新建对象的阶段——下游每个页面和书签引用都会偏掉你新增的对象数。这条不变量无声,但承重
一个引擎之上的三个入口
快速路径不是合并代码的分叉。字节级引擎是单一内部例程 MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode),公开 API 是选两个旗标的薄封装:
MergeFileListFast关掉结构树保留调用引擎——最精瘦的路径,丢弃 tagged PDF 树,字节路线适用的对象最多MergeFileList开着保留调用,结构树存活,结果仍是可用的 tagged PDF。这条普通路径同样继承多文档书签和表单合并MergeFileListStrict打开严格模式:第一趟元数据扫描在第一个没有报告干净合并的输入处停下,只收录坏文件之前收集的文档,而不是跳过坏文件继续
因为三者共用一个引擎,普通合并同样以单趟线性扫描运行,每个输入只打开一次,而不是先并文件一二、再把结果与三并、逐步重解析越滚越大的累加器的成对 O(N²) 循环。真正想要成对合并的调用者仍可用两个入口 MergeFiles 和 MergeStreams
关于结构树行为有一句话要说,如果你靠检查字节来验证输出,它很重要。快速路径丢树的方式是移除第一份文档目录里指向 /StructTreeRoot 的引用;结构树对象本身仍被写出,只是没人引用。所以快速输出的字节里仍含 /StructTreeRoot 字符串,搜这个字符串分不清快慢输出——真正的差别是目录是否仍能到达结构树,这才决定文件是否还是可导航的 tagged PDF
什么时候用哪条路径
字节路径是吞吐量优化,用于组装很多份文档、又不需要保留 tagged PDF 结构树的场合——报告打包、对账单批跑、批量串接。对中大型输入集反复实测,字节复用按对象组合不同大约削掉 4% 到 13% 的挂钟时间;小文件和坏文件的表现与完整路径完全一致,因为扫描器无法证明安全的对象一律回退到完整解析。如果确实要为可访问性保留结构树,用保留它的普通 tagged PDF 合并路径;如果你面对的是单个超大文件而非很多输入,姊妹篇直接文件存取的大 PDF 合并与拆分里讲的字节复制手法,把同一套“复制字节、避开完整对象树”的哲学用到了文件尺度
这些合并例程及快速、严格变体属于 PDF Library for Delphi Delphi PDF 库,其文档载有文件列表 API 与本文所述合并选项的完整参考