LZW编码器的字典总是比将要读它输出的解码器领先一个条目,所以两侧不能共用同一个码字宽度阈值。PDFlibPas给TPLLZWEncoder和TPDFLZWDecompressor各自一个从同一个EarlyChange标记推导出来的阈值,而这一条目的领先正是这个标记存在的全部理由
几乎所有手搓的LZW实现都在同一个地方翻车。你先写解码器,因为要打开文件你缺的就是它。它工作了。然后你写编码器,因为LZW是对称的,就一行一行地镜像解码器逻辑,跑一个往返测试,通过了。你发布了。六个月后一个客户用不是你的查看器打开你的输出,从流中间某个位置往后全是乱码。镜像就是bug:LZW的两半并不对称,假装它们对称,产出的流就只有你自己的代码能读
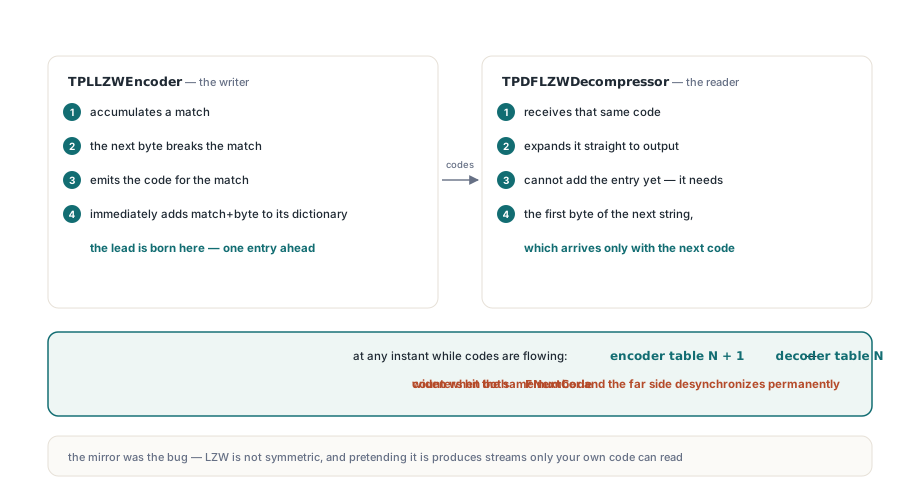
为什么编码器需要与解码器不同的阈值?
因为编码器学会每条字典条目的时机总比解码器早一步。这不是PDFlibPas的设计选择,而是LZW工作原理的固有属性,每个正确的实现都得在某个地方补偿它。顺着循环走一遍,就能看出领先从哪来。编码器累积一个匹配,发现下一个字节打破了它,发出匹配的码字,立刻把匹配加字节加进字典。解码器收到同一个码字并展开它,但此刻还不能添加对应条目,因为新条目需要下一字符串的首字节,而这个字节只有下一个码字到达时才出现。所以码字流动的任何瞬间,编码器表都比解码器表多一个条目。如果两侧都在自己的FNextCode碰到同一个数字时把码宽从9位加宽到10位,它们会相差一个码字加宽,远端位读取器就永久失步了。TPDFLZWDecompressor.ResetDictionary里,解码器阈值只计算一次,存在FChangeCode里:
// TPDFLZWDecompressor.ResetDictionary:阈值的解码端
FCodeSize := FInitialCodeSize;                 // PDF LZWDecode 对应 9
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // 当 FNextCode 达到 511 时加宽
else
  FChangeCode := FBitMask + 1;                 // 当 FNextCode 达到 512 时加宽
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode := FClearCode + 2; // 258解码循环在追加一个条目后立刻加宽,测试(FNextCode = FChangeCode) and (FCodeSize < 12),并按新宽度重算FBitMask和FChangeCode。9位在511或512触发,10位在1023或1024,11位在2047或2048,12位是上限,到那里字典必须用ClearCode冲掉而不是继续长大。编码器不能复用这些数字里的任何一个。它的GrowCodeSize加一来补偿领先,所以在设置EarlyChange时,编码器在512加宽,解码器在511加宽:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 while at 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 while at 9 bits
  // 解码器在读取 EOI 前会先加入最后一个待处理条目。
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;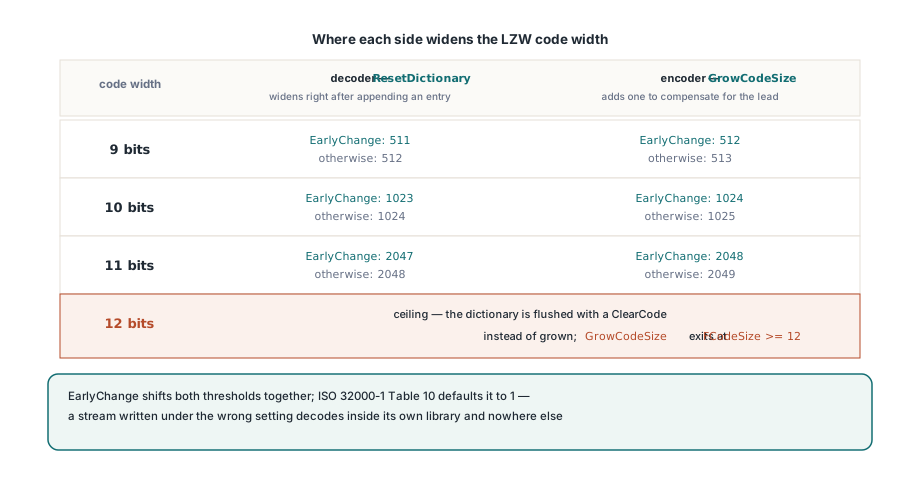
最后一个数据码字是两侧最终会合的地方
流的结尾是编码器必须停止领先、像解码器一样思考的唯一地方,GrowCodeSize上的FinalDataCode参数就是干这个的。用错误的宽度发出EOI码,它之前的一切仍然完全有效,所以缺陷会藏在上千个正确字节后面。过程是这样的。编码器发出最后一个数据码字,和之前每次迭代都不同,这次它不会在自己字典里加任何东西,因为没有后续字节可以用来扩展匹配了。解码器正好相反:它收到这最后一个码字,直到此刻才能补全从上一条码字起一直攥在手里的条目。最后一步解码器追了上来,领先缩到零,而它用来读EOI的宽度,由编码器从未创建过的那个条目决定。Dec(ChangeCode)就是编码器在恰好这一次调用里假装自己是解码器:
// TPLLZWEncoder.Compress,流的尾部
EmitCode(CurCode);      // 最终数据码,使用当前码宽
GrowCodeSize(True);     // 可以用递减后的阈值来加宽
EmitCode(FEOICode);     // EOI 使用解码器实际读取时的宽度
FlushBits;
FlushOutput;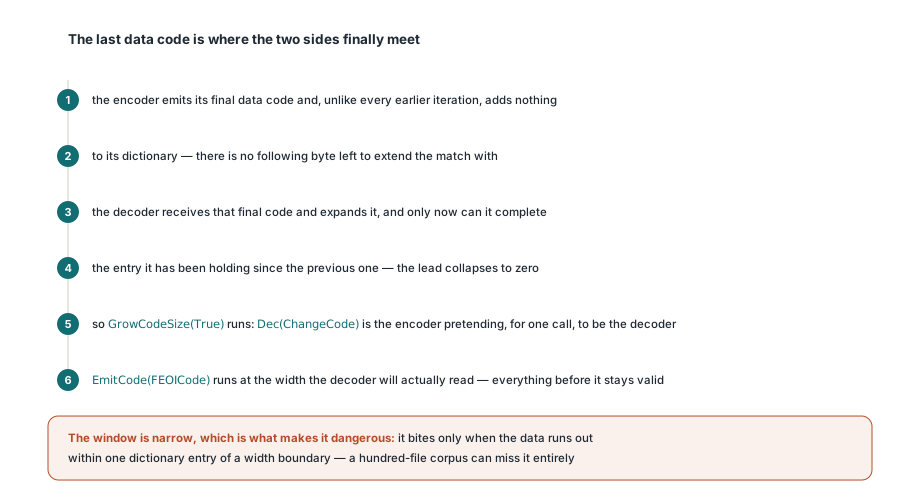
这个问题会发作的窗口很窄,这正是它危险的原因。只有当数据碰巧在距宽度边界一个字典条目之内耗尽时它才咬人,所以一百个测试文件组成的语料可能完全错过它,而某一份客户文件每次都命中。Compress里的边界情况必须刻意驱动:构造字典恰好落在510、511和512条目的输入,然后手工从流里读出发出的EOI位宽,而不是从一次成功的解码去推断
为什么通过了的往返测试仍可能藏着一个坏流?
因为两个犯同样错误的实现会彼此认可。如果你的编码器和解码器都早一个码字加宽,或者都晚一个码字,它们保持同步,往返测试逐字节还原输入,测试套件全绿,而你产出的流其他任何东西都读不了。这是整件事里最值得带走的一条:对LZW来说,自洽作为证据一文不值。所以自往返测试不能当主要测试,PDFlibPas改用另外三种方式验证LZW路径。手工构建码流,预期位模式也手工写出来,这样断言针对的是字节本身,而不是解码它们的结果。与独立实现做双向互操作,这个编码器产出的流在别处解码,别处产出的流由TPDFLZWDecompressor解码。还有差分解码:同一份字节用EarlyChange两种设置各读一遍,这样一份在错误设置下也干净解码的流会告诉你,宽度边界根本没被走到过:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // 刻意采用对 PDF 而言错误的规则
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A 必须与源匹配;B 绝不能匹配。如果 B 也匹配了,
// 输入太短,不足以跨越码宽边界。
真正给你覆盖率的是外部输入。当前测试素材跨越9、10、11和12位宽度,并迫使单条流里发生34次字典重置,这是证明4095上限处的ClearCode路径确实能工作的唯一现实方式。如果你的夹具从不超过几KB,那些代码一行都没跑过。而当一次修复改变了编码器产出时,把旧输出当作坏的,而不是值得保留的兼容基线;一条错误混用码宽的流不是遗留格式,只是一个碰巧被写进磁盘的bug
PDF说是1,TIFF说看情况
PDFlibPas在TPLLZWEncoder和TPDFLZWDecompressor上都把EarlyChange默认设为True,因为ISO 32000-1表10把EarlyChange定义为默认值为1的LZWDecode解码参数,意思是码长提前一个码字增加。这一点写在ISO 32000-1 7.4.4.2节,和predictor参数摆在一起,想要另一种行为的PDF必须在它的/DecodeParms字典里显式写/EarlyChange 0。TIFF是把这个标记做成属性而不是常量的原因:TIFF 6.0第13节描述LZW压缩时没有同样不含糊的表述,野外的编码器历史上也一直对此有分歧,PDF规范觉得有必要给参数命名,很可能正是因为这一点。所以在TIFF到PDF的流水线上,这个设置不是你在任何一端硬编码就能了事的。TIFF那一侧最终需要什么,就必须显式带进PDF的/DecodeParms,否则你就把一份本来打得开的文件转成了打不开的。FillOrder也要同样的小心,foTop和foBottom选择位读取器从字节的哪一端填充,TIFF Predictor 2的水平差分也一样,TPDFLZWParms通过Predictor、Colors、BitsPerComponent和Columns携带它。我们对加固内置TIFF解码器以支持BigTIFF和分块布局的笔记覆盖了这条路径的其余部分
两个值得点名的小陷阱
当你把编码器和解码器对象并排摆开,以为对称性在这里也成立时,这两处都特别容易接错:
InitialCodeSize在两个类上含义不同。TPLLZWEncoder.InitialCodeSize是根符号宽度,校验范围2到8,InitDictionary把FClearCode推导为1 shl FInitialCodeSize,并把FCodeSize设为FInitialCodeSize + 1。TPDFLZWDecompressor.InitialCodeSize是第一个码宽,校验范围2到9,ResetDictionary把FClearCode推导为1 shl (FCodeSize - 1)。对普通的8位PDF数据,默认值分别是8和9,你根本注意不到;手工把两个设成同一个数,你就造出了一对错配- 解码不可信的LZW,在成为正确性问题之前首先是内存安全问题,因为字典索引直接来自文件。
TPDFLZWDecompressor拒绝任何大于4095或大于等于FNextCode的码字,拒绝在4095之后继续添加条目,每次GetNextCode前按位检查剩余输入,并暴露SawExplicitEOI,让调用方能区分正确终止的流和只是字节用完了的流。截断的流不是部分成功。加固Pascal PDF解析器抵御恶意文件里更广泛的调研覆盖了这些防护关掉的缺陷类别
最后给你留下什么
LZW看起来对称,其实并不对称。编码器字典在流的主体部分始终领先一个条目,领先在最后一个码字处消失,所以一个正确的实现带着两个阈值外加一个特例,而EarlyChange标记同时平移两个阈值。任何一侧差一个码字,你产出的输出在坏掉之前一切合法,任何地方都没有错误、没有异常,只是某个查看器在渲染噪点。诚实的边界是:这一切从内部都测不出来——你自己的测试套件里没有任何东西能区分正确流和一贯错误的流,所以互操作检查不是可选的加分项,它是你唯一能拿到的真证据。两个类都随PDF Library for Delphi发布,库还处理我们对象流和交叉引用流笔记里描述的周边结构工作,面向库所支持编译器版本下的Delphi和C++Builder