把一台 Windows 测试机切到德语区域设置,跑一个往页面前插缩放平移矩阵的例程,转储内容流。你看到的不是 0.5 0 0 0.25 0.00001 12.75 cm,而是 0,5 0 0 0,25 1E-5 12,75 cm。内容解析器把它读成数字 0,然后一个它不认识的 token ,5,然后更多再也对不上 cm 所期望的六个操作数的数字,页面带着一个你从没要求的变换渲染出来。机器要解析的数字需要固定的点号、无指数、完全不依赖 FormatSettings——写出端如此,读取端也如此
逗号小数区域为什么会弄坏 PDF 数字?
因为 Delphi 的默认浮点格式化跟随桌面,而 PDF 数字语法是固定的。FloatToStr 用 FormatSettings.DecimalSeparator,所以在 de-DE、fr-FR 或 pt-BR 机器上,每个小数都带着逗号出场。ISO 32000-1 §7.3.3 只允许数字里出现数位、一个小数点和前置符号,别的都不行。于是逗号把一个数字拆成一个合法整数加一堆垃圾,结果是一个能渲染、只是渲染错了的页面
第一个陷阱后面还藏着第二个,它在美式机器上也咬人。FloatToStr 用 ffGeneral 格式,数量级一旦低于 1E-4 就切到指数记法,很小的偏移被写成 1E-5。同一个 §7.3.3 声明 PDF 不支持指数形式。从渲染输出反推这两个问题中的任何一个都很折磨人:漂移的矩阵看起来完全像你自己代码里的布局 bug,页面上没有任何东西指向区域设置
PDFlibPas(losLab 的 Delphi PDF Developer Library)经 PLDoubleToStrConst 以六位小数写出 AddPageMatrix 的操作数,代你生成页面内容的调用点也守同一条规则。我们所知最便宜的回归测试,是在进程内把分隔符切成逗号、调 API、然后扫描结果里的逗号和指数:
uses
  System.SysUtils, PDFlibrary;

// 你自己的检查,不属于库。故意写得粗糙:
// 像 (Hello, world) Tj 这样的文本串也含逗号,所以请
// 在一个只画图形的测试页上运行
function HasLocaleDamage(const Content: AnsiString): Boolean;
var
  I: Integer;
begin
  Result := False;
  for I := 1 to Length(Content) do
  begin
    if Content[I] = ',' then
      Exit(True);
    if (Content[I] in ['E', 'e']) and (I > 1) and (I < Length(Content)) and
       (Content[I - 1] in ['0'..'9']) and (Content[I + 1] in ['0'..'9', '-', '+']) then
      Exit(True);
  end;
end;

var
  Lib: TPDFlib;
  OldSeparator: Char;
  Content: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetPageDimensions(300, 200);
    Lib.DrawBox(10, 10, 20, 20, 1);
    OldSeparator := FormatSettings.DecimalSeparator;
    try
      FormatSettings.DecimalSeparator := ',';   // 表现得像一台 de-DE 桌面
      Lib.AddPageMatrix(0.5, 0.25, 1E-5, 12.75);
      Content := Lib.GetPageContentToString;
      // 预期:0.5 0 0 0.25 0.00001 12.75 cm
      // FloatToStr 会产出:0,5 0 0 0,25 1E-5 12,75 cm
      Writeln(Content);
      if HasLocaleDamage(Content) then
        Writeln('Locale leaked into the content stream');
    finally
      FormatSettings.DecimalSeparator := OldSeparator;
    end;
  finally
    Lib.Free;
  end;
end;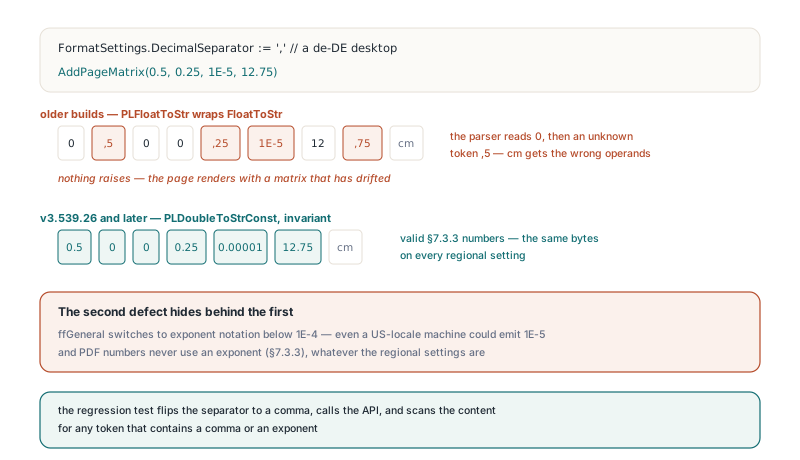
在进程内改 FormatSettings.DecimalSeparator 是条捷径。它没锻炼到那些从操作系统自建 TFormatSettings 的代码,如果你的应用就是这么干的,一台带真实德语区域设置的 CI agent 是更诚实的测试
两种数字,两族辅助函数
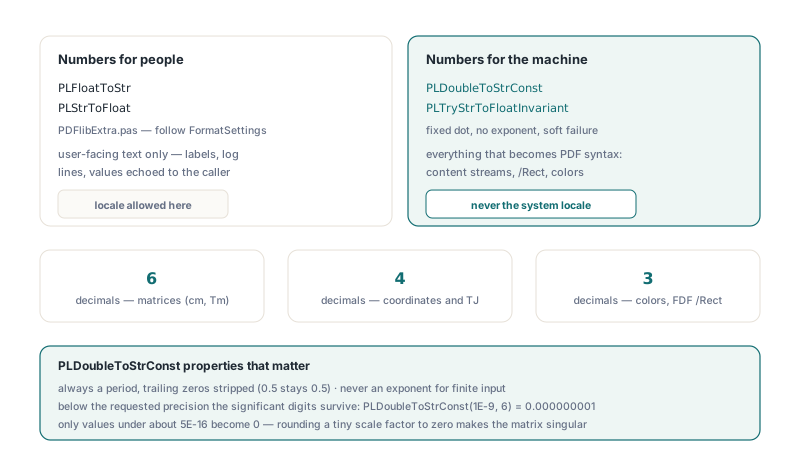
PDFlibPas 按受众拆分数字辅助函数:给人看的文本可以跟随区域,写给机器的任何东西永远不跟。PDFlibExtra.pas 里的 PLFloatToStr 和 PLStrToFloat 是 FloatToStr 和 StrToFloat 的薄包装,声明上的注释写明它们只用于人类可读的文本。机器输出(PDF、FDF、XFDF、JSON、XML、CSV)走 invariant 家族:写用 PLDoubleToStrConst,读用 PLTryStrToFloatInvariant,需要带点号小数的 TFormatSettings 记录来喂自己的 TryStrToFloat 时用 PLInvariantFormatSettings
精度按用途逐项选择而不是全局一刀切。矩阵六位,坐标和 TJ 调整四位,颜色和 FDF 矩形三位。机器侧覆盖的地方比 API 表面看起来的多:
AddPageMatrix、ScalePage和DeskewPage,它们都在既有页面内容前面插一个cm- 页面元素生成时写出的
Tm重置、TJ前进和cm变换 - 文字转路径时产出的字形摆放矩阵和轮廓点
RedactRegion前插的黑色填充框、FDF 导出里的/Rect值,以及重新着色写出的颜色操作数
PLDoubleToStrConst 是手工写的格式化器,我们认为这比用固定的 TFormatSettings 包一层 FloatToStrF 更对。ffFixed 在整数部分超出精度时仍会回落到科学记数法,而且会在 0.5 更短且等值的地方留下 0.500000。这套自定义例程总是写点号、剥尾零、对有限输入从不写指数。它还保留小于请求精度的非零值的有效数字:PLDoubleToStrConst(1E-9, 6) 返回 0.000000001,只有大约低于 5E-16 的值才变成 0。把微小的缩放因子舍成零,会把合法矩阵变成奇异矩阵——这比任何放错位置的小数点都糟
给格式化器写单元测试时,挑样本值要想着二进制浮点。“四位有效数字”的显而易见之选是 0.000012345,但这个 double 乘上 1E8 是 1234.4999…,所以结果是 0.00001234,断言因为一个与区域毫无关系的理由失败。取一个明显偏离中点的值,比如 0.000012346,这场争论就完全不会发生:
uses
  PDFlibExtra;

// Assert 调用是你在自己的测试工程里加的检查
procedure CheckNumberHelpers;
var
  V: Double;
begin
  // 机器输出:点号小数、无指数、剥掉尾零
  Assert(PLDoubleToStrConst(1E-5, 6) = '0.00001');
  Assert(PLDoubleToStrConst(-0.5, 6) = '-0.5');
  Assert(PLDoubleToStrConst(0.000012346, 4) = '0.00001235');  // 保留 4 位有效数字
  Assert(PLDoubleToStrConst(12345.25, 4) = '12345.25');

  // 机器输入:返回 False 而不是 EConvertError
  Assert(PLTryStrToFloatInvariant('0.5', V) and (V = 0.5));
  Assert(PLTryStrToFloatInvariant('  12.75 ', V) and (V = 12.75)); // 输入会先裁掉空白
  Assert(not PLTryStrToFloatInvariant('0,5', V));   // 内容数字从不用逗号
end;
为什么解析端比写出端更危险?
解析端更危险,因为绑定区域的解析器不会产出一个略错的数字——它直接抛。StrToFloat 在文本不匹配系统分隔符时抛 EConvertError。建立在它之上的重新着色过程,一碰到逗号小数机器上普通的 0.5 g 操作符就会中止,等于在几乎所有真实页面上都失败。像 "10.5,20.5,50.5,40.5" 这样的裁剪串会被直接拒绝,SVG 长度、SVG 颜色、注释顶点列表和 output intent 值要么被拒、要么被默认值悄悄顶替。这是在开发者机器上通过全部测试、在慕尼黑第一位客户那里就挂掉的代码——与 碰巧能跑的 Delphi 代码一文 里的案例同属一族
库里每一处 StrToFloat 风格的调用都按输入来源分类。内容流操作数、SVG 属性、painter 颜色串、逗号分隔的裁剪与顶点列表都有固定的点号语法,所以它们走 PLTryStrToFloatInvariant。这个辅助函数裁掉空白、用 PLInvariantFormatSettings 解析,空、畸形、NaN 或无穷输入返回 False(值置 0)。逗号分隔的列表毫无争议:逗号不能既是列表分隔符又是小数点,所以也没有需要兼容的历史形态
对 把 PDF 转到单一色彩空间的指南 里讲的重新着色管线,结果是 RecolorPage 和 RecolorDocument 在任何区域上解析页面内容的行为一致。调用者敲进 CheckDocumentPolicy 的规则值是唯一走宽松路线的解析场景,因为那个字符串是人敲的,很可能用的是本地小数点
经字符串中转的数字需要两端说同一种话
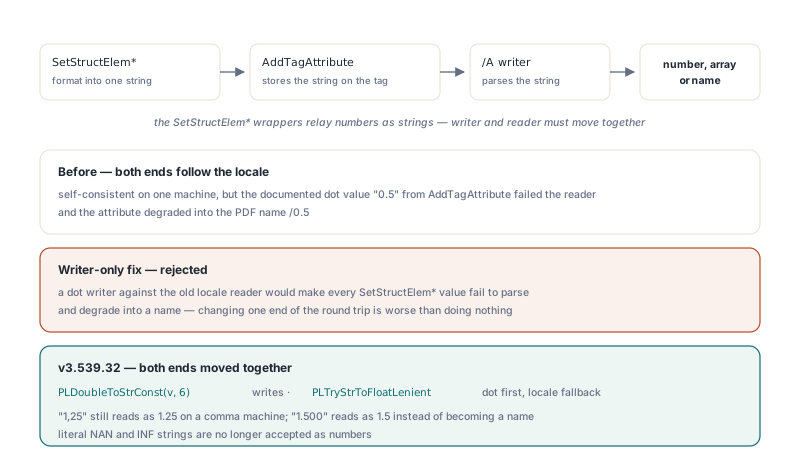
一个数字由代码的一部分写进字符串、由另一部分解析回来时,写出端和读取端必须遵守同一约定,只改一头就会弄断往返。带标记的 PDF 结构属性正是这么工作的。SetStructElemBBox 把四个值格式化进一个字符串,经 AddTagAttribute 存起来。写出 /A 属性字典时,这个字符串再被解析一次,以决定它成为数字、数组还是名称
如果两端都跟随系统区域,在德语机器上往返是自洽的。麻烦始于一个照文档传 "0.5" 给 AddTagAttribute 的调用者:绑定区域的读取端解析不了,吐出 PDF 名称 /0.5。PDF/VCR 占位符撞上镜像版的问题,因为它们的 GTS_BBox 用点号生成,保存前一步绑定区域的校验会拒绝它。而只把写出端换成点号更糟,因为每个 SetStructElem* 值都会在逗号小数系统上变成名称
所以写出端用 PLDoubleToStrConst(v, 6),读取端用 PLTryStrToFloatLenient:先试点号形式,再回落系统区域。传 "1,25" 的逗号区域调用者得到数字 1.25。有一个代价,我们是知情接受的:在德语系统上 "1.500" 读作 1.5 而不是一千五,因为点号形式优先。API 把点号记载为分隔符,所以属性串里德语式的千位分组是我们选择放弃的输入。字面的 NAN 和 INF 字符串不再被当作数字
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
begin
  FormatSettings.DecimalSeparator := ',';   // 逗号小数的调用方
  Lib := TPDFlib.Create;
  try
    Lib.BeginTag('Figure', 'Sales chart', '');
    Lib.SetStructElemBBox(10.5, 20.25, 200.5, 100.75); // /BBox [ 10.5 20.25 200.5 100.75 ]
    Lib.AddTagAttribute('Layout', 'SpaceAfter', '0.5');   // /SpaceAfter 0.5 而不是 /0.5
    Lib.AddTagAttribute('Layout', 'StartIndent', '1,25'); // /StartIndent 1.25,经区域回落
    Lib.DrawText(20, 20, 'figure');
    Lib.EndTag;
    Lib.SaveToFile('tagged.pdf');
  finally
    Lib.Free;
  end;
end;
对你自己的代码,我们的建议是给 AddTagAttribute 传点号小数字符串,把逗号回落留给你控制不了的值,比如从旧配置文件加载的字符串。这些属性周围的结构树如何构建,见 带标记 PDF 结构指南
NaN 和无穷大在哪里被拦下
AddPageMatrix、ScalePage 和 RedactRegion 在前门就拒绝 NaN 和无穷参数并返回 0,因为没有哪个 PDF 数字能表示它们。这个检查必须显式。NaN 能溜过 <= 0 测试,所以只对缩放因子做范围检查,会让 NaN 缩放一路走到格式化器,而在 Win32 上对 NaN 调 Round 会抛 EInvalidOp——x87 单元默认不屏蔽非法操作。PLDoubleToStrConst 对 NaN 写 0 是最后一道防线,但矩阵里的零是奇异变换,所以真正保护页面的是 API 层的检查。在你自己的代码里,请测试返回值:当 ScalePage 对你算出的因子返回 0 时,先把因子打印出来再说别的,因为上游某处的 0/0 产出的正是这种 NaN
两处边界是刻意保留的。元文件状态串在一个进程内用区域读写、从不落盘,所以保持绑定区域。如果你经页面生成路径测试小值,调完立即读内容:之后按文档坐标精度重新发出页面内容的操作会合法地把 1E-5 变成 0,那是舍入,不是区域泄漏
值得养成的习惯很短:用逗号分隔符跑一遍应用里所有产出 PDF 的路径,扫描输出里的逗号和指数,把 FloatToStr 挡在任何解析器要读的东西之外。从既有文件读出的数字遵循一条相关规则,见 保留解析出的十进制精度一文,那里讲原始文本如何在保存后幸存。试用版、API 参考和授权细节都在 PDFlibPas Delphi PDF library 产品页