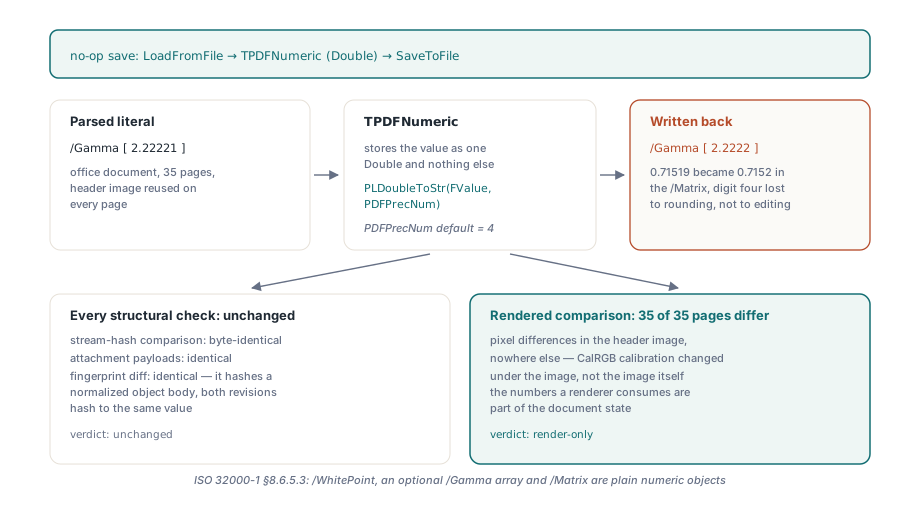
加载一份做过色彩标定的 PDF,什么都不改,换个名字存一遍,再对比颜色空间字典:进去的是 /Gamma [2.22221 2.22221 2.22221],出来的是 /Gamma [2.2222 2.2222 2.2222]。写入器重新格式化了一个它根本不必碰的数字,页面从此以略有不同的颜色渲染。药方是把每个解析出的小数同时当作两样东西——用于算术的值和用于输出的原文——只要没有人真正赋新值,就一直输出原文
为什么一次什么都没改的保存能让 CalRGB 颜色挪位
像素挪位,是因为图像字节原封不动,渲染器拿到的标定数据却略有不同。ISO 32000-1 §8.6.5.3 用一个必需的 /WhitePoint、一个可选的三元素 /Gamma 数组和一个可选的九元素 /Matrix 定义 CalRGB 颜色空间,它们都是颜色空间字典里的普通数值对象。把这些塞过一个 Double 再用一个固定四位小数的格式化器输出,2.22221 变成 2.2222,一个矩阵元素 0.71519 变成 0.7152。Gamma 值是作用在该空间上每个像素每个分量上的指数,所以哪里用到这个空间,变化就在哪里显形
如果一个文件只为一张在 35 页上复用的页眉图声明了一个 CalRGB 空间,那 35 页页眉全部以偏移的颜色渲染,而这些页面上其余一切纹丝不动。人们最先伸手去用的那些检查全部回报干净。解码后流字节的哈希比较的是图像数据,图像数据确实一个字节都没变;损伤住在字典里。修改层级一文描述的修订比较,取的是规范化对象体的指纹,于是两个修订在那里也哈希到同一个值。能抓住它的,是逐页渲染比较。对任何要重写别人产出的 PDF 的管线,我们会把逐页渲染比较放在一切结构检查之前
PDF 实数可以长什么样
ISO 32000-1 §7.3.3 把实数定义为十进制字符串:可选的符号、数字、小数点、更多数字。没有基数记法,没有指数形式。列出实现限度的附录 C,期望小数部分大约五位有效十进制数字得到尊重。默认四位小数的输出精度因此已经比规范要求阅读器保留的少一位,而文件用足五位没有任何错
接近零时,朴素格式化器干的不只是丢一位。按 N 位输出 Double 的常见做法是乘 10^N、四舍五入成整数、再写出数字;整数是零时,输出就是 0。把 0.00001 0 0 1 0 0 cm 的第一个操作数按四位交给它,结果是 0 0 0 1 0 0 cm——一个奇异矩阵,画在它下面的东西全部消失。-0.000012345 的 /Matrix 元素同样如此
当 PDF Library for Delphi(PDFlibPas)不得不亲自格式化一个 Double 时,对小于精度步长的非零值,它保留所要求的有效数字位数而不是写 0。四位下,0.00001 写成 0.00001,0.0000123 写成 0.0000123;只有大约 5E-16 以下的量级仍输出 0。这样新写的数字是健全的。而一个从不需要重新格式化的解析数字是另一回事,库的处理方式是根本不格式化它
PDFlibPas 如何留住它解析到的原文
TPDFStructure.Decode 为它分词出的每个标准实数——即带小数点且无指数标记的 token——保留源文本,就放在转换后的 Double 旁边。TPDFNumeric.Output 只要那段文本在,就把它写回去;只有在没有时,才按结构的 PDFPrecNum 格式化 Double。TPDFNumeric.SetTo 丢弃那段文本,因为被编辑过的数是一个新数,应当服从当前的输出精度
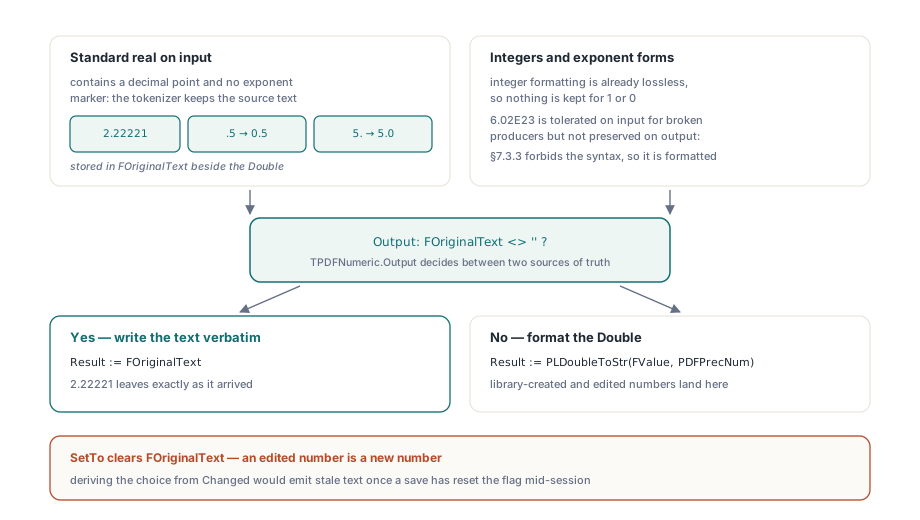
把清空绑在 SetTo 上是刻意的。诱人的捷径是:除非对象的 Changed 标志已设置,否则输出原文——毕竟每个对象上都有这个标志。可是保存管线在对象写出后就会清掉 Changed,于是一个被编辑、保存、又在同一会话里再次编辑的值,会在第二次保存时重新开始输出过期的原文。在赋值本身内部清空文本,原文和值就永远不可能不一致
有几条边界是刻意的。整数不以文本保存,因为整数的格式化本来就无损。像 6.02E23 这样的指数形式在输入时接受——照顾那些反正会这么写的生产者——但输出时按任何库生成数字一样格式化,因为照抄回去会让 §7.3.3 排除的一种语法一直延续。分词器在存文本之前也照例做它的小小修复:像 .5 这样前导点的原文保留为 0.5,像 5. 这样尾随点的原文保留为 5.0。每一对在每个读取器眼里都是同一个数,而修复后的写法被接受的范围广得多
下面的代码把那些 CalRGB 值直接跑过对象层,不用打开 PDF 文件就能看清每条规则。Assert 行是我们建议加进你自己测试里的检查,它们不是对库的调用
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // 你自己的检查:未编辑的输入原样存活,包括
    // 朴素四位格式化器会塌成 0 的那个值
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // 一次编辑丢掉原文,改循 PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // 极小的新值保留有效数字而不是变成 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // 事后降低精度碰不到未编辑的输入
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
写这类断言时有一个陷阱:Delphi 的 Round 用银行家舍入,而 0.000012345 * 1e8 在二进制里算出来是 1234.4999… 而不是 1234.5。检查近零格式化路径时我们正好撞上这个值。断言结果取决于末位如何舍入时,选不是二进制中点的测试输入
SetPrecision 控制什么?
TPDFlib.SetPrecision 设定库所写数字的小数位数:经 painter 绘制的图形、从 Double 创建的数字(比如经 NewNumeric),以及之后被 SetTo 改过的解析值。它接受 2 到 8,范围外一律返回 0。没人编辑过的解析小数无论设置如何都保留输入文本,LoadFromFile 之后改设置也不会回溯波及它。传给 SetObjectFromString 的源走同一个分词器,同样被保留
我们的建议是:除非你生成的几何需要更细的步长,否则别动 SetPrecision。为了保护输入文件而调高它毫无收益——未改动的输入本来就留着自己的数字——反而让你画的每个数字都变长。亚磅级绘图用五位是合理选择;八位多半只是在撑大内容流
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // 管辖从这里开始写出的数字;解析出的 /Gamma、
    // /Matrix 和 /WhitePoint 数组保留原文
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // 画出的数字用五位
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
内容流:编辑保留操作数,规范化是可选项
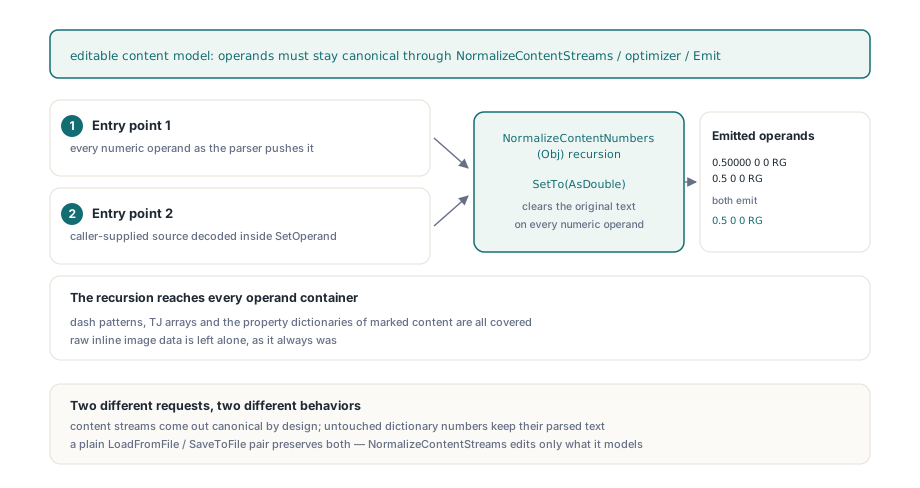
可编辑内容模型默认保留操作数文本,只有当规范化输出本身就是这次调用的目的时才规范化数字。TPDFContentProgram.CanonicalNumbers 默认 False,所以 ParsePageContentLayer 返回的层——图形状态跟踪器所建的同一模型——会把每个未触碰的数值操作数按原样重新发出。重写整层的页面编辑,包括 ScalePage、TransformPageElement、DeletePageElement、RedactRegion、ConvertTextToPaths 以及用 WritePageContentLayer 写回的你自己的程序,只改动编辑碰到的操作数
另一种默认看起来更整洁:每次解析都规范化,让编辑路径与 NormalizeContentStreams 永远产出同样的写法。我们认为对编辑而言这是错误的默认。对一个含 0.123456 w 的层调 ScalePage,会写回 0.1235 w,层里其他所有操作数也被重写——尽管调用方只要求缩放。规范化形式属于那些目的就是产出可比较输出的操作
那些操作照样拿得到规范化。NormalizeContentStreams 和保存期的内容优化器以 CanonicalNumbers 设为 True 解析,它们的职责就是从任意输入产出稳定输出;如果 0.50000 0 0 RG 和 0.5 0 0 RG 输出得不一样,下游每一次比较都会随生产者的格式化习惯漂移。规范化会递归穿过数组和字典,虚线样式、TJ 数组和标记内容属性字典都在覆盖范围内,原始内联图像数据则不动。经 SetOperand 提供的操作数无论标志如何都被规范化。内容程序自带一个固定四位的数字存储,独立于 SetPrecision,所以被编辑的操作数以四位输出。只有 Parse 读这个标志,意味着必须在解析之前设置;对 ParsePageContentLayer 已解析完的程序,设好标志再调 Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // 改一处线宽;其余操作数保留源文本
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // 输出为 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // 仅为比较而做的规范化副本,不写回:
      // Parse 是该标志唯一的读者,设置后要重新解析
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // 现在 Prog.Emit 对 0.50000 和 0.5 的写法一致
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
合起来,调用方的规则很短。一次普通的 LoadFromFile 接 SaveToFile,未触碰的内容流和未触碰的字典数字原样保留。经内容模型编辑过的页面,保留编辑没有改到的每个操作数的文本。NormalizeContentStreams、保存时内容被压缩时运行的优化器,以及以 CanonicalNumbers 设为 True 解析的任何程序,按设计产出规范化数字,文档其余部分仍然保留
代价是什么,保证到哪里为止
每个 TPDFNumeric 多带一个 AnsiString 引用,每个解析出的小数让它的源文本活到对象生命期结束。在有数百万实数的文档上,这是可测量的内存,应当算进你跑的任何大文档基准。这个保证也只限于数字自己所在的文档。跨文档复制对象、或经对象 API 重建值,产出的都是新数字,新数字服从输出精度
保住的数字与逐字节相同的输出是两个独立属性。对未触碰文档的加载再保存,保住渲染器消费的标定数字;但字节同一性还取决于对象编号、流压缩,以及确定性 PDF ID 一文讨论的 trailer 标识符。指纹比较仍然对规范化后的对象体取哈希,这意味着其他工具写出的文件里的舍入差异落在它的比较范围之外;渲染比较仍是抓这些的检查
数字处理与 SetPrecision 的确切语义都写在losLab PDF Developer Library 的参考文档里,上面用到的内容模型调用也在其中