这是手写 JBIG2 读取器在遇到的第一个不寻常文件上就会犯的错。它解析文件头,解析第一个段头,读出四字节数据长度,然后把那么多字节当作段体。在大多数 .jb2 文件上这完全正确。而在标志字节第 0 位清零的文件上,那些“段体”字节其实是第二、第三、第四个段头,算术解码器把它们变成一张噪声位图,或一路冲出缓冲区末尾。文件没有坏。它用的是 ITU-T T.88 附录 D.2 的随机访问组织:每个段头排在最前,所有段数据按同样顺序跟在后面
随机访问文件很少见。它们出自归档与文档影像系统——这些系统想让阅读器在碰任何压缩字节之前,先看到每一页和每个字典依赖。如果一个转换作业把这种来源的文件与普通扫描件混在一起,一个随机访问文件就可能落在一批几乎全是顺序文件的中间。读它们的解码器,与处理JBIG2 自定义 Huffman 表与规范前缀码的是同一个原生 Pascal 解码器,编码侧没有任何变化;变化的只是段被找到的顺序
一个标志字节背后的三种文件布局
PDF Library for Delphi 经 PDFlibJBIG2 单元里的 TPLJBIG2Decoder 读取独立 JBIG2 文件,解码器自行从文件头判断布局。T.88 附录 D 允许同样的段有三种排法:顺序式(D.1)把每个头直接放在自己的数据前面,随机访问式(D.2)把所有头放最前、所有数据放其后,嵌入式(D.3)是无头形式,用在其他容器内部。独立文件以八字节标识 97 4A 42 32 0D 0A 1A 0A 开头,随后一个标志字节,再跟一个四字节页数——除非标志说页数未知
标志字节的第 0 位选择组织方式:1 是顺序,0 是随机访问。第 1 位置位表示页数未知、四字节计数缺席,于是第一个段头从字节 9 开始而不是字节 13。第 2 到 7 位是保留位;解码器接受置了这些位的文件而不是拒绝它们,因为一个游离的保留位说明不了段本身可不可读
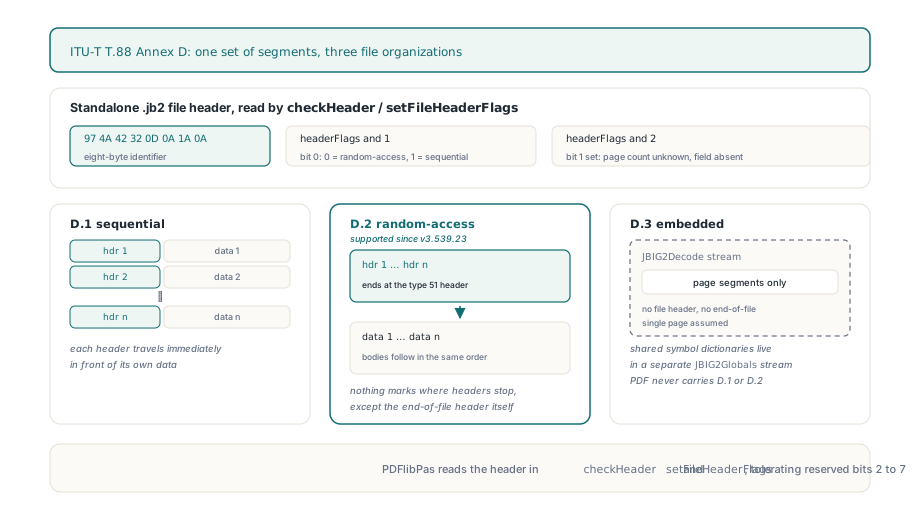
PDF 本身从不携带随机访问布局。ISO 32000-1 §7.4.7 描述的 JBIG2Decode 图像流只以嵌入式承载页面段,共享符号字典移进单独的 JBIG2Globals 流,且没有文件头、页结束或文件结束段。解码器找不到八字节标识时,就把输入当作恰好那种流:顺序、单页。反方向,PDF Library for Delphi 把 JBIG2Decode 图像导出为原生 .jb2 文件时,写标志字节 $03(顺序、页数未知)并追加一个文件结束段头。所以随机访问永远只从外部到来——作为直接交给 TPLJBIG2Decoder 的独立文件,通常正准备经PDFlibPas 的 JBIG2 编码器后端转换或重压缩为 PDF
为什么不能按文件顺序读随机访问文件?
因为字节流里除了文件结束段头(类型 51)自身,没有任何东西标记头块在哪里结束、数据块从哪里开始。JBIG2 段头没有固定大小:被引用段数要么是三位短形式,要么是长形式后跟保留位图;每个被引用段号按当前段自身号的大小占一、二或四字节;页关联字段是一字节或四字节。读取器必须解析一个头的每个字段,才能知道下一个头从哪里开始
按文件顺序行走的顺序式读取器,第一个头读对,其后全错。更糟的是它可能一时半会儿察觉不到:喂给通用区域解码器的段头字节产出的是像素而不是错误,直到某个更晚的长度或引用检查终于绊住。我们的看法是:不先索引头的解码器,就该断然拒绝随机访问文件。明确的拒绝只损失批里一个文件;一张看似合理却错误的位图可能进归档并一直待在那儿
在第一个段体之前索引每一个头
标志字节说是随机访问时,PDF Library for Delphi 在解码任何东西之前先对头块走一遍。每个头被完整解析然后丢弃,唯一留下的是它在文件里的字节偏移。压缩数据从不复制进重排过的第二缓冲区——在大型归档扫描件上这很要紧,那种文件的数据块可能占掉文件的大部分。这一遍在第一个文件结束头处停下,此时读位置正落在第一个段数据的首字节上
随机访问文件的冗余比顺序文件少,所以预扫描是严格的。它在以下情形拒绝文件:
- 某个头被缓冲区末尾截断——报告为
JBIG2 truncated random-access header at byte N,带该头起始处的偏移 - 段号不严格递增(按无符号值比较),因为两个声明同一编号的头会让后面区域的被引用列表变得含糊
- 某个数据长度最高位置位——包括
0xFFFFFFFF的“未知长度”标记;这种布局里没有别的办法找到下一个段体的起点,解码器立即拒绝而不是向前扫描结束标记 - 文件结束头声明了任何数据,或根本没出现(
JBIG2 random-access file is missing its end-of-file header) - 声明长度加起来多于剩余字节,或少于剩余字节
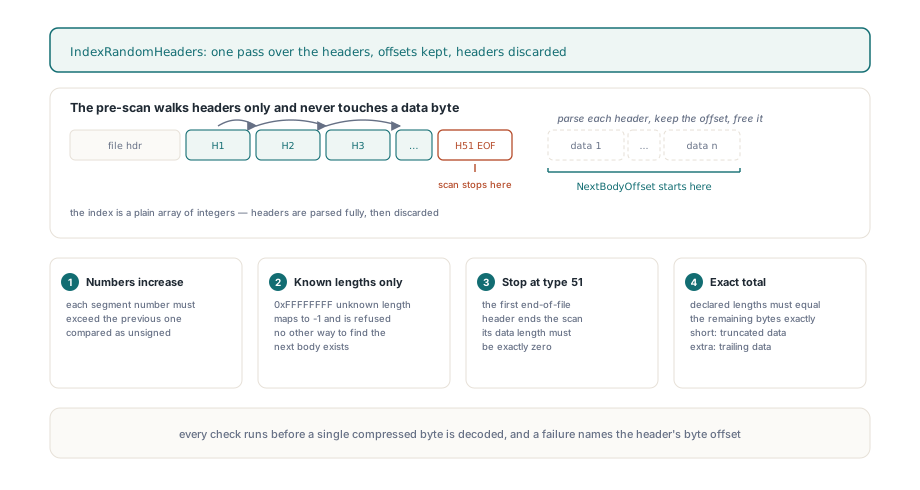
最后一条规则是最容易绊倒人的。最后一个段体之后多出区区一个字节,就以 JBIG2 trailing random-access data 失败。对比顺序路径——解码停在文件结束段,其后的一切被忽略——这显得苛刻。不对称有它的理由。顺序布局里每个头紧挨自己的数据,末尾的垃圾不可能挪动任何东西。随机访问布局里,头是数据块的唯一地图;长度对不上时,解码器无法区分无害的填充和一个更早丢失或多出的字节——后者会把其后每个段体全部挪位
按字节计数的循环为什么会丢掉最后一个页结束段?
“只要还有字节就继续”的循环,在随机访问文件上会过早结束,因为数据比头索引用得更早耗尽。页结束(类型 49)和文件结束段不带任何数据字节,通常排在最后。最后一个区域段体被消费完,读位置恰好落在缓冲区末尾;按字节计数的循环在那里退出,零长度的页结束段永远得不到分发,页面就此没有收尾
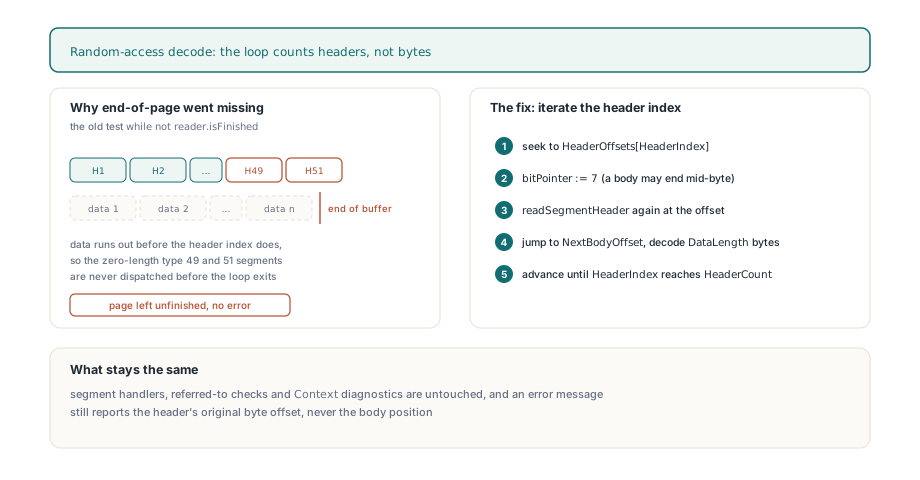
所以对随机访问文件,解码器数的是头,不是字节。每一步跳回下一个已索引的头,重新对齐字节边界(算术编码的段体可能停在字节中间),再次解析头,然后向前跳到下一个段体开始处,按声明长度越过它。提前完成的段体直接跳到其声明末尾;越过声明末尾去读的则被拒绝。从这里开始,段走进与顺序文件相同的处理器和引用检查。解码段体时抛出的错误带上头的原始位置,形式为 JBIG2 segment N (type T) at byte B: ...,LastError 里的偏移因此指向你在十六进制编辑器里能找到的东西
在 Delphi 里加载随机访问的 .jb2 文件
应用代码不随组织方式变化。TPLJBIG2Decoder.LoadFromByteArray 检测文件头和布局,拒绝任何输入时返回 False 并把原因放进 LastError,经 Width、Height 和 GetScanline 暴露解码出的页面——每像素一字节,黑为 1
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // 顺序与随机访问的独立文件走同一个调用
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
想知道某个文件用的是哪种布局——为了记日志,或在转换作业前给语料分拣——自己去读那个标志字节即可。库不暴露它检测到的组织方式,而你也只需要九个字节。下面的辅助函数是加到你自己的代码里的东西;它只是把 T.88 的头规则复述了一遍:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// 你自己的辅助函数,不属于 PDFlibJBIG2:按 T.88 文件头给缓冲区分类
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // 例如从 PDF 里取出的嵌入式流
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // 第 1 位置位:没有四字节页数
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
批处理作业:填充缓冲与被拒文件
尾部数据规则正是批处理代码容易出错的地方;当一份在别处能打开的文件被这样拒收时,先看缓冲区,再看文件。从数据库 BLOB 列取出的 .jb2、固定大小的网络读取、带对齐填充的容器格式,都可能在真实末尾之后带几个零字节。顺序文件对此耸耸肩;同样填充的随机访问文件则以 JBIG2 trailing random-access data 失败,被截短几个字节的缓冲区同样失败——报成截断。传递的字节要与文件的字节完全一致,按来源的真实长度取大小,绝不按块大小或容量
被拒的文件也不留任何残余。LoadFromByteArray 在开始解码之前先重置 Width、Height 和扫描线,所以一次失败的调用报告零尺寸而不是上一个文件的页面,同一个解码器实例可以直接接着处理下一个文件:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // 此处 Width 和 Height 为 0;上一个文件的任何东西都不残留
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // 怪文件之前,先查查字节是怎么存的
      end;
  finally
    Decoder.Free;
  end;
end;
在自己的管线里验证这些不需要稀有样本文件。把一份顺序 .jb2 重组成随机访问布局,保留每个头和每个压缩字节,把页结束与文件结束头移到头块末尾,解码出的像素必须与顺序原版完全一致——带页数字段与不带都要测。然后依次喂给它每种截断前缀、重复的段号、一个多余的尾部字节和一个 0xFFFFFFFF 长度;每一种都应返回 False 且 Width、Height 为零
解码器返回什么,又期待什么
这里的随机访问是文件布局的属性。无论文件用哪种组织,TPLJBIG2Decoder 返回的都是第一页的位图,Width 和 Height 描述的也是那一页。每个段都必须声明自己的数据长度;T.88 允许立即通用区域使用 0xFFFFFFFF 标记,解码器在两种布局里都拒绝该标记,报 unknown or oversized segment length is not supported。自定义 Huffman 前缀长度和表项数量的上限与顺序文件一致
解码 JBIG2 只是更长图像路径中的一站,那条路径还覆盖 PDF 图像提取、重压缩与 JBIG2 编码;PDF Library for Delphi 产品页覆盖该管线的其余部分和受支持的图像格式