把一个 JBIG2 Tables 段(类型 53)逐字节摊开,第一个意外是它省掉了什么:Huffman 码本身。你拿到的是一个 flags 字节、两个边界和一串小数字,而这些数字是码长。编码器和解码器都用 ITU-T T.88 附录 B.3 的流程从码长重建真正的位模式。重建顺序稍差一点,你得到的仍是一张合法前缀码,每个模式仍能解码,但每个值都挂在了错误的模式上
在一页用 Huffman 符号 ID 加编码器自带表编码的页面上,这种错位看起来像扫描质量差:字形偏移几个像素、字符由错误的符号拼成,或者数字看着都对,直到几个段之后某个宽度超出范围。PDF 里的 JBIG2 大多是算术编码,Huffman 编码的 JBIG2 又大多守着标准表 B.1 到 B.15。自带表的文件少见,而它们往往把表解析器、Huffman refinement 和未压缩集合位图一口气全考一遍
Tables 段里实际装着什么
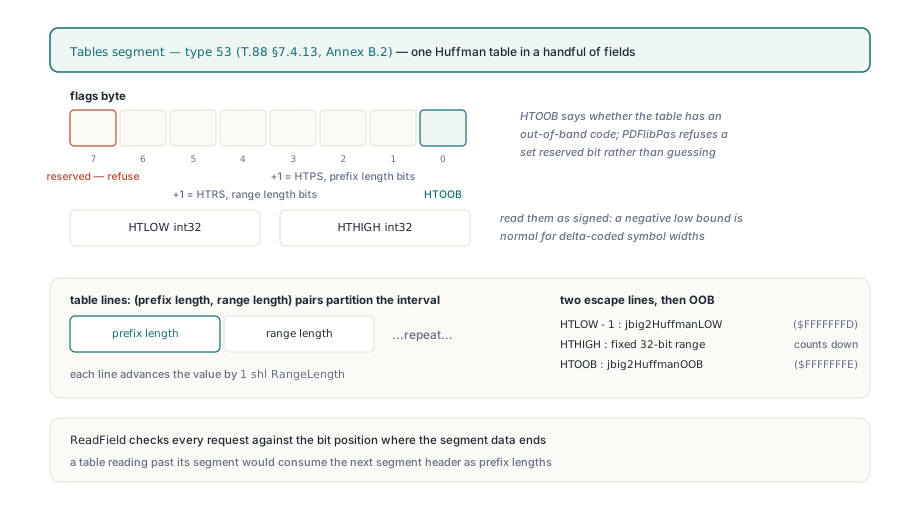
一个 Tables 段恰好描述一张 Huffman 表。T.88 §7.4.13 和附录 B.2 把它铺成一个 flags 字节、一个有符号 32 位 HTLOW、一个有符号 32 位 HTHIGH,然后是若干(前缀长度,范围长度)对,把从 HTLOW 到 HTHIGH 的区间铺满。flags 第 0 位是 HTOOB,说明表有没有带外码;第 1 到 3 位加一得 HTPS,即每个前缀长度字段的宽度;第 4 到 6 位加一得 HTRS,即每个范围长度字段的宽度;第 7 位保留
边界是手写解析器第一处容易栽倒的地方。把 HTLOW 当无符号读,一张从 -2 开始的表——对增量编码的符号宽高来说再普通不过——会突然声称从四十三亿附近开始。PDF Library for Delphi 把两个边界都按有符号读,拒收 HTLOW 不小于 HTHIGH 或范围长度超过 32 的表,并把每一次字段读取都对准段声明数据结束的那个位。最后这条检查比听上去要紧:读过自己段末尾的表,会把下一个段头当成前缀长度吃掉,解析出一堆彻头彻尾的胡话。第 7 位置位则以 reserved custom Huffman table flag 失败。我们宁可拒收也不猜,因为猜出来的表产出的是没人能追溯到原因的错误像素
常规行之后是附录 B.2 的转义行。低端范围行从 HTLOW 减一开始、以 32 位偏移向下数;高端范围行从 HTHIGH 开始、带 32 位范围;带外行只在 HTOOB 置位时存在。这些行携带与内置标准表相同的标记,所以自定义表和表 B.6 走同一个解码循环。一张自定义表最多 65,536 行
为什么前缀码必须按表行顺序分配?
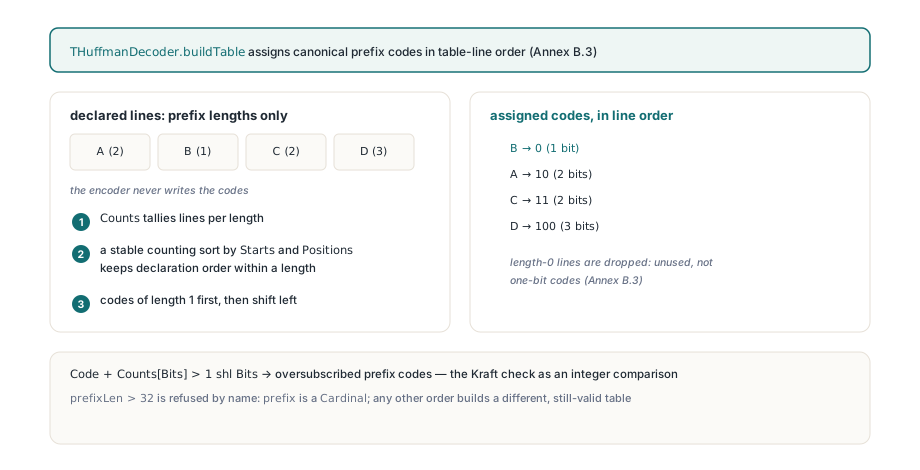
因为声明顺序是把位模式拴到值区间上的唯一东西。附录 B.3 先统计每种前缀长度各有多少行,先发长度为 1 的码,左移进入长度 2,依此类推;同一种长度内部,码按各行在段里出现的顺序发放。一张小表可以说清这件事:六行,按文件顺序标成 A 到 F,前缀长度如下
| 行 | 前缀长度 | 码(保持文件顺序) | B 与 D 对调后的码 |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | 未使用 | 未使用 |
两列都是合法前缀码。只有左列是编码器的意思:B 与 D 一对调,模式 100 就解出 D 的值区间,解码器拿着一个来自错误区间的数字继续往下走。行 F 长度为 0,B.3 定义为未使用;要是给它一个一位码,后面每一次分配都会移位
想得到右列很容易:按前缀长度来一次通用排序。Delphi 的 TArray.Sort 和 TList<T>.Sort 都不稳定,相同长度的行回来时什么顺序都有可能。在你自己的工具里要规范码,就按长度逐档、每档按文件顺序走一遍:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // 按 Tables 段读入的值
    Code: Cardinal;       // 在下面分配
  end;

// 附录 B.3 规范分配,写给你自己的工具。
// 相同长度保持文件顺序;长度 0 不分码。
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft 检查:码数超过该长度所能容纳
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // 文件顺序做平局裁决
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
把上面六行喂给它,A 得 00,C 得 01,B 得 100,D 得 101,E 得 110;F 没有码。PDF Library for Delphi 用一趟计数做同样的事,构造上就稳定,也免去把表扫 32 遍,并施加同样的两道守卫。超额的码长以 oversubscribed Huffman prefix codes 失败;放过去,一个模式就能匹配两行。超过 32 位的前缀同样点名失败,尽管 T.88 纸面上允许。我们认为这道上限是正确的取舍:每个码装进一个机器字,而需要更长码的文件,更可能是坏了而不是聪明
值需要同样的小心。低端范围行解出的是 HTLOW 减一再减一个 32 位无符号偏移,用 32 位 Integer 做中间量,这个减法会回绕成一个看似普通的正宽度。解码器用 64 位计算,真结果装不进有符号 32 位范围时抛 Huffman value exceeds signed integer range
选择符顺序,以及两个互相打掩护的陷阱
文本区域或符号字典不点自己的表的名,它携带的是两位选择符,每个设为自定义的选择符按引用顺序取被引用段列表里的下一个 Tables 段。T.88 §7.4.3.1.2 给文本区域选择符定的顺序是 FS、DS、DT、RDW、RDH、RDX、RDY 和 RSIZE;§7.4.2.1.1 给符号字典定的顺序是 DH、DW、BMSIZE 和 AGGINST。值 0 和 1 选标准表,3 选自定义,2 在只有两张标准表的字段上保留。PDF Library for Delphi 拒收保留的选择符值,并在选择符要的自定义表多于区域所引用的数量时以 missing custom Huffman table reference 失败
自己写解码器的话,这里有两个容易犯的错误,而且彼此掩护。第一个在 Delphi、或 Delphi 模式下的 FPC 上咬人(objfpc 模式直接以重复标识符拒收这段代码):一个 setter,其参数与字段同名。参数遮蔽字段,Flags := Flags 变成自己赋给自己,字段保持为零。于是每个选择符都读出零,文本区域不管文件要什么,一律把标准表 B.6、B.8 和 B.11 用在 FS、DS 和 DT 上,自定义路径从未运行
第二个藏在符号字典里。Huffman 字典可以把符号存成未压缩集合位图(BMSIZE 为零),每一行都以残缺字节收尾。填充值是那个字节里有效位的个数,而人们很容易把它读成最低有效位的位置:
// 集合位图某一行的最后一个字节,位按 MSB 在前读取。
// Padding := TotalWidth mod 8  -> 本字节里有效位的个数

// 错误:把 Padding 当成要拷贝的最低位下标
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// 正确:最低有效位下标是 8 - Padding(Padding = 0 时为 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel 代表你自己解码器里任何写像素的代码
算一下边界宽度。63 像素的行填充是 7:错误的循环拷贝最后一个字节的 1 位,正确的循环拷 7 位。9 像素的行填充是 1:错误的循环拷 7 位,正确的拷 1 位。64 像素时两者都拷全部 8 位,所以 8 的倍数永远暴露不了它。7 像素和 9 像素宽的合成集合位图把字节边界两侧都钉住。损坏还会传染,因为 refinement 拿这些符号当引用
自己的解码器两个陷阱都有时,调试会变得凄惨:只修 setter,自定义路径终于跑起来,一头撞进坏掉的集合位图,页面照样不对;只修填充,可见的变化一点没有,因为自定义路径仍然走不到。两处都要用合成输入验证过再信。一个相关细节:Huffman 符号字典的输入符号与新符号加起来为一时,log2 公式给出的符号码长度是 0,但 Huffman 变体给每个符号 ID 至少写一位。PDF Library for Delphi 在 Huffman 模式下把该长度提到 1
Huffman refinement 从哪里读它的位图大小?
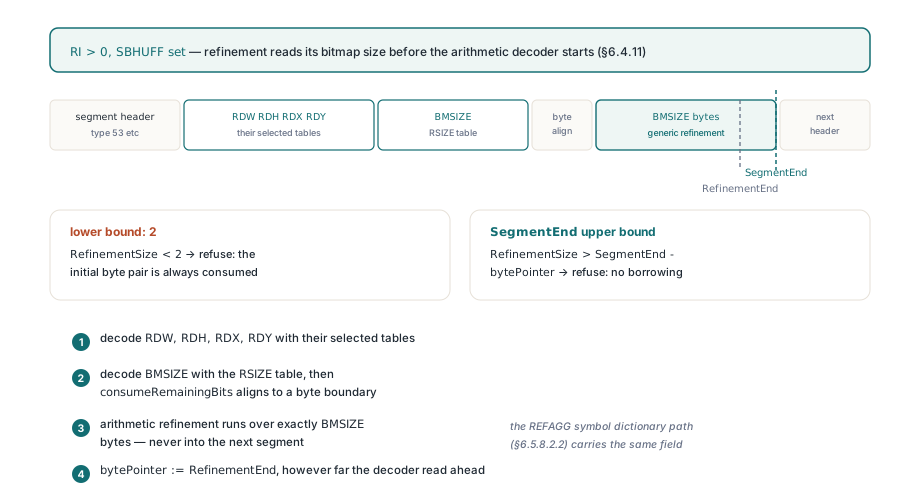
来自一个只在 Huffman 模式下存在、且先于算术 refinement 数据解码的 BMSIZE 字段。文本区域实例带 refinement(RI 非零)且 SBHUFF 置位时,T.88 §6.4.11 让解码器用各自选定的表读 RDW、RDH、RDX 和 RDY,再用 RSIZE 表读 BMSIZE,然后跳到字节边界,之后才对恰好 BMSIZE 个字节跑通用 refinement 解码。算术模式的文本区域没有这个字段,两种模式共用一条代码路径的解码器会跳过它、提前启动算术解码器,然后拿噪声去 refine 每个符号。符号字典里 REFAGG 加单个 refinement 实例的路径(§6.5.8.2.2)有同一个字段
PDF Library for Delphi 给 BMSIZE 两侧都设了界。下界是 2,即算术解码器总要消费的初始字节对。上界是当前段剩余的部分——刻意不取整个流:一个只有从下一个段借字节才装得下的 BMSIZE 本身就是畸形的,拿流长度做检查会让算术解码器读进后面的段头。超界的尺寸以 invalid refinement bitmap size 失败。此后 Huffman 读取器从字段之后恰好 BMSIZE 字节处恢复,不管算术解码器提前读了多远
声明的段长度就是边界
每个段头都声明后面跟着多少数据字节,解码器在两个方向上都拿这个数字约束段:读过末尾是错误,提前结束是正常的,下一个段头永远从文件说它开始的地方读。小规则跟着来:T.88 §7.2.7 的未知数据长度直接拒收,不扫描终止符;被引用段的段号必须更小且必须已存在;END_OF_PAGE 和 END_OF_FILE 必须声明零字节数据;Profiles 段(类型 52)必须恰好是 4 加 4 倍标识符数,随后被跳过但保留,后面的段仍可引用它,未知的 profile 标识符不会中止解码
提前结束的经典案例是 MMR。MMR 解码器产出最后一行的最后一个像素就完工了,这可能发生在 T.88 §6.2.5.7 放在数据末尾的 EOFB 终止符之前。一个以为自己已经坐在下一个段头上的读取器,会把剩下的 EOFB 字节当段号解析,几字节之后失败,离真正的原因很远。直接跳到声明的末尾就没这个问题。这个习惯贯穿 PDF Library for Delphi 解析不可信 PDF 结构的方方面面
从 Delphi 解码 JBIG2 图像流
解码器住在 PDFlibJBIG2 单元里,类名 TPLJBIG2Decoder。LoadFromByteArray 接收 /JBIG2Decode 图像的内嵌 JBIG2 数据,可选地接收它的 /JBIG2Globals 流数据——自定义表和共享符号字典通常住在那里。任何拒收都返回 False,原因留在 LastError;每次调用开始时都会清掉上一次调用的输出,所以一次失败的解码绝不会留下旧像素让调用方误当成结果
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes:图像流数据,JBIG2Decode 之前的
//   任何过滤器都已剥掉
// GlobalBytes:/JBIG2Globals 流数据,或空数组
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // 形如:'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // 每像素一个字节,0 或 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // JBIG2 里 1 = 黑
    end;
  finally
    Decoder.Free;
  end;
end;
黑像素计数是你自己的检查,一个跟第二个渲染器对照用的廉价指纹。段级失败带着段号、类型和字节偏移前缀到达,所以 oversubscribed Huffman prefix codes 前面的 (type 53) 直指一个 Tables 段。两条错误通道分开:TPLJBIG2Decoder.LastError 是这个解码器的诊断文本,TPDFlib.LastErrorCode 是库级 API 的数字代码。页面选择跟着流走:解码器返回它遇到的第一个页面信息段的位图,不按 page association 0 查找,因为内嵌 PDF 的 JBIG2 只带一页,而编码器习惯把它编成 1
在这类文件上比较渲染器需要一点谦逊,因为独立的 JBIG2 解码器面对自定义表加 Huffman refinement 的文件并不总是意见一致。两个解码器不一致说明不了什么,格式字段才说明问题:选择符选了哪些表、BMSIZE 声明了多少、每个段在哪里结束
编码一侧见JBIG2 编码器后端及其链接方式一文。读取路径必须接受别人家编码器发出的任何东西,它的规则与内置 TIFF 解码器及其 BigTIFF 与分块布局检查同源:点名拒收,绝不跨过声明的边界借字节,中间算术保持足够宽。如果一个文件夹的扫描 PDF 老是绊倒别的工具箱,看看图像是不是自定义表的 Huffman 编码 JBIG2,再拿它们试试 PDF Library for Delphi 产品页上描述的原生 Delphi 与 C++Builder 读取路径