把客户评论好好转义,让 <b>urgent</b> 以 <b>urgent</b> 的形态进入你的 HTML 模板,再交给一个把标记解析两遍的渲染器,PDF 回来时 urgent 这个词可能是粗体的。转义没有做错。渲染器每趟解码了一次。任何「解析、把结果写回 HTML、再解析」的 HTML 转 PDF 路径,都必须在整段旅程里把实体恰好解码一次
这类故事的工单版再普通不过:工单导出成 PDF,客户评论待在一个 <p> 里,有人往评论框里敲了角括号。不认识的标签名直接从页面上消失。转义过的锚点在你员工信任的文档里变成可点击的链接注解。文件合法、处处能打开;它说的只是与数据不同的另一番话
转义文本在哪里变回标记
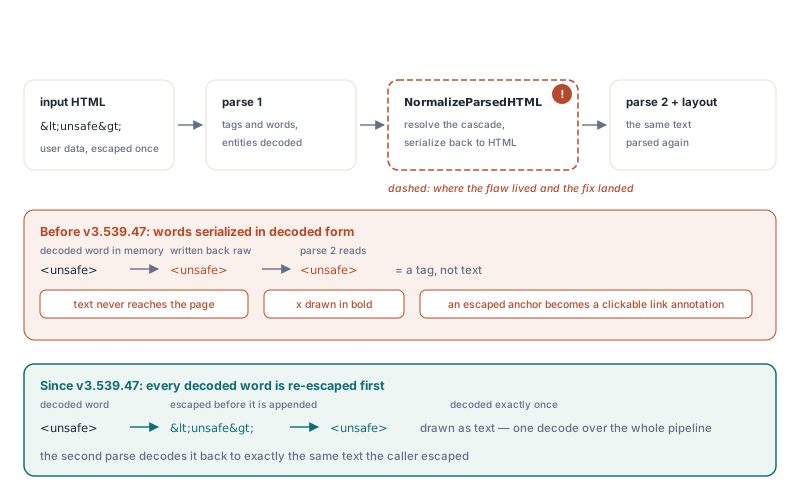
转义文本变回标记,发生在两趟渲染器把已解码文本写回 HTML 而不再转义的地方。第一趟解析解码过的一切,对第二趟解析都是活语法
PDF Library for Delphi(PDFlibPas)的 DrawHTMLText 和 DrawHTMLTextBox 跑两趟解析是有正当理由的。第一趟把输入拆成标签和单词。渲染器接着解决样式表级联:<style> 块里的规则逐个匹配到标签,与内联 style 属性合并,整个元素列表写回成一个规范化 HTML 字符串,每个标签带着最终样式。排版那趟解析这份字符串。选择器匹配、flexbox、grid 以及 PDFlibPas HTML 渲染的 flexbox、CSS grid 与脚注排版所描述的其余 CSS 支持,全都依赖这一步
危险藏在单词怎么写回去。标签可以从源形式写回,单词却是按解码后的文本持有的——断行器量的是它。把来自 <unsafe> 的单词原样追加进规范化字符串,第二轮解析收到的 <unsafe> 就是一个元素。设计成只解码一次的方案还必须堵住三个小泄漏:
- 若
&不在解码集合里,R&D按字面打印,而且根本没办法把<这种写法当文本放上页面 - 若绘制阶段在解析结束之后又替换一次
,字面实体写法在最后一刻消失 - 若上游的 HTML 生产者——比如 Markdown 转换器或数据集导出器——只转义角括号,代码样本或单元格值里的实体写法被解码成标记
下表列出几组输入到达页面的结果,对比朴素的两趟渲染器与 PDFlibPas 流水线
| 到达渲染器的输入 | 朴素两趟渲染器 | PDFlibPas |
|---|---|---|
<unsafe> | 被当成标签解析,文本到不了页面 | 以文本画出 <unsafe> |
<b>x</b> | x 以粗体画出 | 以文本画出 <b>x</b> |
R&D | R&D 按字面打印 | R&D |
&lt; | &lt; 按字面打印 | < |
含 的 Markdown 代码 span | 变成不换行空格 | 以文本画出 |
数据集单元格值 < | < | < |
PDF Library for Delphi 怎么把每个实体恰好解码一次?
PDF Library for Delphi 让每个实体恰好解码一次,靠的是三条规则同时成立:解析器最后才解码 &,绘制阶段什么都不解码,所有把解码后单词变回 HTML 的地方都先重新转义。三条里少任何一条,上表就有一行翻回朴素列
先看解码什么。正文文本里,解析器认 <、>、& 和 。A 这类数字引用和 " 这类命名实体保持字面文本。这张短清单决定了你该怎么转义自己的输入,下文还会提到
解码器内部的顺序即便在单趟之内也要紧。先解码 &,输入 &lt; 就变成 <,紧接着的下一次替换再把它变成 <——没有任何第二趟解析的双解码。所以 8 位单词路径先替换 <、> 和 、最后替换 &,它产出的 & 符号不会再被检视。UTF-16 单词路径走另一条路到达同一结果——一次从左到右、按两字节步进的扫描,原地改写每个匹配然后跳过它
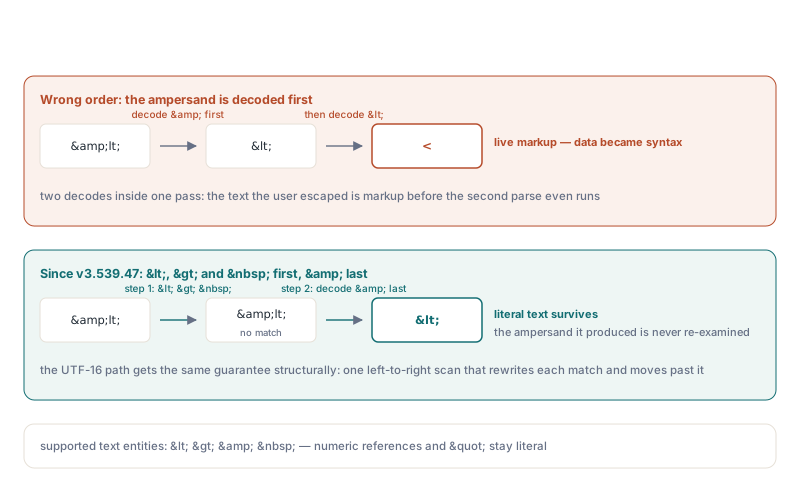
绘制阶段不再做任何迟到的 替换。到达断行器的单词就是最终文本,解码只住在解析器里
边界规则分量最重。渲染器写规范化 HTML 时,把每个解码后单词里的 &、< 和 > 先转义再追加,第二趟解析把它解码回同样的字符。两趟合起来的净效果:一次解码。DrawHTMLTextBox 返回的续排字符串遵守同一规则:装不下的单词先转义再进 remainder,remainder 的其余内容拷自规范化 HTML——本就是转义后的形态。装下一切的框返回空字符串
UTF-16BE 转义为什么不能用字节级替换?
UTF-16BE 的转义不能用字节级替换,因为一个 & 符号的两个字节可能横跨两个毫不相干的字符。唯一安全的工作单位是完整的 16 位码元
渲染器把 Unicode 单词存成大端 UTF-16 打包进字节串的形式,高字节在前,& 符号即 00 26。取 U+0100(带长音符的拉丁大写 A,字节 01 00)后跟 U+2603(雪人,字节 26 03)。缓冲区读作 01 00 26 03,第二、三字节恰好拼出 00 26。按字节搜索 #0'&' 会找到一个没有任何字符包含的 & 符号,把 & 拼进两个码点中间,后面每个字符错位一字节
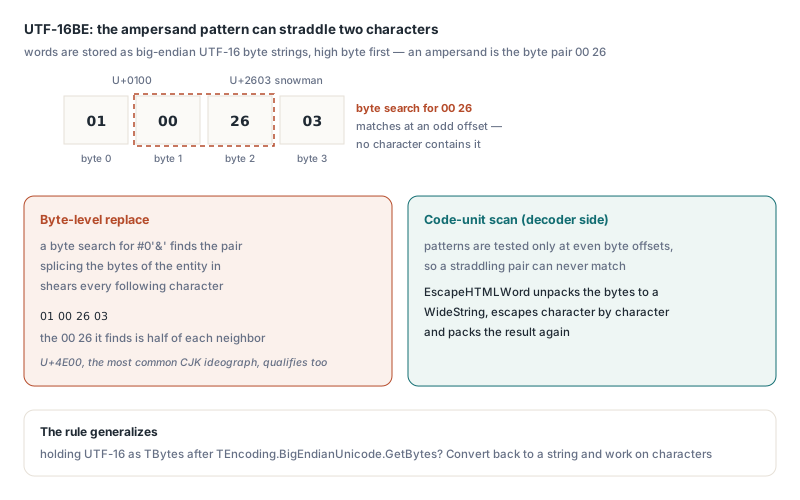
这不是刁钻的角落。低字节为零的任何字符都能凑出前一半,而 U+4E00——最常用汉字之一——正是这种字符。角括号同样暴露:00 3C 与 00 3E 会在这种字符后跟一个 CJK 扩展 A 区 U+3C00 到 U+3EFF 字符时出现。所以 PDFlibPas 转义 Unicode 单词的方式是:解包成 WideString,逐字符转义,再打包回去。解码器出于同样的理由是安全的:它只在偶偏移上测模式
你自己的代码也会撞上同一堵墙。UTF-16 文本一旦住进 TBytes——比如经过 TEncoding.BigEndianUnicode.GetBytes 之后——对它做字节模式搜索就是一个等着正确字符组合上门的 bug。转回字符串,在字符上工作
Markdown 代码与数据集单元格:& 符号先走
PDFlibPas 内部的两个 HTML 生产者——Markdown 转换器和数据集导出器——都在角括号之前转义 & 符号,于是渲染器里的那一次解码逐字节还原原始文本
在 MarkdownToHTML 里,行内代码 span 与围栏或缩进代码块把 & 映射为 &、< 映射为 <、> 映射为 >;空格变成 ,制表符变成四个,缩进因此保全。普通散文只转义角括号:散文里手打的裸 HTML 注入不了标签,而有意写 & 的作者仍得到一个 &——Markdown 作者期望的方式。DrawMarkdownText 和 DrawMarkdownTextBox 跑同一套转换,代码块显示的就是打进去的原样:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// 检查生成的 HTML:代码里 '&' 变成 '&','<' 变成 '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // 左上角原点,Y 向下增长
Lib.SetMeasurementUnits(0); // 磅
// 页面按打进去的原样显示代码,实体写法原样保留
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;数据集导出器正是那个诱人捷径的老家。如果渲染器不解码 &,转义 & 符号会让每个含 & 的单元格打印出 &,只转义角括号于是显得更友好。第一个恰好含 < 的单元格就拆穿它——它以 < 到达页面。既然渲染器确实解码 &,PDFlibExportDataSet 背后的导出器先转义 &,R&D < & 这样的值原样落进 PDF。该导出器的其余部分见在 Delphi 里把 TDataSet 导出成 PDF 报表
为什么第一、而不只是链条上随便哪个位置?先转义 < 得到 <;接着转义 &,它变成 &lt;,而正确的单次解码把它显示成 < 而不是 <。顺序替换链只有在一个前提下成立:转义字符本身在任何会引入它的步骤之前被处理
给 DrawHTMLTextBox 转义不可信文本,该怎么做?
为 PDFlibPas 转义不可信正文:替换 &,然后 <,然后 >,恰好一次;不可信数据则完全不要放进属性值。下面的辅助函数加进你自己的代码即可,纯 RTL:
uses
System.SysUtils, PDFlibrary;
// 你自己的辅助函数(非库的一部分):为 PDFlibPas
// HTML 正文转义不可信文本。'&' 必须最先替换,
// 否则刚产出的 '<' 里面的 & 符号
// 会被再次转义
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;喂给它评论 Try <a href="https://example.com">this</a> & <b>,页面逐字符显示这些内容。在解码两次的渲染器下,同样的转义输入变成活的链接注解。这正是从显示毛病到安全问题的那一步:工单评论绝不该能在发给你自己员工的 PDF 里埋一个可点击的 URL
注意这个辅助函数放过了什么。通用转义器还会把 " 变成 "、把 ' 变成 '——对浏览器正确,在这里错误:PDFlibPas 的文本解码只认前面列的四个实体,这两个会按字面打印成 " 和 '。别把浏览器转义器拿来就用。引号在正文里无害;它们只在属性值里要紧,而渲染器根本不解码属性里的实体。属性方面,我们要的是一条规矩而不是更聪明的转义器,因为那里反正没有转义方案可查:用户值不进 href、src 和 style。链接目标确实必须来自用户输入时,自己对照 scheme 与字符白名单校验,凡含引号或角括号的一律拒绝
单趟解码直接给出两条习惯:
- 永远转义
&。跳过它,含<的用户文本会显示成<——无害,但不是用户敲的内容 - 只在一处转义。过了两道转义器的文本把
<渲染成可见写法<,所以找准数据进入 HTML 字符串的那一个位置,在那里转义
用 LeftOverText 分页,别破坏转义
DrawHTMLTextBox 返回没装下的 HTML——通常叫 LeftOverText——这份 remainder 进下一个文本框时,字面实体写法和转义过的角括号都原样保留。按你收到的样子原样传回
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // 按 A4 页面以磅取的尺寸
  BoxHeight = 740;
  MaxPages = 500;    // 你自己的安全上限

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // remainder 已是转义后的 HTML:绝不要再转义或反转义
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
把 remainder 当不透明数据。它是样式已解析到每个标签上的规范化 HTML,过一遍你自己的转义器会把每个 < 变成 &lt;,解码它则把活标签交给下一个框。往里拼新用户文本同样有这两种失败。页数上限只花一次比较:某个元素若永远装不进框,无上限的循环没有自然出口
Markdown 有自己的续排。DrawMarkdownTextBox 返回以标记注释开头的 remainder,它告诉 Markdown 入口下次调用跳过转换。把它交回 DrawMarkdownTextBox 或 DrawMarkdownText,就像把 LeftOverText 交回 DrawHTMLTextBox 一样。Markdown 的 remainder 归 Markdown 入口管,只有 DrawHTMLTextBox 的 remainder 才走 HTML 调用
这背后那个形状——解析、写回同一语法、再解析——也出现在模板引擎、HTML sanitizer 和 Markdown 到 HTML 到 PDF 的链条里,失败有两个方向。再编码太少,数据变成语法;再编码太多、或解码器跑两遍,实体写法被展示给读者或被吃掉。只补一个方向往往弄坏另一个,这就是 PDFlibPas 渲染器把 & 解码、最后解码它、不做迟到解码、在每个边界重新转义当作一个整包处理的原因。导出方向在从 Delphi 做 PDF 到 Markdown 与 DOCX 的语义导出里遵守同一规则:每个字面字符对目标语法恰好转义一次
HTML 与 Markdown 绘制、数据集报表导出器和排版引擎的其余部分,以原生 Pascal 源码形式随 PDF Library for Delphi 发布,Delphi 与 Free Pascal 都可用。版本、平台覆盖与试用下载见 PDF Library for Delphi 产品页