半个点决定成败。一份正文 10 磅的报告里,11 磅加粗的章节标题转成 Markdown 后只是普通段落,而封面上 12 磅常规字重的说明文字回来时却是 ### Quarterly figures。看似颠倒,直到你想起 PDF 页面实际存的是什么:坐标上的字形、字体名和字号。页面上没有任何东西写着"标题"。转换器输出的每个标题都是从这三样事实猜出来的,而猜测有阈值
为什么 PDF 页面没有可导出的段落
PDF 页面装的是文字显示操作符,不是段落。每个操作符把一串字形放到一个位置,顺序取决于产生它的应用碰巧怎么输出,ISO 32000-1 没有要求生产者声明两串字形属于同一句话,更别说同一个列表项或表格单元格。这个格式对打印页面的描述精确无比,而它做到这一点的方式,是把产生页面的那个结构丢弃掉
于是每个转换器都在重建生成器丢掉的东西。行来自共享的基线和垂直间距。段落断点来自间距和缩进的变化。列表是一串以项目符号或数字模式开头的块。表格是边缘跨行跨列对齐的文本块网格。对遵循常规排版习惯的文档,这套推断工作良好;对为了视觉效果排版的宣传册,它能抓住的东西寥寥无几
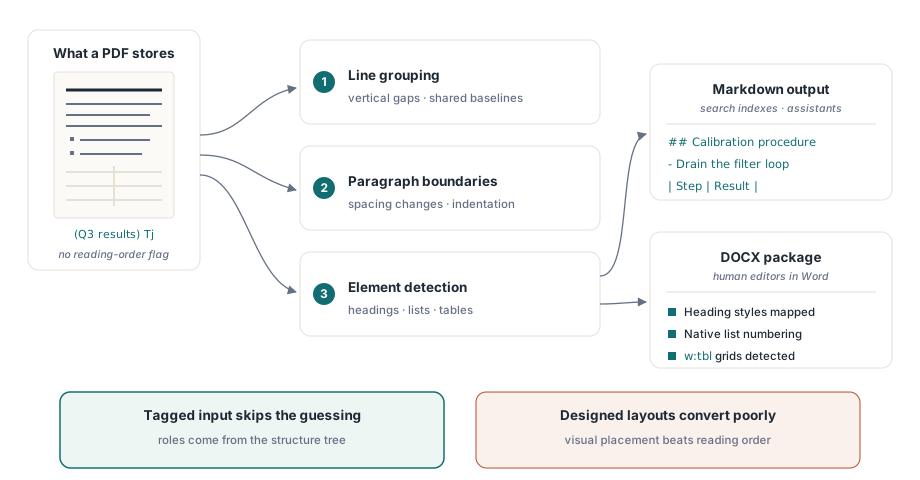
带标签的 PDF 是大例外。文档带结构树时,段落、标题、列表和表格角色由生产者记录而非事后猜测,这也是 带标签 PDF 的无障碍结构 一文的工作能在转换质量上兑现的原因。如果你控制生产者,给输出打标签是为将来转换它的人所能做的最便宜的一件事
标题级别从哪里来
PDF Library for Delphi 按输入分两种方式定标题级别。带标签页面上,结构角色为 H1 到 H6 的块保留该级别,H 或 Title 记为 1 级。不带标签的页面上,导出回落到相对页面正文文字的字号,而且只考虑 200 字符以内的单行段落
字号规则需要一个比例和一个绝对差距,都对照占主导地位的正文尺寸衡量:
| Markdown 输出 | 行上最大的文字 | 以 10 pt 正文计 |
|---|---|---|
# | 至少 1.6 倍正文尺寸且至少大 4 pt | 16 pt 及以上 |
## | 至少 1.35 倍且至少大 2.5 pt | 13.5 pt 及以上 |
### | 至少 1.15 倍且至少大 1.25 pt | 11.5 pt 及以上 |
这就解释了开头的例子。10 磅正文上的 11 磅加粗标题,离第三档差半磅,而字重在级别判定里根本不参与。封面上 12 磅的说明文字过了线。绝对差距是为小字号存在的:6 磅脚注大小的正文,单凭比例会把 7 磅的行提拔成标题,多出来的 1.25 pt 要求挡住了它
我们认为这是正确的取舍。加粗在正文里太常见了(引子短语、定义术语、汇总行里的合计),单靠它当标题信号并不可靠,把每行加粗都提拔的转换器会产出带几十个伪章节的 Markdown。漏掉几个只用加粗表达的标题代价更小。如果你的文档靠正文字号加粗标题吃饭,可靠的修法在上游:打标签,或者把标题字号调大一两磅
输出里的加粗和斜体从字体名读出。字体名含 Bold、Black 或 Demi 的文本段变成 **bold**;Italic 或 Oblique 变成 *italic*。用 F3 这类不透明名字子集化字体的生产者,或靠描边普通字形伪造加粗的生产者,没给导出留下任何可读的东西,这些文本原样无样式到达
面向检索管线的 Markdown 导出
去向是文本管线时——文档站、搜索索引、给助手用的分块语料——就该走 Markdown 这条路。ExportPageMarkdown 以 WideString 返回一页,ExportDocumentMarkdown 返回一个页面区间,SaveMarkdownToFile 和 SaveMarkdownToStream 把同样的文本以不带字节顺序标记的 UTF-8 写出。缺 BOM 是刻意的;不少静态站点生成器和 diff 工具把它当内容
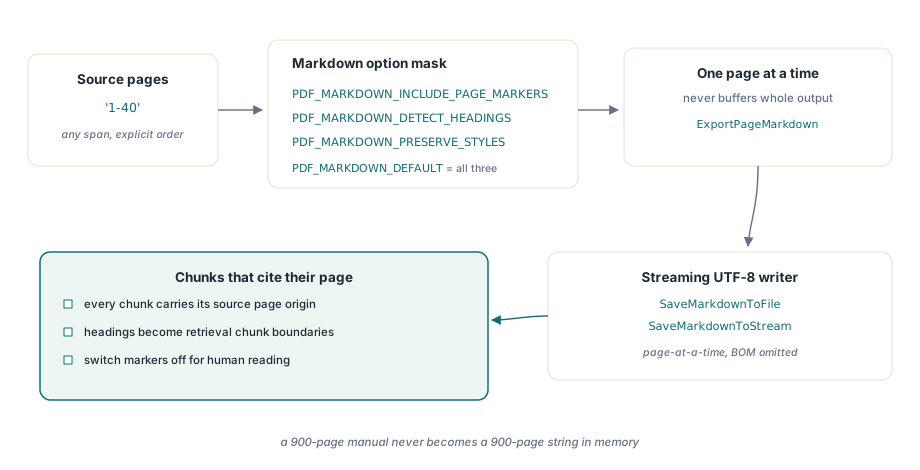
选项是位掩码:PDF_MARKDOWN_INCLUDE_PAGE_MARKERS(1)、PDF_MARKDOWN_DETECT_HEADINGS(2)和 PDF_MARKDOWN_PRESERVE_STYLES(4),PDF_MARKDOWN_DEFAULT 三者全含。另一个文档级设置控制分析本身:SetStructuredTextOptions 接收 PDF_STRUCTURED_* 标志,默认检测分栏、检测页眉页脚,并把跨页延续的表格接回去
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // 页眉页脚检测默认开启;
    // 加上 EXCLUDE_FURNITURE 还会把它们从输出里去掉
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // 要页面标记和标题,但不要 ** 和 * 强调
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // 每页一条的 JSON:readingSource 取值为 tagged、mixed、
    // geometric 或 geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
做检索语料时我们去掉 PDF_MARKDOWN_PRESERVE_STYLES。强调逐文本段施加,一段跨多个文本段的加粗短语会输出成 **Net** **revenue**,屏幕上读着还行,却给每个嵌入向量添噪。页面标记正好相反:要留。每个标记是一条 HTML 注释 <!-- page: 12 -->,Markdown 渲染时不可见,切块时解析起来毫不费力,检索到的段落因此能引用出处页码。表格从上一页延续时,新页的标记被省略,让管道表格保持完整
两个行为会让逐页循环导出的人意外。第一,页眉靠重复识别:页面顶部或底部 12% 区域内的段落,只要同一导出的其他页面同一区域有匹配文字(数字被归一化,"Page 3 of 40" 能匹配 "Page 4 of 40"),就算作装饰元素。单页调用没有其他页面可比,不带标签的页眉就留在文本里。第二,Markdown 里的图像以内联 data: URI 嵌入,文件因此自包含,但一张大照片的页面会给文件加上几百 KB 的 base64。切块器有大小上限的话,切分前先把以 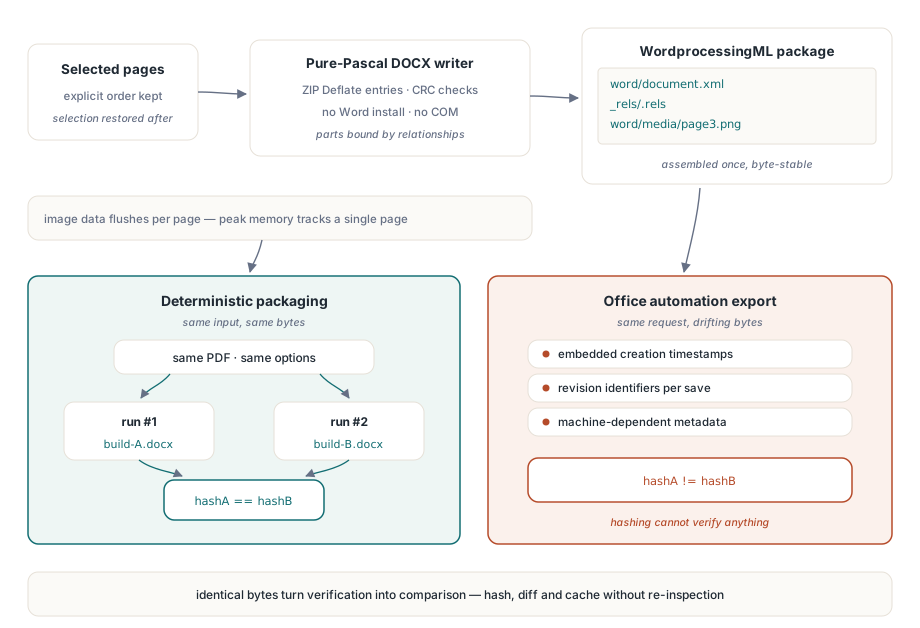
两个选择撑住了这一点。每个 ZIP 条目带同一个固定的 DOS 日期——1980 年 1 月 1 日——而不是运行时刻;核心属性部件不带创建或修改日期。每个条目只在原始 Deflate 真能压得更小时才压缩,所以本已压缩的 PNG 媒体原样存储。第一点可以用 unzip -v handbook.docx 亲自验证:每一行都是同一个日期
Office 自动化给不了你这个。经 Word 保存会把当前时间盖进包元数据和 ZIP 头,同一文档转两次的差异足以毁掉哈希。面向可复现构建的确定性 PDF ID 背后是同一个推理:输出一旦可复现,验证就变成一次比较
哪些输入转换得好,哪些永远不行
转换质量更多取决于输入而非转换器,值得提前告诉你的用户。带标签的 PDF 和干净生成的业务文档(发票、报告、合同)转换良好:标题落成标题,表格存活,列表在 Word 里重新编号。双栏学术版式在栏几何规整时按正确阅读顺序出来,诊断会为这些页面报告 geometric-columns。跨页断开的表格靠推断接回,记得抽查。重设计的营销材料——文字为效果而非阅读顺序而摆放——给任何转换器留下的可恢复信息都很少;预期要手工润色结果
扫描件是另一回事。一整张图像的页面不含文本对象,没有文本层就无从导出,跑 OCR 是两种格式共同的前置条件。在大批量上马之前,先抽十几份有代表性的文件、枚举它们的页面里有什么,见 文本搜索与页面元素枚举;一页有图无文本的页面,比读转换输出更能说明问题
按下一步要发生什么来选格式。Markdown 适合机器和管线:标题变成分块边界,表格保持为可读的管道表格,页面标记给每个分块一个引注。DOCX 适合需要改文档的人:他们要拿回来的是 Word 里可编辑的文件,带真正的列表和真正的表格,光有文本给不了这些
PDF Library for Delphi 面向 Delphi、C++Builder 和 Lazarus 发布,DLL 和 ActiveX 版本把同样的 Markdown 与 DOCX 导出调用暴露给 C#、C++ 和脚本宿主。每个选项标志的参考和试用下载都在 PDF Library for Delphi 产品页面