一套诚实的 PDF Library for Delphi 加载/保存基准用 QueryPerformanceCounter 为 LoadFromFile 和 SaveToFile 计时,保留原始 tick 数和计数器频率,让基线与候选按 A/B、B/A、A/B 的顺序交替成对运行,CPU 负载高于 25% 时拒绝开跑,极差除以中位数的离散度超过 15% 的结果一律拒收,凡是保存出的 PDF 没能通过结构、渲染或语义校验的计时全部丢弃。这份清单读起来像官僚流程,直到你第一次看到「快了 20%」的结论在重跑时蒸发为止。下面要讲的是专用语料探测器和它的比较运行器是怎么一步步加上这些闸门的,其中包括那次机器忙到什么都测不了、而测试框架正确说出了这一点的运行
为什么 Delphi PDF 基准会报出零秒?
当计时器的滴答粒度比被测操作还粗时,PDF 加载基准就会报出零秒,而 GetTickCount64 恰好就是这种计时器:它返回毫秒,但在 Windows 上只有系统定时器中断触发时才前进,通常是每 15.6 ms 一次。PDF Library for Delphi 的大文件基准 demo 的 FPC 移植版用了它,因为 TStopwatch 在那套工具链里不可用,而这个 demo 把耗时记录到小数点后三位。加载一张小 CAD 图或一份短的 tagged 文档在一个定时步长之内就完成了,于是 demo 有时会为一个明明干了实事的加载打印出 0.000
function ElapsedSeconds(StartTick: QWord): Double;
begin
  Result:= (GetTickCount64- StartTick)/ 1000.0;
end;

// 操作循环内部
Lib:= TPDFlib.Create;
try
  Lib.OnProgress:= Reporter.Progress;
  Started:= GetTickCount64;
  LoadCode:= Lib.LoadFromFile(InputFile, Password);
  ...
零比一个不精确的数更糟,因为你建立在它之上的每个比较都要拿它做除数。成对比较运行器把最小值为零的任何一臂判为「无结论」,理由是「Zero duration prevents a meaningful ratio」——这个拒绝是对的,但它也意味着 demo 的计时恰好在短文件所在的地方留出了一块测量空白。同一个 demo 还装了 OnProgress 回调,所以它的计时里带着回调开销,而一次干净的加载/保存测量不该背这个;归档下来的 demo 数字与之后测的任何东西都不可互换
用 QueryPerformanceCounter 为 LoadFromFile 和 SaveToFile 计时
专用的控制台探测器 Tests/CorpusLoadSave.dpr 用 QueryPerformanceCounter 对每个输入文件测两个操作:LoadFromFile 加读取 PageCount,以及 LoadFromFile 加 PageCount 加 SaveToFile。每个操作都用一个全新的 TPDFlib 实例、不挂进度回调,实例的构造与析构都在计时区之外,CSV 写入和全部输出校验也一样。计数器在加载前一刻和最后一个库调用后一刻读取,LastErrorCode 只在第二次读取之后才取
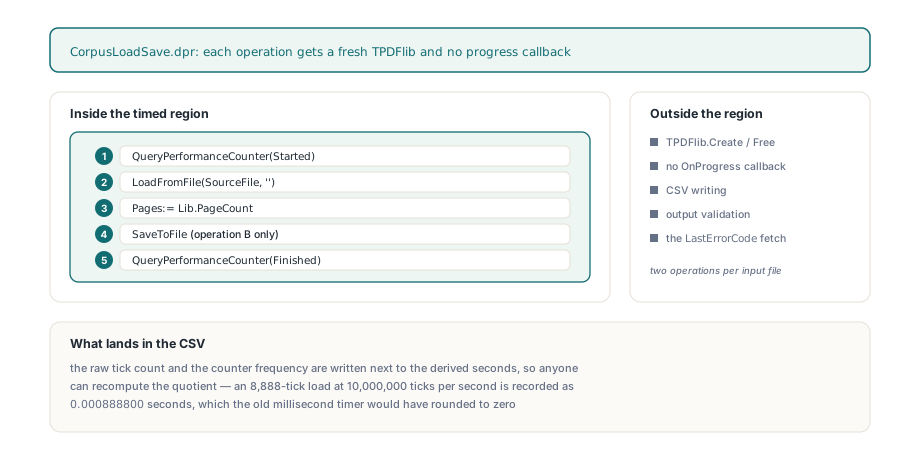
Lib:= TPDFlib.Create;
try
  if not QueryPerformanceCounter(Started) then
    raise Exception.Create('Performance counter unavailable');
  Code:= Lib.LoadFromFile(WideString(SourceFile), '');
  if Code= 1 then
  begin
    Pages:= Lib.PageCount;
    if Save then Code:= Lib.SaveToFile(WideString(SavedFile));
  end;
  if not QueryPerformanceCounter(Finished) then
    raise Exception.Create('Performance counter unavailable');
  ErrorCode:= Lib.LastErrorCode;
finally
  Lib.Free;
end;
Ticks:= Finished- Started;
if Ticks< 0 then
  raise Exception.Create('Performance counter moved backwards');
探测器把原始 tick 数和计数器频率写在换算秒数旁边,以九位小数、固定 . 小数分隔符格式化,谁都可以从 CSV 里重新算一遍商,而不必信它。在 FPC Win64 构建上,CAD 样例以每秒 10,000,000 tick 的频率在 8,888 个 tick 内加载完成,记录为 0.000888800 秒——旧计时器会把这次观测舍入成零。探测器刻意不做裁剪短值、代之以最小时长、扣除估计计时器开销这类事,库调用失败时它仍会写出两行并以非零退出码结束。不过九位数字并不等于精度:记录更多的小数位对可重复性只字未提,噪音大的观测和零观测仍然要靠下游拒绝
if not QueryPerformanceFrequency(Frequency) or (Frequency<= 0) then
  raise Exception.Create('Performance counter frequency unavailable');
NumberFormat:= TFormatSettings.Create;
NumberFormat.DecimalSeparator:= '.';
...
Rows.Add(CSV(ExtractFileName(SourceFile))+ ','+ CSV(Operation)+ ','+
  FormatFloat('0.000000000', Ticks/ Frequency, NumberFormat)+ ','+
  IntToStr(Code)+ ','+ IntToStr(ErrorCode)+ ','+ IntToStr(Pages)+ ','+
  IntToStr(Ticks)+ ','+ IntToStr(Frequency));
PDF 加载/保存计时的比较要怎样才可信?
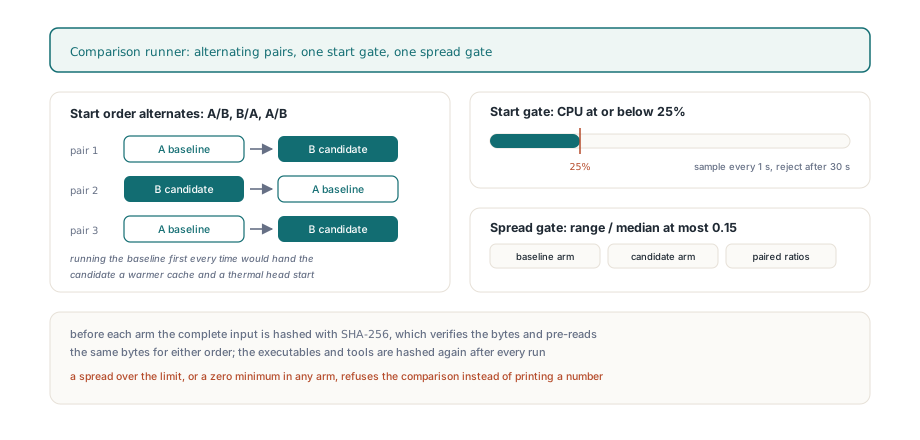
两个构建之间的计时比较只有在启动顺序、启动条件和离散度都受控且被记录时才可信,所以比较运行器至少安排三对、按 A/B、B/A、A/B 的顺序跑。总是先跑基线,等于悄悄把更热的文件缓存和不同的热状态递给候选;交替顺序把这个偏差摊到两臂头上,而不是记在某一边账上。每臂开始前,运行器用 SHA-256 哈希完整输入文件,既验证没有东西被改动,也为两臂预读同样的字节;每次运行之后它再哈希两个可执行文件和校验工具,重新编译出的二进制没法溜进一个系列的中途
运行器随后每秒采样一次整机 CPU 利用率,只在样本落到 25% 或以下时才启动该臂,最多等 30 秒,超了就把这次尝试记为拒绝。这个闸门只控制启动条件,别的什么都不管:运行期间机器并不被隔离,电源状态、热节流、后台任务和 OS 缓存仍能搬动数字。所以第二道过滤是最朴素意义上的统计。对每个操作,运行器分别算基线臂、候选臂以及成对候选/基线比值分布的极差除以中位数,三者任何一个超过 0.15,结果就被标成 noisy,而不是当作发现上报
为什么同二进制对照证明的是可重复性而不是速度?
同二进制对照让基线和候选跑完全相同的可执行文件,所以接近 1.0 的比值只能证明测量设置能复现自己,永远不能证明哪个实现变快了。2026-09-21 的第一次严格对照用高分辨率 FPC Win64 探测器测一份 70 页的 tagged 指南,六次启动全部被拒,因为 CPU 样本在 26.5% 到 93.8% 之间徘徊。报告里只有失败、没有汇总值——机器忙的时候你要的正是这个结果。当天晚些时候用逐字节相同的输入、同一个探测器可执行文件、不变的阈值重试,六次启动在 3 秒内全部放行;每次极差对中位数的比都落在 0.019 到 0.054 之间,LoadFromFile 的比值中位数是 1.0084,LoadFromFile + SaveToFile 是 0.9872
这一对数字确立的只是一个合格的观测窗口,仅此而已。当两个二进制不同时,一次稳定的运行会被标为描述性比较,并附上明确的说明:这些比值是观测值,不是统计显著性,也不是提速声明。这套纪律在你验证针对性优化时最要紧——比如对 PDF Library for Delphi 做 profile 并用哈希索引替换热点路径里描述的那些:profiler 告诉你时间去哪儿了,但只有真实文档上受控的成对运行才能告诉你改动是否扛住了整条管线的检验。还有一条边界值得说出口——normal-save 里包含加载,运行器记录的峰值工作集是进程级的,所以没有哪部分内存可以单独记在保存头上
三道输出闸门与一个四编译器矩阵
除非它产出的文件通过三道独立闸门,否则任何 PDF Library for Delphi 的计时不作数,因为快速写出一个坏 PDF 的保存并不是更快的保存。基准先检查两个操作都返回 1 且报告的页数与承认值一致,然后按这个顺序校验唯一一份保存出的 PDF:
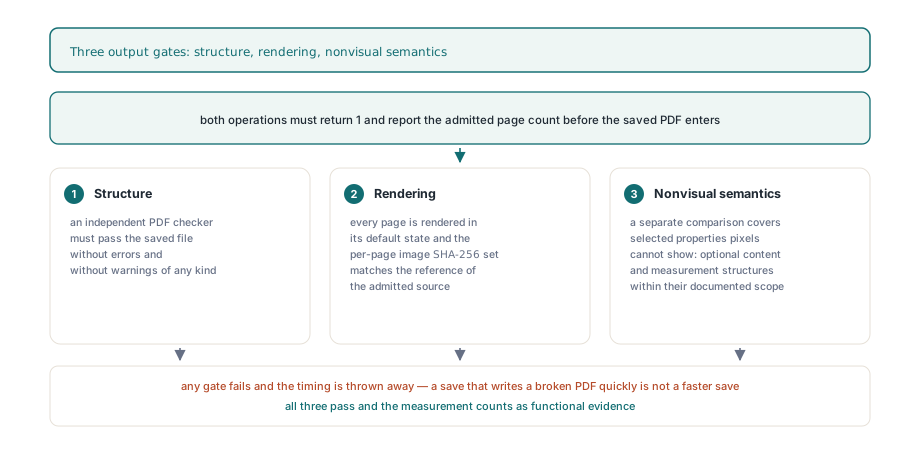
- 结构:一个独立的 PDF 检查器必须无错误无警告地通过保存的文件
- 渲染:每一页都按默认状态渲染,逐页图像 SHA-256 集合必须与被承认源文件的参考渲染完全一致
- 非视觉语义:一项针对源文件的独立语义比较覆盖像素显示不出来的选定属性,包括其文档范围内的可选内容与测量结构
在这些闸门之下,完整语料矩阵在 FPC Win32、FPC Win64、Delphi Win32 与 Delphi Win64 上对 12 份被承认的 PDF、共 1,612 个源页面跑探测器,得到 48 对样本/目标组合与 6,448 个通过校验的输出页,没有任何选定的语义差异。全部 96 个操作测量都保留了与报告秒数一致的正的原始计数值,而这些值刻意不被汇总成跨编译器速度表,因为这个矩阵是功能性证据,不是受控比较。加载/保存路径也不声称能解码每张嵌入图像、验证签名、执行 XFA 或认证 PDF/UA;如果你要评判的是渲染吞吐而不是加载/保存成本,PDF Library for Delphi 的并行页面渲染与线程安全里讲的并发约束才是更好的起点
实操结论很短:保留原始计数器值,交替顺序,闸住启动,拒绝噪音大的离散度,永远不要给一个没校验过的输出计时。正是这些规则让 PDF Library for Delphi 能像说「更快」一样有底气地说「无可测量的变化」,而且同一份探测器源码在 Delphi 与 FPC 的 Win32 和 Win64 上不加改动就能编译。你可以在 PDF Library for Delphi 产品页上查看这个库、它的加载/保存 API 与支持的编译器