在 Delphi 里并行渲染 PDF 页面归结为一条规则:给每个工作线程配一个属于它自己的渲染器。losLab PDF Library 为的正是这件事而提供了 RenderPagesToFilesParallel,它把一个页码区间扇出到一个 TTask 池上,每个工作线程配一个 TPDFlib 实例,于是一台多核机器就能把一次批量光栅作业变成接近核心数线性扩展的吞吐。反过来在线程间共享单个实例,这次运行不会优雅地变慢,它会破坏内存并崩溃
当一个夜间作业要把一份 500 页的 PDF 变成 500 张 PNG、机器上有 16 个核在闲着、而你第一次老老实实给它加线程却栽在 GDI+ 里的时候,你要找的就是这篇文章。简短版本是:这里的线程安全是一种结构性性质,不是一个你能设的开关;本文余下部分讲清安全形态为何长成这样,以及真正的加速上限究竟在哪儿
TPDFlib 用于并行渲染是线程安全的吗?
不是,而且这个原因值得在你围绕它做设计之前先弄明白。单个 TPDFlib 实例被声明为单线程使用,而那个锋利的边缘是 TPDFPageTree.GetPage:它在选页时会作为副作用写入实例上一个共享的 FPagePointer 字段。两个线程调进同一个实例就会在这个字段上竞态,于是工作线程 A 刚渲染到第 3 页一半,工作线程 B 就把页面树重新指向了第 40 页。API 里没有任何东西阻止你写出下面这段代码,而且它在出错之前甚至还能跑上几页,这正是这类缺陷最糟糕的表现方式
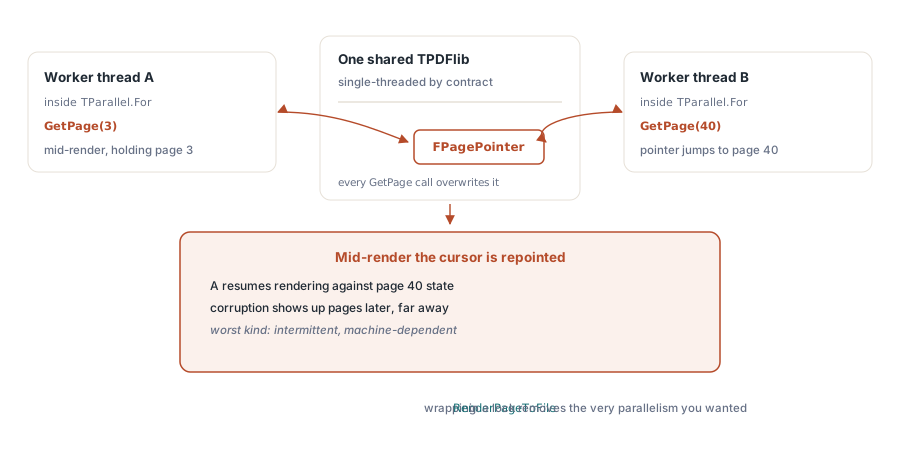
// 千万别这么做:一个共享实例,多个线程
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  Pdf.LoadFromFile('report.pdf', '');
  TParallel.For(1, Pdf.PageCount,
    procedure(Page: Integer)
    begin
      // 每个线程都重入同一个实例 -> 在 FPagePointer 上产生数据竞态
      Pdf.RenderPageToFile(150, Page, 0, 'page' + IntToStr(Page) + '.png');
    end);
  Pdf.Free;
end;
这种失败不是确定性的,这也正是它能熬过一次快速冒烟测试、然后在一台核心数不同、文档更重的客户机器上浮出水面的原因。你也没法便宜地在 RenderPageToFile 外面套一把锁来修它,因为在整个渲染调用上持有互斥量会把工作串行化,把你本来想要的并行度整个丢掉
为什么每个渲染工作线程都需要自己的 TPDFlib 实例?
因为实例就是隔离单位。一旦每个工作线程都拥有一个独立加载了文件的私有 TPDFlib,它就有了自己的页面树、自己的 FPagePointer 和自己的渲染状态,于是没有任何共享物可供竞态。这份安全有代价,你应当提前估好:每个工作线程都会把整份文档解析进内存,因此峰值占用大约是单实例开销的 N 倍。在一份 300 MB 的 PDF 上开八个工作线程,就是同时驻留八次完整解析,而在超大输入上,决定你线程数的正是这一点而不是 CPU。当文档巨大、你受限于内存而不是 CPU 时,不做整份文档解析地处理大型 PDF中那条直接访问路线,往往比加更多渲染线程更有效
一次调用的 API:RenderPagesToFilesParallel
losLab PDF Library 把整套安全模式打包在一个方法背后,因此常见场景下你完全不必自己手搓。RenderPagesToFilesParallel 接受文件名和口令、一个 DPI、闭区间的起止页码、一个直接透传给按页光栅路径的 Options 值、一个用 %p 代表页码的输出模式串,以及一个工作线程上限,其中小于或等于零的任何值都表示自动。它返回成功渲染的页数,并且是仅限 Windows 的路径,因为它依赖 CoInitialize 和 GDI+
var
  Pdf: TPDFlib;
  Rendered: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    // 文件名、口令、DPI、起始页、结束页、Options、模式串、最大工作线程数
    Rendered := Pdf.RenderPagesToFilesParallel(
      'report.pdf', '', 150.0, 1, 500, 0, 'out\page_%p.png', 0);
    // MaxWorkers = 0 -> 自动:取页数与 CPU 核心数的较小者
    WriteLn(Format('%d pages rendered', [Rendered]));
  finally
    Pdf.Free;
  end;
end;
为什么每个工作线程都要 CoInitialize?
页面渲染底下的光栅化器是 GDI+,而 GDI+ 是套间线程模型的:它要求调进来的那个线程已经初始化了 COM。一个 VCL 应用的主线程通常已经准备好了,但一个刚刚生出来的 TTask 工作线程没有,而从未初始化的线程去调渲染路径是一种稳定的崩溃方式。因此每个工作线程都在入口处配一个 CoInitialize(nil),在退出时配一个 CoUninitialize,把自己的整个生命周期括起来。这与主线程之外做任何 GDI+ 或 COM 工作所需的纪律是同一套,也是让按工作线程隔离真正成立的后一半,前一半则是那个私有实例。同一条 GDI+ 光栅路径也驱动着为 PDF 输出选择渲染引擎中所讲的那些单线程引擎
静态分片与动态抢页之争
把 500 页分给 8 个工作线程,最显而易见的做法是每人固定切走大约 62 页。losLab PDF Library 没有这么做,理由是负载均衡。每页的开销差异极大:一页正文几毫秒就渲染完,而一页密集的矢量地图或一张出血的扫描图可能要慢上五十倍。把工作切成固定分片,那个恰好抽到重活的工作线程会在其他线程都闲下来之后还在长跑,于是你的墙上时钟时间由最倒霉的那个分片而不是平均值决定。取而代之的做法是:每个工作线程在一小段临界区内从共享计数器领取下一页,渲染它,再回来领下一页,这样在整个区间被抽干之前每个核都不闲着
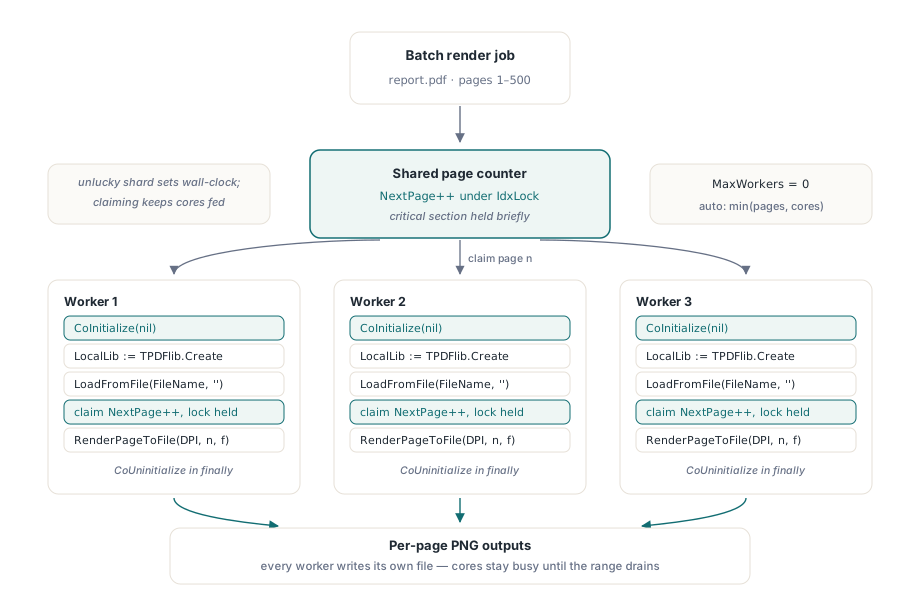
// 池里每个工作线程做的事(简化版)
NextPage := StartPage;
IdxLock := TCriticalSection.Create;
WorkerProc :=
  procedure
  var
    LocalLib: TPDFlib;
    PageNum: Integer;
  begin
    CoInitialize(nil);              // GDI+ 是套间线程模型
    try
      LocalLib := TPDFlib.Create;   // 每个工作线程一个私有实例
      try
        LocalLib.LoadFromFile(FileName, '');
        while True do
        begin
          IdxLock.Enter;            // 原子地领取下一页
          try
            PageNum := NextPage;
            Inc(NextPage);
          finally
            IdxLock.Leave;
          end;
          if PageNum > EndPage then Break;
          LocalLib.RenderPageToFile(DPI, PageNum, 0,
            Format('page_%d.png', [PageNum]));
        end;
      finally
        LocalLib.Free;
      end;
    finally
      CoUninitialize;
    end;
  end;
跨工作线程的结构化日志
调试一个在 500 页中的第 213 页挂掉的批处理,没有日志会很难受,而一个天真的日志本身就是并发缺陷。losLab PDF Library 提供了 TPDFlibLogger,通过 TPDFlib.Logger 属性挂接,默认为 nil,因此不用日志的路径保持零开销。它以回调为先:你设定 OnLog,把记录路由到宿主想要的任何地方,并按 llDebug / llInfo / llWarn / llError 级别过滤,而 PDFlibErrorMessage 把原始数字码转成人类可读的文本,于是一条 Error 记录读起来不只是一个光秃秃的整数。可选的文件汇聚点是唯一的共享资源,它由一个 TCriticalSection 守护,正是为了让多个工作线程能安全地往同一个日志文件里追加。请注意这条诚实的边界:只有那个文件汇聚点是同步的,所以如果你在自己手搓的池里共享一个 logger,而你的 OnLog 又碰了 UI,那你仍然得自己把它编排回主线程
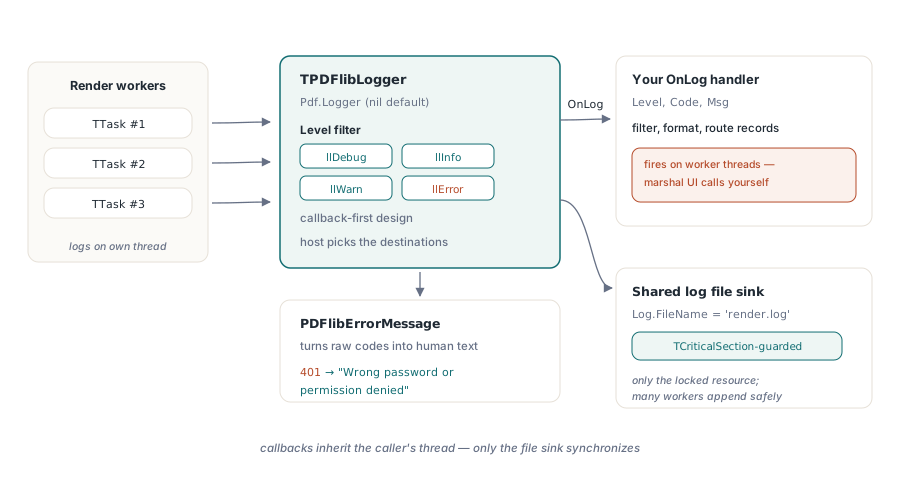
var
  Pdf: TPDFlib;
  Log: TPDFlibLogger;
begin
  Log := TPDFlibLogger.Create;
  Log.Level := llInfo;                   // llDebug、llInfo、llWarn、llError
  Log.FileName := 'render.log';          // 可选的共享汇聚点(有锁保护)
  Log.OnLog :=
    procedure(Level: TPDFlibLogLevel; Code: Integer; const Msg: WideString)
    begin
      if Level = llError then
        // 请自行编排到 UI 线程;OnLog 是在工作线程上触发的
        WriteLn(Format('[%d] %s', [Code, PDFlibErrorMessage(Code)]));
    end;
  Pdf := TPDFlib.Create;
  Pdf.Logger := Log;                     // 默认为 nil;不设时零开销
  try
    Pdf.RenderPagesToFilesParallel('report.pdf', '', 150.0, 1, 500, 0,
      'out\page_%p.png', 0);
    // 现在一条 Error 会带上文本,例如 401 -> "Wrong password or permission denied"
  finally
    Pdf.Free;
    Log.Free;
  end;
end;
你实际上该期待多大的加速?
请对时间花在哪里保持诚实,因为并行渲染只在工作真正受限于 CPU 时才划算。高 DPI 输出以及复杂的矢量或着色页面属于计算密集型,在把 CPU 喂饱之前它们的扩展接近线性。琐碎页面则是另一回事:在那里,每个工作线程的 LoadFromFile 开销,加上写出输出文件的磁盘开销,可能把渲染本身淹没掉,而八个工作线程一起折腾一块慢盘,完成得可能比一个干净的串行循环还慢。请把 MaxWorkers 设成你的物理核心数,而不是某个一厢情愿的数字;源 PDF 很大时要盯住内存;而如果某个批处理最终被证明是 IO 受限的,修法是换更快的存储或减少工作线程,而不是加更多线程。用在它所针对的那类作业上时,本文展示的批量渲染路径是面向 Delphi 与 C++Builder 的标准版 losLab PDF Library 的一部分,它能把闲置的核变成渲染完的页面,而不必让你自己去解决那些线程安全陷阱