FDF 注释导入器可能返回它解析到的条目数,却一条也没加进文档:每条都数了,每条都扔了。losLab PDF Library 的 TPDFlib.ImportAnnotationsFromFDFString 按任意顺序读键、正确且与区域设置无关地解析 /Rect,返回实际添加的注释数;配套的导出器写出注释真实的 /Rect,于是导出、导入、再导出得到逐字节相同的 FDF。本篇笔记余下部分解释一个错误的起始偏移如何造出一次完美的无声失败、它背后还藏着哪三个陷阱,以及如何自己验证导入而不是相信返回值
场景很日常。审阅人批注了一份合同,批注以 FDF 文件的形式传来(Acrobat 管这叫 Export Comments),你的 Delphi 服务用一次 FDF 导入调用把它们合并进一份干净副本。调用返回 7,日志写着「已导入 7 条批注」,任务变绿,输出 PDF 却一条批注都没有。没抛异常、没发警告,而那个数字看起来合理,因为它确实是文件里条目的真实计数。这是一个 bug 能呈现的最坏形状:一个函数唯一的成功信号是一个与它声称汇报的工作毫无关联地计算出来的计数器
FDF 导入为什么能报告成功却什么都没加?
因为名字读取器可以从错误的位置起步,而计数器可以住在干活代码之外。一个返回紧随 /Subtype 之后位置的键查找器,落在值前面的空白上。一个从这个空格开始、遇到第一个空白字符就停的 ReadName 什么都没读就停了,于是每个 subtype 都回来为空。像 AddAnnotationToPage 这样没有 subtype 就拒绝构建注释的辅助函数,孤立地看是正确的防御选择;但它若是一个没有返回值的过程、而调用方的 Inc(Result) 又在它外面,两道守卫合起来就把「什么都没成」变成「全都成了」。正确的名字读取器跳过空白、要求 PDF 名字对象的先导 /、并在任意定界符处停止——包括 [、( 和 )——于是 /Subtype/Text 和 /Subtype /Text 都得到 Text;losLab PDF Library 就是这么读名字的
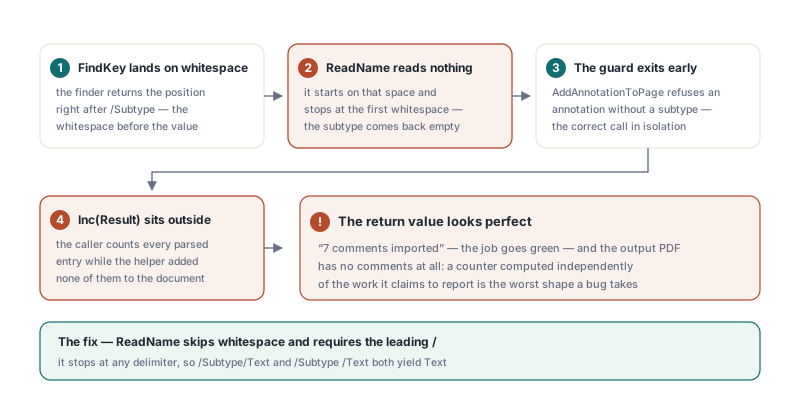
返回值本身也值得多加小心。对 /Annots 数组里每个格式良好的字典都递增的导入器,仍然会多报:条目可能带越界的 0 基 /Page 或缺失的 /Subtype,这两类都会被跳过。在 losLab PDF Library 里,ImportAnnotationsFromFDFString 和 ImportAnnotationsFromFDF 与 XFDF 导入一样,返回实际添加的注释数:FDF 辅助函数 AddAnnotationToPage 返回 Boolean,计数器只在成功时前进。量文档仍是更强的检查,因为无论数字出自哪段代码它都成立,所以下面的草图在导入前后对比每页的 AnnotationCount
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // 按选中页计,含 widget
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // 每个条目都落到页面上时相等
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
第一个陷阱背后的另外三个
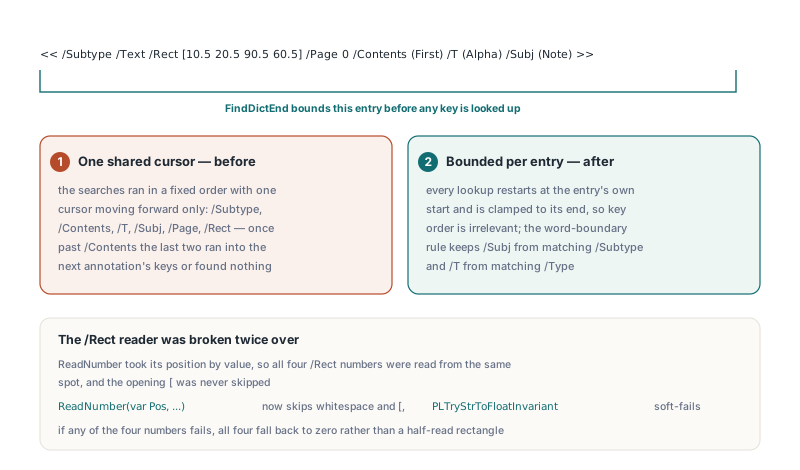
只修 subtype,同一种解析器里还有三个陷阱会露出来,只要没有任何注释真正落到页面上,它们就一直隐形。第一,把位置当值参数的 ReadNumber,为四个 /Rect 数字依次调用时会读同一个位置四次;如果它不跳过开头的 [,实践中它什么也读不到。第二,在所有查找之间共享一个只进不退游标的 FindKey 依赖键顺序。导出器可能按 /Subtype、/Rect、/Page、/Contents、/T、/Subj 书写,而导入器按 /Subtype、/Contents、/T、/Subj、/Page、/Rect 的顺序搜索;游标一旦越过 /Contents,对 /Page 和 /Rect 的搜索就跑过当前条目,要么一无所获、要么匹配到下一条注释的键——导入器连自己导出器的输出都读不了。第三,经跟随系统小数分隔符的例程(如 PLStrToFloat)解析的数字,在逗号区域设置的机器上出错。ISO 32000-1 §12.7.7 把 FDF 定义为 PDF 对象语法,而 PDF 的字典键是无序的(§7.3.7),所以任何假设键顺序的 FDF 解析器从构造上就是错的,无论文件出自哪个工具
losLab PDF Library 先给每个条目划定边界。FindDictEnd 从开 << 走到配对的 >>,跟踪嵌套字典、连同反斜杠转义一起跳过字面字符串体,于是注释里的 >>(比如 (see section >> 4))没法提前结束条目。之后每次键查找都从条目自身的起点开始、以它的终点为界,键顺序因此无关紧要,一条注释也借不到另一条的 /Page。键匹配还接受紧跟名字后面的定界符,因为 /Contents(Hi) 与 /Contents (Hi) 同样合法;而词边界规则保证 /Subj 不会匹配 /Subtype 的开头、/T 不会匹配 /Type。ReadNumber 把位置收成 var 参数,跳过空白和 [,用 PLTryStrToFloatInvariant 解析——遇到畸形 token 软失败而不是抛异常。四个矩形数字中任何一个失败,四个全部回落为零,不产出半个残缺矩形
FDF 往返为什么会让每条注释上移自己的高度?
因为在错误的坐标模型里写矩形太容易了。注释的 /Rect 在默认用户空间里是 [llx lly urx ury](ISO 32000-1 §12.5.2,矩形定义见 §7.9.5),FDF 带同样的数组。而 GetAnnotRectEx 报告的是库绘图坐标(SetOrigin 控制的那个空间)里的 Left、Top、Width、Height。把这几个值序列化成 [L T L+W T+H] 的导出器,交给导入器四个值;原样写回成 PDF 矩形时,顶边被放在左下角该在的位置,于是每轮往返都把注释向上抬自己的高度。losLab PDF Library 的导出器复制注释自己的 /Rect 数字——三位小数、点分隔、无指数——只有存储数组缺失或不是四个数字时才退回计算矩形
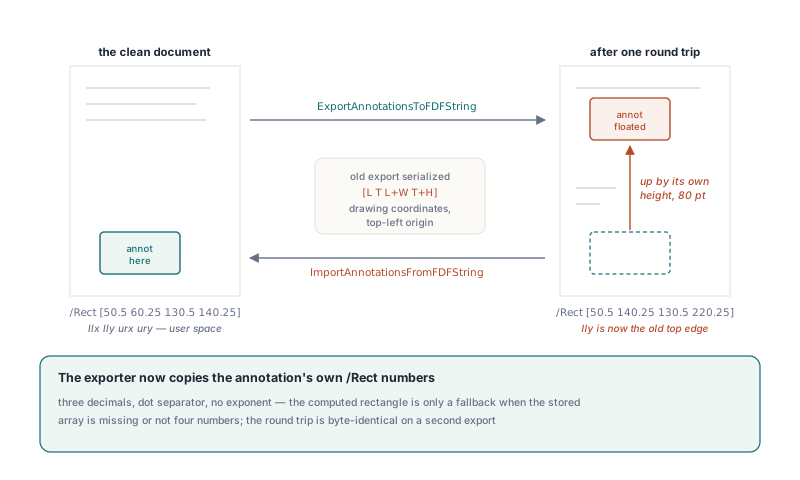
值得照抄的往返测试断言文档本身和第二次导出,而不是导入器的返回值。注意期望计数是 2:AddNoteAnnotation 创建一条 Text 注释外加它的 Popup,两者都会随行。这个测试还在逗号小数分隔符下运行导出和导入——本故事的另一半就住在这里
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // 现在有两页
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // 模拟德语或法语桌面
    try
      FDF := Source.ExportAnnotationsToFDFString;   // 照样写出 /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // 注释本体和它的 popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
FDF 路径围绕注释的核心字典构建。导入器以 /Type、/Subtype、/Rect、/Contents、/T 和 /Subj 重建每个条目;导出器把 Widget 注释留给表单数据方法——表单字段本就属于那边。在依赖 FDF 传递颜色、标志、边框样式、popup 链接或外观流之前,先看看FDF、XFDF 与 XFA 表单数据交换概览里「哪类数据走哪个方法」的全图;想检查实际到达了什么,GetAnnotType、GetAnnotTitle 和 GetAnnotContentsEx 这些按索引读取的方法见书签、注释与 action 内省
怎么读逗号小数的 FDF 和 XFDF 文件?
对 FDF 答案毫不含糊:逗号不是 PDF 语法里的分隔符,所以恰好含一个逗号、不含点的数字 token 只能是逗号区域设置机器上写出的小数。这种文件确实存在,比如来自用系统区域格式化数字的导出器的 /Rect [10,500 20,250 40,750 60,125],ReadNumber 会在解析前把那一个逗号换成点。带两个逗号、或一个逗号加一个点的 token 会被拒绝,而不是瞎猜。读取器也不消费指数记号,这与 ISO 32000-1 §7.3.3 一致:PDF 数字从不用指数
XFDF 更难,因为在 XML 属性里逗号就是分隔符。标准 XFDF(ISO 19444-1)写 rect="50.5,80.25,70.75,100.125" 和 dashes="4,2",而逗号区域设置系统上依赖区域的写出器会产出 rect="50,500 80,250 70,750 100,125" 和 opacity="0,600"。losLab PDF Library 读写 XFDF 数字时两个方向都用不变区域设置,只在属性按空白拆分后恰好得到期望数量的 token(rect 四个、opacity 和 width 各一个)且每个 token 都形如「数字-逗号-数字」时,才经 XFDFNormalizeLegacyDecimals 识别遗留形状。标准 rect 永远不会命中:它要么是带三个逗号的单个 token,要么是逗号结尾的 token。dashes 被刻意放过不动,因为 4,2 既可能是两段虚线长度、也可能是遗留的 4.2,没有规则能区分它们
const
  // 键序与导出器不同,外加来自逗号区域设置导出的逗号小数
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // 新文档有一页
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // 以点小数再导出为 XFDF:rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
注释导入测试到底该断言什么?
有用的导入测试断言目标文档的状态,绝不只断言导入器对自己的描述;在无声零失败里,返回值恰恰是唯一毫发无损的数字。三条断言抓住本文描述的每个陷阱:期望页面上的注释计数、经 GetAnnotType 或 GetAnnotContentsEx 读回的一个字段,以及与第一次逐字节比较的第二次导出。同样的纪律适用于任何批量重写文档结构的 API,包括合并重复表单字段所述的字段整合:查结果树,不查返回总数。FDF 与 XFDF 注释方法连同其文件与字符串变体,随 losLab PDF Library for Delphi and C++Builder 交付