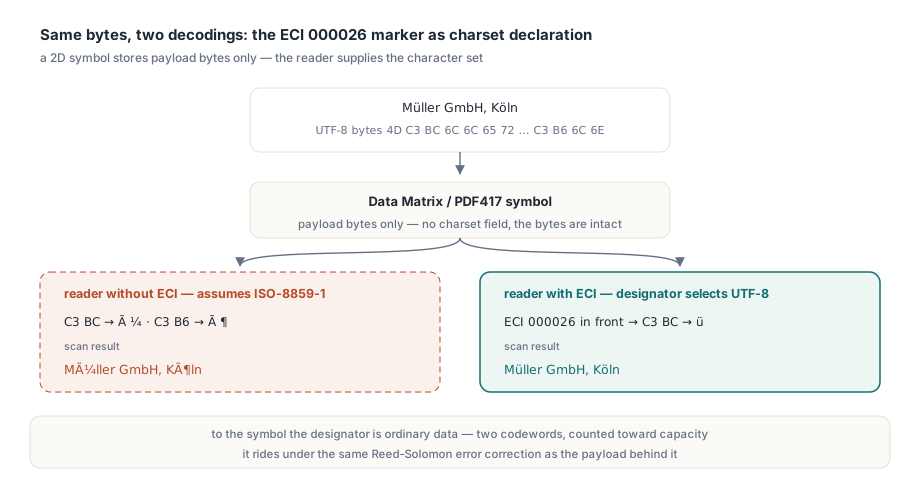
仓库标签把收货人 Müller GmbH, Köln 以 UTF-8 存进 Data Matrix 符号,车间里每一把手持扫描枪读回来的却是 Müller GmbH, Köln。把 PDFlibPas 的 BarcodePayloadEncoding 属性设为 bpeUTF8WithECI,数据前面就会写入一个 ECI 000026 标记,Data Matrix 和 PDF417 读码器据此把这些字节按 UTF-8 解码
为什么 UTF-8 负载会解码成 Müller?
符号里没有任何字符集声明,读码器只能退回该码制的默认单字节字符集,对 Data Matrix 来说就是 ISO-8859-1。UTF-8 的 ü 是 C3 BC 两个字节,ISO-8859-1 把它们映射成 à 和 ¼;ö 同样道理变成 ö。字节本身完好无损。Extended Channel Interpretation 就是条码世界的字符集声明:AIM 的 ECI 注册表给每个字符集编号,000026 是 UTF-8,符号开头带上 ECI 指示符,合规的读码器就会把其后所有内容按该字符集解码。对符号本身而言,指示符只是普通数据。在本文讨论的两种码制里它都占两个码字,计入容量,且与身后的负载受同一套 二维条码 Reed-Solomon 纠错保护
ECI 码字在 Data Matrix 与 PDF417 中的位置
每种码制都给标记留了固定槽位,放错位置,符号要么解不出来,要么开头解出一串乱码:
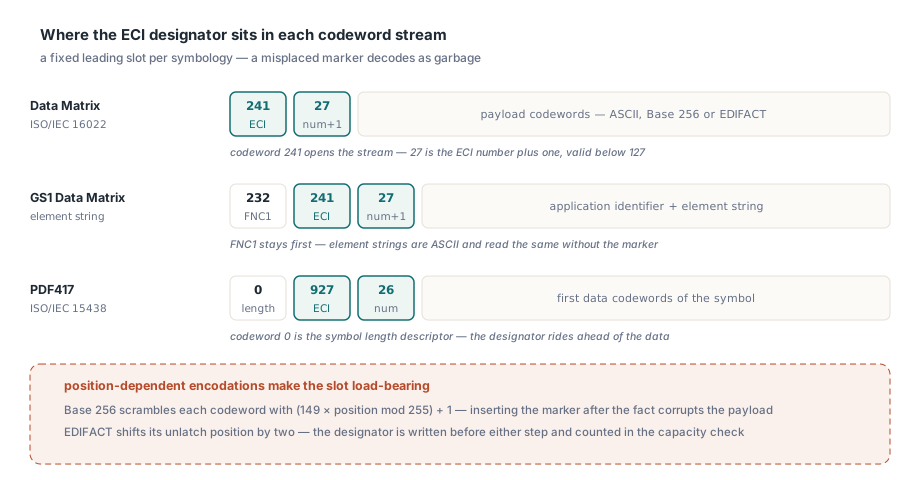
- Data Matrix(ISO/IEC 16022):先写码字 241,再按低于 127 的单码字形式写 ECI 编号加一,UTF-8 就是 27。它位于数据流的最前面
- GS1 Data Matrix:FNC1(码字 232)必须留在第一位,所以你要求加标记时 PDFlibPas 把它紧挨在 FNC1 之后;不过 GS1 元素串取自 ASCII 的一个子集,不加标记读出来也一样
- PDF417(ISO/IEC 15438):码字 0 是符号长度描述符,标记紧随其后,写作码字 927 和 26,位于第一个数据码字之前
Base 256 是难啃的骨头。这种编码是 Data Matrix 存任意字节的紧凑模式,它用一个伪随机值打乱每个码字,伪随机值由码字在符号里的绝对位置推出,即 (149 × position mod 255) + 1。要是在打乱之后才把标记插到前面,其后每个字节被打乱时所用的位置都比读码器看到的位置早两位,整段负载还原出来全是错值。EDIFACT 编码有同一个依赖的温和版本——标记插到前面后,它的 unlatch 位置要后移两位。PDFlibPas 在这两步运行之前就把标记写进码字流,挑选符号尺寸的容量检查也已把它计入。两种码制的标签代码如下:
uses
  SysUtils, PDFlibrary;

procedure PrintConsigneeLabel(const FileName: string);
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.NewDocument;                                // 创建并选中第 1 页
    Pdf.SetPageSize('A4');
    Pdf.SetMeasurementUnits(1);                     // 毫米
    Pdf.SetOrigin(1);                               // Top 自顶边量起

    Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;   // UTF-8 字节 + ECI 000026
    if Pdf.DrawDataMatrixSymbol(20, 20, 0.5, 'Müller GmbH, Köln',
      1,      // Encoding: 1 = ASCII 编码
      0,      // SymbolSize: 0 = 表中第一个装得下的尺寸
      100) <> 1 then                                // 正常方向,默认 1 模块静区
      raise Exception.CreateFmt('Data Matrix failed (%d)', [Pdf.LastErrorCode]);

    if Pdf.DrawPDF417SymbolEx(20, 50, 'Zustellung: Müller GmbH, Köln',
      0, 0, 0,  // 方向、列数、行数:自动
      -1,       // 纠错级别自动
      0.3, 3.0) <> 1 then
      raise Exception.Create('PDF417 failed');

    // 支持 ECI 的扫描枪对两个符号都应返回德文文本
    Pdf.BarcodePayloadEncoding := bpeSystemANSI;    // 恢复默认
    Pdf.SaveToFile(FileName);
  finally
    Pdf.Free;
  end;
end;
NewDocument 已经创建并选中了第 1 页,所以不用调 NewPage,符号就直接落在第一页。SetOrigin(1) 把原点移到左上角,Top 从此表示符号顶边到页顶的距离。默认的左下原点下,Top 写 10 mm 意味着顶边在纸底边以上 10 mm,一个 11 mm 高的符号就会悬出纸外。DrawDataMatrixSymbol 成功时返回 1。遇到编不了的数据——算上标记后负载超出最大符号,或你指定了放不下的固定尺寸——它返回 0,把 LastErrorCode 置为 302,什么都不画,所以示例把不等于 1 一律当错误处理
每张标签都该带 ECI 标记吗?
不该,默认值也反映了这一点。BarcodePayloadEncoding 有三个取值,各自适配不同的读码器群体:
bpeSystemANSI(默认)把文本经系统 ANSI 代码页转换且不写标记,用 PDFlibPas QR、PDF417 与 Data Matrix 函数搭出来的标签版式就是这么预期的bpeUTF8写 UTF-8 字节但不带标记,适合封闭系统——读条码的是你自己的软件,本来就按 UTF-8 理解bpeUTF8WithECI写 UTF-8 字节并用 ECI 000026 标注它们
什么都标注的代价是读码器支持。ECI 处理在许多扫描枪上是个配置项,设置不同,设备可能拒收符号,也可能把指示符当文本传给主机:按 AIM 约定是反斜杠加六位数字,于是应用收到 \000026Müller GmbH, Köln。正确的做法是按符号开关标记——负载含非 ASCII 文本时才开,并和扫描枪配置的变更一起上线。如果所有姓名都放得进读码器默认的代码页,单字节负载依然是合理选择。ü 在 Windows-1252 和 ISO-8859-1 里都是字节 FC,所以在西欧 Windows 系统上用 bpeSystemANSI 写下的德文地址,在一台从没听说过 ECI 的 Data Matrix 读码器上照样解得对。日文文本没有这种退路
符号尺寸:自动选择、固定模板与矩形
标记的两个码字很少单独发力。ASCII 编码下,bpeSystemANSI 的收货人行把 ü 和 ö 当作高于 127 的单字节,各花两个码字,整行共 19 个码字,20×20 符号有 22 个数据码字,装得下。换成 UTF-8,这两个字母变成四个高位字节,整行要 23 个;标记加上后是 25,就得用 22×22——而且光 UTF-8 字节就足以跨出这一步,23 已经溢出 20×20。把 SymbolSize 固定在 9(20×20)的模板,一旦编码方式变了,DrawDataMatrixSymbol 就返回 0 和错误 302,条码槽位上什么都没画
自动选尺寸可能改变形状。SymbolSize 为 0 时,PDFlibPas 按 ISO/IEC 16022 的尺寸列表顺序找第一个数据容量装得下该流的条目。六个矩形尺寸就排在方形之间的那个列表里。原本装满 26×26 符号的负载(44 个数据码字)加上标记要 46,列表里下一个装得下 46 的条目是 49 容量的 16×48,排在 62 容量的 32×32 之前。每模块 0.5 mm 时,13 mm 的方块变成 8 × 24 mm 的长条。装满的 22×22 同理:30 个码字加两个,落进 16×36。小负载仍是方形——原本装满 10×10 的三个码字变成五个,12×12 装得下,而它在列表里排在 8×18 之前。如果标签版式只留了方形槽位,就把 SymbolSize 钉死在你承受得起的方形上(32×32 用 16),名字太长时让错误 302 来报告;能接受两种形状的版式才适合自动选尺寸
PDF417 的增长规则不同。ErrorLevel 为 -1 时,编码器按 ISO/IEC 15438 的推荐最低纠错级别规划纠错,这些级别在 41、161 和 321 个码字处上调,长度描述符也计入。39 个码字的流加上标记变成 41,最低级别从 2 升到 3,规划的纠错块从 8 个码字涨到 16 个——多出十个码字。列数和行数自动时,编码器按这个更大的总数排布矩形,所以恰好卡在台阶下方的负载,面积涨幅远超两个标记码字给人的预期
哪种编码能让 UTF-8 Data Matrix 更小?
直接对比两种成本。ASCII 编码把一对数字塞进一个码字,普通 ASCII 每字符一个码字,但每个高于 127 的字节要花两个:一个 Upper Shift(235)加字节减 127。Base 256 一次性付出一次 latch 和长度字段——不超过 249 字节时一个长度码字,再多就两个——之后每字节一个码字,没有数字压缩。不含数字串的文本,负载攒够三个高位字节,Base 256 就占上风;Müller 那一行已经满足,21 个码字对 23 个。长数字串把天平拉回 ASCII,因为那里每对数字省一个码字。下面的辅助函数把两种成本都算一遍,用更省的模式绘制;纯 ASCII 则完全不加标记,因为它在任何字符集下读出来都一样:
// 用更省的编码为 Unicode 文本绘制 Data Matrix
function DrawUnicodeDataMatrix(Pdf: TPDFlib; Left, Top, ModuleSize: Double;
  const Text: WideString): Integer;
var
  Bytes: UTF8String;
  I, HighBytes, AsciiCost, Base256Cost, Mode: Integer;
  Saved: TPDFlibBarcodePayloadEncoding;
begin
  Bytes := UTF8Encode(Text);
  HighBytes := 0;
  AsciiCost := 0;
  I := 1;
  while I <= Length(Bytes) do
  begin
    if (I < Length(Bytes)) and (Bytes[I] >= '0') and (Bytes[I] <= '9') and
       (Bytes[I + 1] >= '0') and (Bytes[I + 1] <= '9') then
    begin
      Inc(AsciiCost);                    // 数字对:一个码字
      Inc(I, 2);
      Continue;
    end;
    if Ord(Bytes[I]) > 127 then
    begin
      Inc(HighBytes);
      Inc(AsciiCost, 2);                 // Upper Shift +(字节 - 127)
    end
    else
      Inc(AsciiCost);
    Inc(I);
  end;
  if Length(Bytes) <= 249 then
    Base256Cost := Length(Bytes) + 2     // latch + 一个长度码字
  else
    Base256Cost := Length(Bytes) + 3;    // latch + 两个长度码字

  Saved := Pdf.BarcodePayloadEncoding;
  try
    if HighBytes = 0 then
    begin
      Pdf.BarcodePayloadEncoding := bpeSystemANSI;  // 纯 ASCII:无标记
      Mode := 1;
    end
    else
    begin
      Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;
      if Base256Cost < AsciiCost then
        Mode := 3                        // Base 256
      else
        Mode := 1;                       // ASCII
    end;
    Result := Pdf.DrawDataMatrixSymbol(Left, Top, ModuleSize, Text, Mode, 0, 100);
  finally
    Pdf.BarcodePayloadEncoding := Saved;
  end;
end;
東京都千代田区 的 UTF-8 形式是 21 个字节,个个高于 127。加上标记,Base 256 需要 25 个数据码字,ASCII 编码要 44 个;按容量表,同样的模块尺寸下是 22×22 符号对 26×26 符号的差别。那个 26×26 是满的,再多一个码字就跳到 16×48。GS1 负载(模式 7)不归这个辅助函数管,因为它的元素串是 ASCII。QR 码的数据模式经由 DrawQRCode 的 EncodeOptions 参数指定,而 PDFlibPas 画的 Aztec 符号,只要负载字节是合法 UTF-8 且至少含一个非 ASCII 字符,就自动带上 ECI 26 旗标
对 Müller 这一行,标记花掉两个码字,而从 20×20 到 22×22——0.5 mm 模块下从 10 mm 到 11 mm——是 UTF-8 字节造成的。只要标签槽位有这多出的一毫米,就在收货人符号绘制之前,把 PDFlibPas Delphi PDF Library 的 TPDFlib 实例上的 BarcodePayloadEncoding 设为 bpeUTF8WithECI,同一页上的老符号再改回 bpeSystemANSI