一个把生成多项式常数项存前面、却又按首项优先做除法的 Reed-Solomon 编码器,根本不是在计算纠错。HotPDF 恰恰在四个 2D 条码编码器——QR、Data Matrix、PDF417 和 Aztec——里带着这种实现发布过,它们产出的每个符号都带着一个任何合规扫描器都用不了的校验块
有意思的部分不是算术上的失误,而是传播。先写了第一个编码器,它的除法循环被复制进后面三个,每个新格式都继承了一个从未对着任何公开发布的测试向量验证过的缺陷。符号照样渲染,finder 图案待在正确的位置,尺寸也正确。只有让 2D 条码扛过污渍的那几个字节是垃圾
一个被反转的多项式,复制进四个编码器
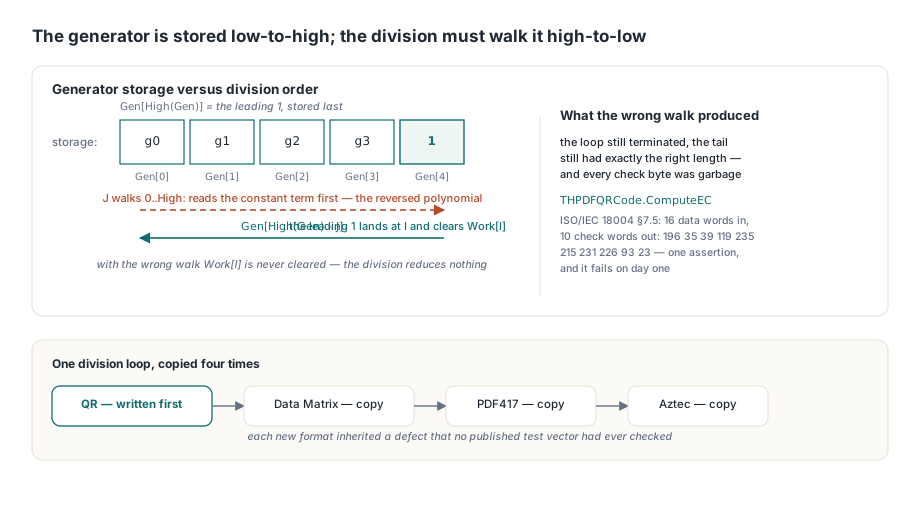
根因是综合除法循环里的存储顺序不匹配。四个 HotPDF 编码器都按从低到高构建生成多项式系数,所以 Gen[0] 存常数项、Gen[High(Gen)] 存首一的最高次系数。除法循环遍历消息时正向索引 Gen[J],这在算术上等同于用反转的多项式做除法。还有第二个后果把第一个藏了起来:因为最高次系数从来不会落到位置 I,Work[I] 从不会被清零,所以除法实际上什么都没约减。循环照样终止,也照样用长度完全正确的数组填满了尾部
// HPDFQRCode.pas 中的 THPDFQRCode.ComputeEC
Gen := GeneratorPoly(ECCount);            // Gen[0] 是常数项
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] 是清除 Work[I] 的首位 1;正向遍历 Gen
  // 正向遍历则改为除以反转后的多项式
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
修复就是单个索引表达式 Gen[High(Gen) - J]。改完之后,THPDFQRCode.ComputeEC 能复现 ISO/IEC 18004 §7.5 的工作示例:版本 1-M 的 byte-mode 块 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 得到十个校验字 196 35 39 119 235 215 231 226 93 23。这只是一条断言,而它在第一天就会失败
为什么 Aztec 符号连数据都丢了?
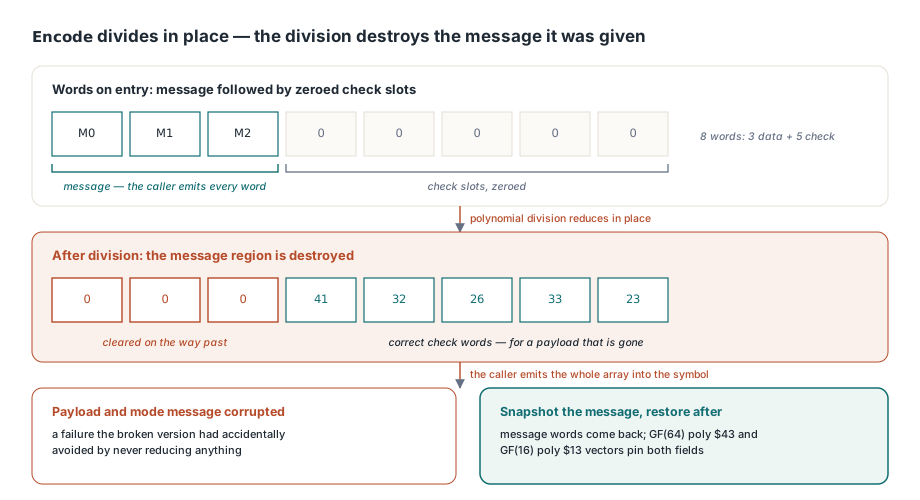
Aztec 背着同一 bug 的更重版本,因为 TAztecGF.Encode 是就地除法。例程收到保存着消息、后面跟着清零校验槽的 Words,调用方把这个整个数组发进符号。多项式除法在约减时会销毁被除数,所以一旦循环被修成真正做约减,消息字就一路被覆盖了。数据和 mode message 双双损坏——这是坏版本因为从不约减任何东西而意外避开的失败
// HPDFAztec.pas 中的 TAztecGF.Encode
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// 除法会清空消息区域,但调用方会把整个
// 数组写入符号,因此数据字必须放回去
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec 用两个不同的域,回归夹具把两者都覆盖了。在 GF(64)——由本原多项式 $43 构建的六位符号的域——里,字 12 45 3 配上五个校验字产出 41 32 26 33 23,而前三个保持不变。在 GF(16)——mode message 的域,本原多项式 $13——里,字 5 9 产出 11 15 6 8。两者都通过 HPDFAztecTestEncode 钩子对照 ISO/IEC 24778 跑
为什么 Data Matrix 需要两处修复而不是一处?
THPDFDataMatrix.ComputeEC 在共有的错误之上又叠了一个独立的错误:它用从 α^0 开始的根构建生成多项式,而 ISO/IEC 16022 附录 E 规定根从 α^1 起。只修除法索引,标准示例会得到校验字 146 107 90 179 128——看起来和正确值一样可信,却照样不可读。两个缺陷都得清掉,数字才对得上
// HPDFDataMatrix.pas 中的 THPDFDataMatrix.ComputeEC
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]:根从 alpha^1 到 alpha^ECCount,而非从 alpha^0 开始
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;参考点小到可以写进注释。'123456' 编码成 ASCII 码字 142 164 186,10x10 符号带五个校验字,正确的块是 114 25 5 88 102。HPDFDataMatrixTestComputeEC 暴露了 {$IFDEF HPDF_TESTING} 门后面的类函数,所以夹具无需实例化编码器或渲染页面就能断言这五个值。Galois 域本身——由 InitDMTables 用本原多项式 $12D 构建进 DMExp 和 DMLog 表——自始至终都是对的,这正是 bug 藏得那么深的原因
PDF417 在素数域上做除法,符号很重要
PDF417 需要四处修改而不是一处,因为 GF(929) 是素数域而不是二元扩域:加法不是 xor、减法不是加法,每个生成因子的符号是真正的算术而不是记号。每个因子必须是 (x - 3^i),在代码里意味着乘以 929 - GF929Pow(3, I);约减步骤必须做减法;根按 ISO/IEC 15438 §5.5 从 3^1 起;Factor 必须在内层循环开跑前锁进局部变量,因为 J = 0 那一轮会写 Work[I],否则会在自己脚下换掉乘数。HPDFPDF417TestComputeEC 钉住了修正后的结果:码字 5 453 178 121 239 配上四个纠错字得到 452 327 657 619
// HPDFPDF417.pas 中的 THPDFPDF417.ComputeEC
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // 因子是 (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 rewrites Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Data Matrix 的 finder 装反了
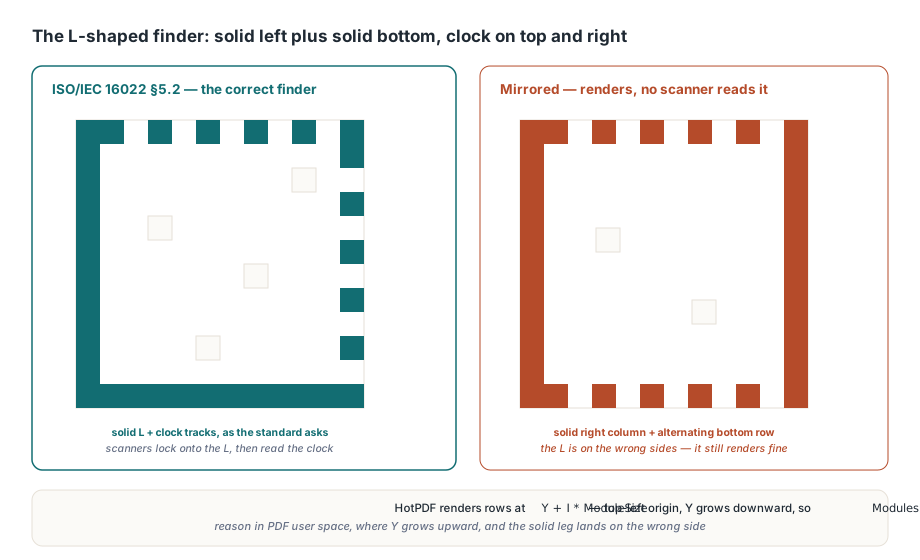
正确的校验字救不了一个 finder 图案镜像的符号,同一个发布里也得修这个。placement 代码画了实心左列、实心右列,以及沿顶行和底行交替的模块;而 ISO/IEC 16022 §5.2 要的是实心左列加实心底行——即 L 形 finder——交替时钟轨沿顶行和右列走。容易搞反的根源是坐标约定:HotPDF 在 Y + I * ModuleSize 渲染模块行,这是左上角原点语义,所以 Modules[Size - 1, *] 是打印符号的底行。任何按 PDF 用户空间(Y 向上增长)推理的人都会把实心腿放到错的一边,而且屏幕上看不出任何异样
为什么四个有缺陷的编码器通过了多年的测试?
因为测试断言的是结构,而缺陷在算术里。既有的 QR、Data Matrix 和 Aztec 用例检查 finder 模块、时序图案和符号尺寸,这些全都是真的正确的;从来没有一个测试把校验字和公开发布的向量做过比较。第二个原因普适性更强。HotPDF 自带内置 QR 解码器,拿它来验证编码器感觉像是一目了然的往返测试——只不过这个解码器只读数据码字、不做任何 Reed-Solomon 纠错,所以它把编码器写的东西原样读回来然后报告成功。当编码器和解码器共享同一个假设时,往返测试证明的是它们彼此一致,而不是谁是对的。纠错码必须对照印在标准里的向量验证,绝不能对照你自己的解码器。夹具 THPDFBarcodeECCTests 现在每个格式一个测试,每个都以它钉住的东西命名,每个都通过只在 {$IFDEF HPDF_TESTING} 下编译的钩子触达算术:
QRCheckWordsMatchISO18004Example断言版本 1-M byte-mode 示例的十个校验字DataMatrixCheckWordsMatchISO16022Example为码字 142 164 186 断言 114 25 5 88 102PDF417CheckWordsMatchGF929Reference在 GF(929) 上以 3^1 到 3^4 的根断言 452 327 657 619AztecCheckWordsKeepMessageAndMatchReference断言校验字,并断言消息字在就地除法后仍然存活
四个问题能抓住你维护的任何编码器里这类家族的大部分。你的生成多项式存储顺序和除法索引顺序一致吗,你能指出证明它的一行吗?根从标准规定的地方开始吗——Data Matrix 是 α^1、PDF417 是 3^1?就地除法事后恢复消息区域了吗?至少有一个测试把校验字——而不是模块数量——与印在规范里的数字比较过吗?决定怎么处理既有产物时,范围也很重要。v2.748.0 之前生成的符号能渲染,理想条件下也常常能扫出来,因为干净的图像不需要纠错就能读;它们失去的是选择这些格式的全部理由——抗损能力。携带受影响符号的长期标签和归档文档值得重新生成,而不是拿手机摄像头抽查。这些编码器住在 HotPDF 的条码支持里,与 QR 解码路径及其方向处理和把符号放到页面上的 report 输出层 为邻;完整条码 API 参考随 HotPDF Delphi Component 一起交付,适用于 Delphi 和 C++Builder