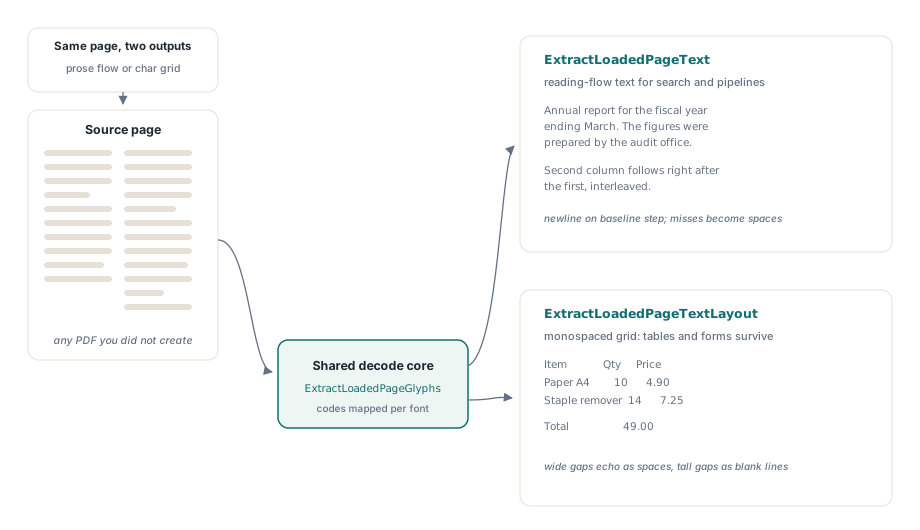
HotPDF Delphi Component вилучає текст Unicode з будь-якого PDF, який ви завантажили в Delphi, через два виклики: ExtractLoadedPageText повертає текст сторінки в порядку читання, а ExtractLoadedPageTextLayout (доданий у v2.263.0) відтворює візуальне розташування сторінки як звичайний текст, тож колонки, відступи та вирівнювання таблиць виживають у виводі. Обидва працюють із документами, яких HotPDF не створював, а це саме той випадок, який справді має значення: рахунок, надісланий клієнтом поштою, звіт, зданий бюро сканування, договір, згенерований програмою, назви якої вже ніхто не пригадає
Щоб дійти до цього, знадобилося більше механіки, ніж підказують ці два підписи, бо PDF зберігає текст не так, як текстовий файл. Ця стаття проходить обидва режими вилучення, а потім відкриває капот над трьома вузлами під ними — читачем CMap, інтерпретатором потоку вмісту та ланцюжком запасних шляхів декодування шрифтів — бо розуміння того, як працює відображення, є різницею між знизуванням плечима над сміттям у виводі та його діагностикою
Чому вилучення тексту складніше, ніж читання рядків із файлу?
Потік вмісту PDF записує коди символів, а не символи. Оператори Tj та TJ (ISO 32000-1 §9.4.3) несуть рядки байтів, значення яких повністю залежить від шрифту, обраного попереднім Tf: байт 0x41 може бути літерою A в WinAnsi, довільним гліфом у шрифті-підмножині або половиною двобайтового CID у складеному шрифті CJK. ISO 32000-1 §9.10 визначає вилучення тексту саме як цю задачу декодування — відображення кожного коду назад на Unicode за допомогою будь-якої інформації, яку надає словник шрифту — і стандарт прямо каже, що відповідний файл не зобов'язаний надавати досить інформації, щоб це зробити
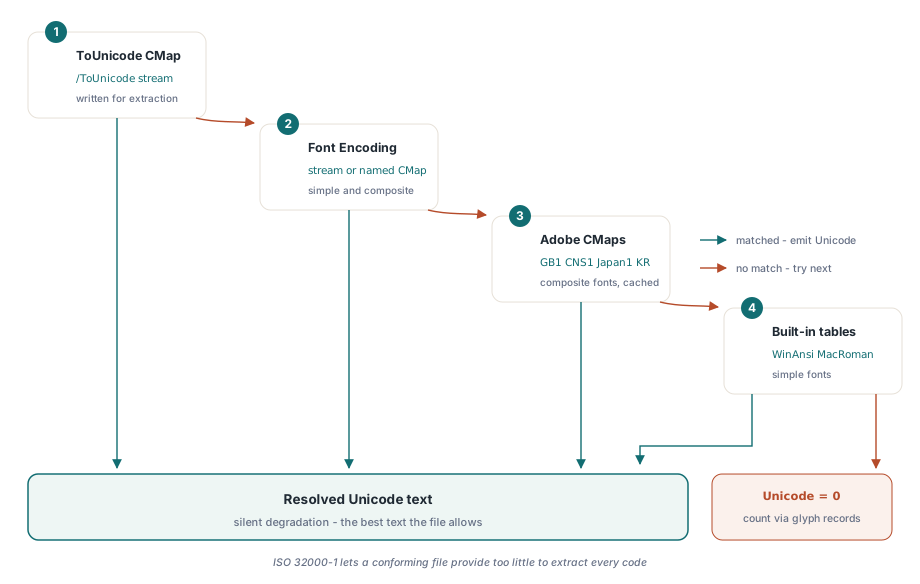
Саме це останнє застереження пояснює кожен звіт про ваду "чому копіювання з цього PDF дає абракадабру", який ви коли-небудь бачили. Виробник, який вбудовує шрифт-підмножину без таблиці /ToUnicode, записав файл, що рендериться бездоганно, а вилучається безглуздям, бо відображення коду на гліф існує, а відображення коду на Unicode ніколи не постачалося. Тому будь-який чесний API вилучення є ланцюжком спроб за принципом найкращих зусиль, а корисне питання полягає в тому, наскільки глибокий цей ланцюжок
Вилучення в порядку читання через ExtractLoadedPageText
Для індексації пошуку, зіставлення за ключовими словами чи подавання тексту в конвеєр аналізу вам потрібен саме ExtractLoadedPageText. Підпис такий: function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean — індекси сторінок нумеруються з нуля, результат надходить як нативний UnicodeString з Delphi, а функція повертає False, коли сторінка не має читабельного потоку вмісту, замість того щоб піднімати виняток
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
    // AllText тепер містить текст документа в порядку читання
  finally
    Pdf.Free;
  end;
end;
Переноси рядків у виводі походять від навмисно простої евристики: коли вертикальний початок гліфа зсувається більш ніж на половину поточного розміру шрифту — ознака кроку Td чи T* у потоці вмісту — вставляється новий рядок. Символи, які декодер не може розв'язати, стають пробілами, а не зникають, тож межі слів виживають навіть тоді, коли окремі гліфи ні. Чого цей режим не намагається робити, так це кластеризації порядку читання чи виявлення колонок: сторінка у дві колонки виходить перемішаною в порядку потоку вмісту, який зазвичай, але не завжди, збігається з візуальним порядком
Коли натомість варто брати вилучення зі збереженням компонування?
ExtractLoadedPageTextLayout є правильним викликом щоразу, коли позиція несе зміст: таблиці, форми, лістинги коду, будь-що, що ви збираєтеся порівнювати, грепати чи розбирати по колонках. Замість того щоб сплющувати гліфи в потік, він кластеризує їх у базові лінії, сортує кожну базову лінію за X і відтворює горизонтальні та вертикальні пробіли на моноширинній символьній сітці, розмір якої береться з медіанного просування гліфа й розміру шрифту. Широкі проміжки між серіями на одній базовій лінії стають серіями пробілів; великі проміжки між базовими лініями стають порожніми рядками. Результат читається так, як сторінка виглядає
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Колонки, відступи та вирівнювання таблиць виживають як
  // пробіли та порожні рядки на символьній сітці
end;
Обидва режими поділяють кожен байт механіки декодування й різняться лише тим, як вони розкладають декодовані гліфи, тож вибір нічого не коштує в точності. Обирайте ExtractLoadedPageText, коли важать лише слова, і ExtractLoadedPageTextLayout, коли важить розташування. Виявлення порядку читання для кількох колонок лишається поза межами обох — сіткове відтворення сторінки у дві колонки показує вам обидві колонки поруч, достеменно, і для порівняння це саме те, що треба, а для переливання прози ні
Як HotPDF декодує коди символів у Unicode?
HotPDF Delphi Component розв'язує кожен код символу через ланцюжок запасних шляхів, упорядкований за пріоритетом: спершу вбудований у шрифт CMap /ToUnicode, потім запис /Encoding (потік або іменований CMap), потім — для складених шрифтів — стандартні файли CMap від Adobe для наборів символів на кшталт Adobe-GB1, Adobe-CNS1, Adobe-Japan1 та Adobe-KR, і нарешті вбудовані таблиці WinAnsi та MacRoman для простих шрифтів. Стратегія, яка не може дати відповіді, мовчки деградує до наступної, а не піднімає виняток, а код, що вичерпав увесь ланцюжок, розв'язується в 0, тож викликач може рахувати промахи замість того, щоб гадати
CMap /ToUnicode (ISO 32000-1 §9.10.3) стоїть першим, бо це те єдине відображення, яке виробник написав спеціально для вилучення. Шлях стандартних CMap від Adobe важить для документів CJK, які використовують наперед визначені CMap на кшталт UniGB-UTF16-H замість того, щоб щось вбудовувати: HotPDF постачає файли наборів у своїй теці resources\CMap, знаходить їх відносно виконуваного файлу під час роботи й кешує кожну розібрану мапу на процес — це варто знати, бо найбільша з них, мапа Adobe-GB1, є приблизно 2 МБ вихідного тексту, який ви не захочете розбирати заново на кожній сторінці. Якщо теки немає, декодер просто пропускає CMap із диска й працює з вбудованими таблицями плюс вбудованими кодуваннями. Це читацьке дзеркало задачі шейпінгу, розглянутої в шейпінгу тексту складних писемностей у HotPDF, де та сама різниця між кодом і гліфом постає під час запису
Дві синтаксичні пастки CMap, які варто знати
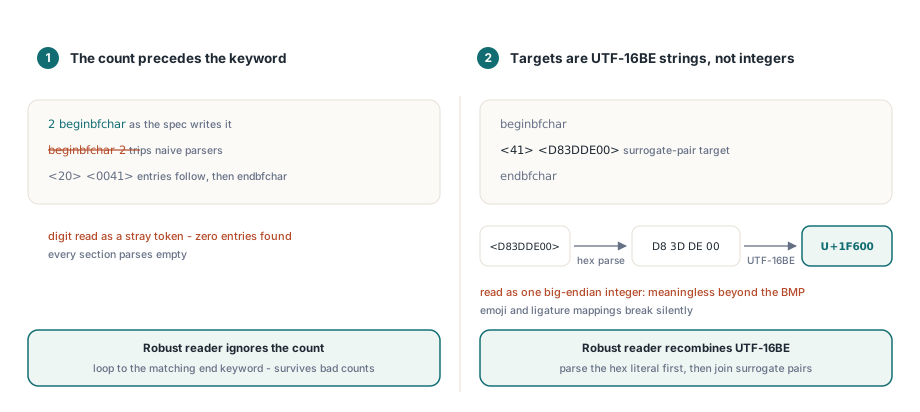
Файли CMap виглядають тривіально розбірними, але такими не є, і дві деталі пояснюють більшість невдач розбирачів із першої спроби. Перша полягає в тому, що кількість записів іде перед ключовим словом секції: секція читається як 2 beginbfchar, а не beginbfchar 2. Розбирач, який очікує кількість після ключового слова, споживає число як випадковий токен, а потім знаходить нуль записів у кожній секції. Надійний підхід — той, на якому зупинився читач HotPDF, — полягає в тому, щоб узагалі ігнорувати лічильник і крутити цикл до відповідного ключового слова endbfchar / endbfrange, що на додачу дає терпимість до реальних файлів, чиї лічильники просто неправильні
Друга пастка в тому, що цілі bfchar та bfrange є рядками UTF-16BE, а не цілими числами. Призначення <D83DDE00> означає U+1F600 — сурогатну пару, яку треба зібрати назад в одну кодову позицію — і читання цих чотирьох байтів як цілого числа з порядком байтів big-endian дає безглузде значення для кожної кодової позиції поза Basic Multilingual Plane. Емодзі в PDF більше не є екзотикою, тож декодер, який пропускає збирання сурогатів, падає на файлах, які ваші користувачі справді мають. HotPDF спершу розбирає шістнадцятковий літерал у сирі байти, а потім збирає кодові одиниці UTF-16BE, що також покриває багатосимвольні цілі, які породжують відображення лігатур
Спуск на рівень гліфів через ExtractLoadedPageGlyphs
Обидва текстові виклики побудовані на ExtractLoadedPageGlyphs, і базовий THPDFGlyphArray доступний і вашому коду. Кожен THPDFGlyphRecord несе розв'язану кодову позицію Unicode поряд із сирим кодом символу, байтову ширину коду (1, 2 чи 4, визначену через codespacerange у CMap), ключ і розмір активного ресурсу шрифту, X та Y початку в користувацькому просторі й горизонтальне просування. Цього досить, щоб побудувати виявлення меж слів, позиційне підсвічування чи власний алгоритм компонування, не торкаючись потоку вмісту самотужки
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Підрахунок записів із Unicode = 0, як вище, є чесним способом виміряти якість вилучення на конкретному документі, перш ніж довіряти тексту далі за течією. Записи гліфів також прив'язують кожен символ до вихідного операнда в потоці вмісту, і саме це робить можливими пошук і заміну тексту в завантаженому документі HotPDF на тому самому фундаменті
Які PDF не віддадуть свій текст?
Деякі файли долають будь-який вилучувач, і краще виявити їх, ніж відвантажити їхній вивід. Скановані документи є найпростішим випадком: сторінка, яка є одним великим зображенням, узагалі не містить текстових операторів, тож вилучення правильно повертає порожній рядок — ліками тут є OCR, а вилучення зображень сторінок із завантаженого PDF є першим кроком того конвеєра. Шрифти-підмножини без таблиці /ToUnicode є складнішим випадком: якщо шлях /Encoding і стандартні CMap теж нічого не дають, ті гліфи розв'язуються в 0 і випливають як пробіли у текстових викликах. Зашифровані документи вилучаються нормально за умови, що ви завантажуєте їх із паролем через перевантаження LoadFromFile, тож потоки розшифровуються ще до того, як їх побачить інтерпретатор
Одне вужче обмеження варто назвати прямо: ланцюжок декодування читає потоки CMap і вмісту через шлях Flate у HotPDF, тож шрифт, чий потік ToUnicode користується незвичним фільтром, деградує до наступної стратегії, а не валить сторінку. На практиці FlateDecode покриває майже все, що вироблялося за останні два десятиліття, і ця деградація мовчазна за задумом — ви отримуєте найкращий текст, який дозволяє файл, а не виняток. Та сама читацька машинерія об'єктів, що розв'язує тут словники шрифтів, живить і редагування метаданих у завантажених документах, тож конвеєр приймання документів може вилучати, оглядати й анотувати за один прохід
Вилучення тексту, відтворення зі збереженням компонування, доступ на рівні гліфів і побудовані на них пошук та заміна є частиною стандартного HotPDF Delphi Component для Delphi та C++Builder — жодних зовнішніх DLL, жодних текстових служб ОС, лише Object Pascal, який ви можете пройти покроково, коли у вашій черзі опиниться дивний файл