У вас є PDF на диску, клієнт відсканував його зі стосу рахунків, а ваше завдання - витягнути зображення сторінок назад як растри для проходу OCR. Ви завантажуєте файл, знаходите зображення-XObject, а потім виявляєте ту частину, про яку ніхто не попереджає: байти в тих потоках не є пікселями. Це кодовий потік JPEG, або стиснута вейвлетами купа JPEG 2000, або серія факсу Group 4, або індексований растр за палітрою за фільтром Flate. Об'єкт зображення знає свою ширину й висоту, але справжні відліки запечатані всередині того фільтра, який обрав виробник файлу. Отримати придатний TBitmap означає скасувати цей фільтр, а PDF дає вам приблизно вісім різних способів, якими байти можуть бути запечатані
Саме цю прогалину закриває ExtractLoadedImage у HotPDF, нативному VCL-компоненті PDF для Delphi та C++Builder. Він перелічує зображення-XObject у завантаженому вами документі, повідомляє, чим є кожне з них, і декодує ті, які може, назад у 24-бітний растр. Цікавою тут є не поверхня API, яка складається з трьох методів. Цікаво, чому окремий шлях декодування взагалі має існувати і що він може, а чого не може перетворити назад на пікселі
Чому завантажені зображення ще не декодовані
Завантажувач HotPDF побудовано навколо точності наскрізного перенесення. Коли ви викликаєте LoadFromFile, потоки зображень зберігаються рівно такими, якими вони з'являються у вихідному файлі: початковий фільтр, початкові стиснуті байти, початковий словник. Це зроблено навмисно. Сенс завантаження документа зазвичай полягає в тому, щоб копіювати сторінки, зливати файли, штампувати їх, змінювати дозволи й записувати назад, а для всього цього найдешевше й найбезпечніше - лишити кожен потік зображення недоторканим. Декодування кожного зображення в растр під час завантаження спалювало б пам'ять і процесор на роботі, яка більшості викликів не потрібна, а перекодування під час збереження псувало б зображення, які мали б бути скопійовані буквально
Наслідок у тому, що завантажений граф об'єктів не несе пікселів. Зображення-XObject, чий /Filter дорівнює /DCTDecode, містить байти JPEG; HotPDF ніколи не проганяв по ньому декодер JPEG, бо шляху копіювання та перезапису це не було потрібно. Тож коли вам справді потрібні пікселі, API вилучення має виконати декодування самостійно, з нуля, для того фільтра, яким саме користується це конкретне зображення. З цієї ж причини кодеки на боці кодування незалежні від завантажувача: стаття про додавання зображень JPEG 2000 у PDF на Delphi описує, як рушій JPX під'єднується до боку створення, і цей рушій просто не був підключений до шляху читання, доки він не знадобився API вилучення
API із трьох методів
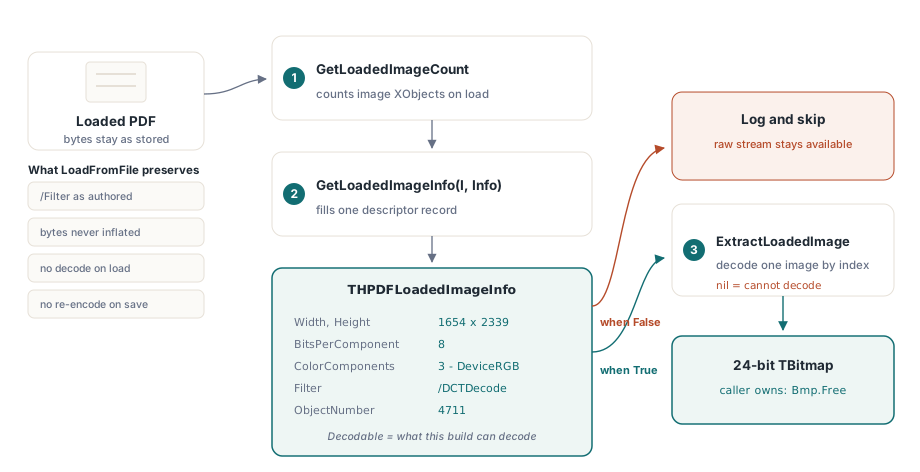
Поверхня невелика. GetLoadedImageCount повертає, скільки зображень-XObject містить завантажений документ. GetLoadedImageInfo заповнює запис-дескриптор для одного з них за індексом. ExtractLoadedImage повертає декодований растр або nil, коли декодувати це зображення не вдається. Перелічення базується на індексах і є стабільним для одного завантаження: усередині воно обходить таблицю непрямих об'єктів і збирає кожен потік, чий /Subtype розв'язується в /Image, тож індекс, який ви передаєте в GetLoadedImageInfo, є тим самим індексом, який ви передаєте в ExtractLoadedImage
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // фільтр або колірний простір не підтримується
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // растр належить викликачеві
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Тут важать дві деталі контракту. По-перше, повернутий TBitmap звільняєте ви; документ його не кешує й ним не володіє. По-друге, перевіряйте Decodable до виклику й перевіряйте результат на nil після. Метод не піднімає винятку на непідтримуваному фільтрі, він повертає nil, а мовчазний nil у пакетному циклі є саме тим, що проковтне сторінку в завданні на тисячу сторінок так, що ніхто й не помітить
Читання дескриптора перед декодуванням
THPDFLoadedImageInfo розповідає вам, чим є зображення, не зобов'язуючи до повного декодування. Його поля йдуть просто зі словника зображення: Width та Height у відліках, BitsPerComponent, ColorComponents і ColorSpace, що описують інтерпретацію після декодування (1 для сірого, 3 для RGB, 4 для CMYK), Filter як назване стиснення, IsImageMask для трафаретних масок, ObjectNumber для базового непрямого об'єкта та Decodable
Останній прапорець є найчеснішим. Decodable дорівнює True лише тоді, коли поточна збірка справді може перетворити саме цю комбінацію фільтра й колірного простору на растр. Він кодує реальну матрицю підтримки, а не побажання: зображення, чий Filter поточна збірка не розуміє, повідомляє Decodable = False, і ви можете розгалужуватися на цьому, щоб залогувати, пропустити або відступити до самостійного вилучення сирого потоку. Ставтеся до нього як до передумови, а не як до підказки
// Сортуйте кожне зображення, перш ніж братися за декодування.
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf завантажено ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) поверне TBitmap
    else
      // непідтримуваний фільтр чи колірний простір: залогуйте об'єкт і пропустіть
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
Одна деталь реалізації кусає тих, хто будує записи-дескриптори вручну. THPDFLoadedImageInfo тримає два поля AnsiString, Filter та ColorSpace. Це керовані типи з підрахунком посилань, тож рефлекс занулити запис через FillChar(Info, SizeOf(Info), 0) тут хибний: він перезаписує посилання на рядок, не зменшивши лічильник, що спричиняє витік або пошкодження. HotPDF ініціалізує запис поле за полем саме з цієї причини, і якщо ви коли-небудь копіюватимете цей патерн у власному коді, робіть так само
Один диспетчер, вісім шляхів фільтрів
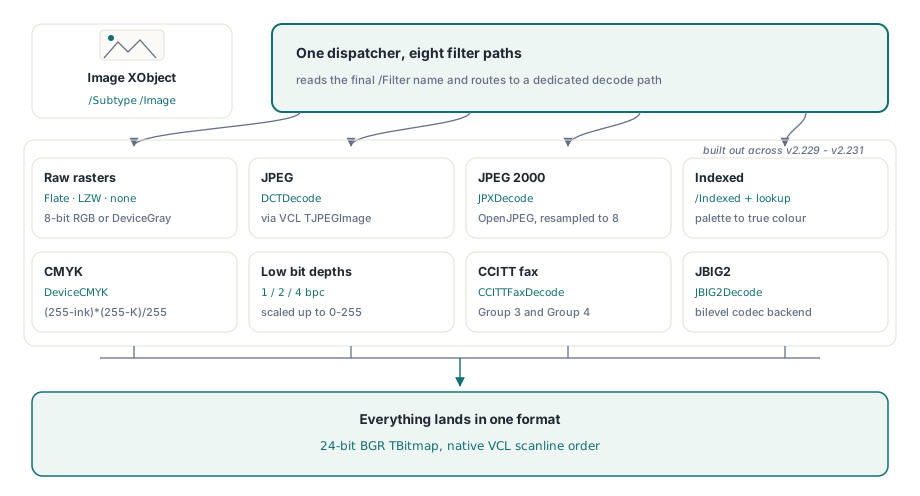
Причина, чому ця можливість зайняла серію релізів, а не один, у тому, що PDF не має формату зображень. Він має фільтри, і §8.9.5 ISO 32000-1 дозволяє зображенню-XObject назвати будь-який із них у /Filter, тоді як інтерпретація відліків керується окремо через /ColorSpace, /BitsPerComponent і необов'язковий масив /Decode. ExtractLoadedImage читає ім'я фільтра й скеровує до окремого декодера для кожного випадку. Підтримуваний набір, нарощений від v2.229 до v2.231, тепер покриває вісім різних шляхів
- Сирі растри (FlateDecode, LZWDecode або без фільтра) у 8-бітних DeviceRGB чи DeviceGray. Байти розтискаються в упакований растр, і єдиним перетворенням є обмін каналів, розглянутий нижче
- DCTDecode (JPEG). Кодовий потік передається до
TJPEGImageз VCL, який розв'язує геометрію й колір, а результат присвоюється у 24-бітний растр - JPXDecode (JPEG 2000). Декодується через бекенд OpenJPEG, той самий рушій, описаний у статті про JPEG 2000, із передискретизацією компонентів високої розрядності вниз до 8 біт
- Індексований колір. Палітра читається з масиву
[/Indexed base hival lookup], і кожен відлік розгортається через таблицю пошуку в повний колір - DeviceCMYK. Чотириканальні відліки перетворюються на RGB стандартною формулою "фарба на білому"
- DeviceGray та Indexed нижче 8 біт на 1, 2 чи 4 бітах на компонент, розпаковані відлік за відліком і масштабовані в діапазон 0–255
- CCITTFaxDecode, факсові фільтри Group 3 та Group 4, декодовані окремим бекендом T.4/T.6
- JBIG2Decode, високоефективний двоколірний фільтр, декодований через зареєстрований бекенд JBIG2, який стаття про нативне стиснення JBIG2 розглядає з боку кодування
Усе приземляється в тому самому місці: у 24-бітному растрі BGR, бо саме це нативно зберігає TBitmap з VCL і саме цього очікує кожен споживач нижче за течією
Перетворення, які тихцем змінюють пікселі
Два з цих шляхів містять перетворення, у якому легко помилитися непомітно, і варте розуміння, навіть якщо ви ніколи не торкатиметеся декодера самі. Перше - це обмін порядку кольорів. Растр DeviceRGB у PDF зберігає відліки в порядку червоний-зелений-синій, спершу верхній рядок. 24-бітний рядок сканування VCL зберігає їх у порядку синій-зелений-червоний. Тож декодування звичайного зображення RGB не є memcpy; перший і третій байти кожного пікселя обмінюються дорогою в рядок сканування. Зробіть це навпаки - і ваші червоні та сині поміняються місцями, що виглядає нормально на сірому тестовому зображенні й катастрофічно неправильно на кольоровому. Порядок рядків, до слова, відображається напряму: низхідні растри PDF лягають на ScanLine[0] у VCL як верхній видимий рядок, тож вертикальне перевертання не потрібне
Друге - це CMYK. Зображення DeviceCMYK у PDF несуть чотири фарби, а перетворення на RGB є обчисленням на кожен канал, а не пошуком: кожен вихідний канал дорівнює (255 - ink) * (255 - K) / 255. Це апаратне наближення, а не керована кольором конверсія через профіль ICC, тож результат достатньо правильний для показу та повторної растеризації, але це хибний шлях, якщо вам потрібен точний колір для друку. Якщо ваш робочий процес вимагає точності, ставтеся до вилученого растра як до попереднього перегляду й зберігайте початковий потік CMYK для конвеєра з керуванням кольором
Індексований шлях ховає власну пастку розбору. Палітра в колірному просторі /Indexed може зберігатися як літеральний рядок або як шістнадцятковий рядок, а HotPDF зберігає значення шістнадцяткового рядка як шістнадцятковий текст, а не як декодовані байти. Тож коли палітра є шістнадцятковим рядком, таблицю пошуку спершу треба прогнати через декодування з hex у байти; літеральний рядок уже є сирими байтами. Пропустите цю гілку - і чотириколірне індексоване зображення вийде сміттям, бо кожен елемент палітри читається з хибної байтової межі
Ланцюжки фільтрів: останній фільтр належить самому зображенню
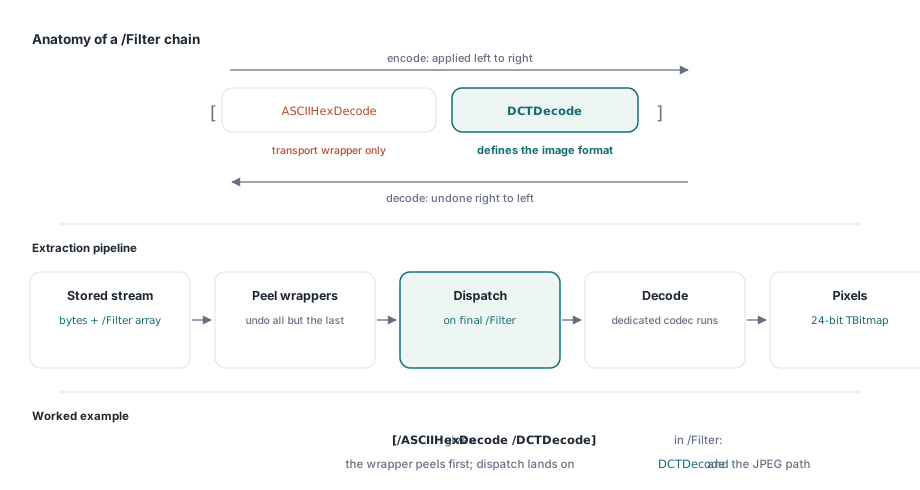
Єдина назва в /Filter є легким випадком. PDF також дозволяє ланцюжок фільтрів, коли потік пропущено крізь кілька з них послідовно, перелічених по порядку в масиві /Filter, як-от [/ASCII85Decode /FlateDecode] чи [/ASCIIHexDecode /DCTDecode] (ISO 32000-1 §7.4). Семантика тут точна: під час кодування фільтри застосовуються зліва направо, тож під час декодування ви скасовуєте їх справа наліво, і саме останній фільтр у масиві є тим, що фактично визначає формат зображення. Провідні фільтри є лише транспортними кодуваннями, обгорнутими навколо нього
Вилучувач розв'язує це лущенням. Перш ніж запуститься будь-який декодер зображень, кожен фільтр ланцюжка, крім останнього, застосовується, щоб отримати вхід, якого очікує фінальний фільтр, і лише тоді відбувається диспетчеризація за цим останнім фільтром. Тож [/ASCII85Decode /DCTDecode] спершу знімає з потоку ASCII85, а потім скеровує результат на шлях JPEG; [/FlateDecode], обгорнутий навколо сирого растра, розтискає його й далі проганяє шляхом растра. Саме це дозволяє вісьмом декодерам лишатися простими. Жодному з них не треба знати про ASCII85 чи шістнадцяткові транспортні обгортки, бо на той момент, коли декодер бачить байти, обгорток уже немає. Це також означає, що ланцюжок, чий фінальний фільтр не підтримується, усе одно падає чисто на кроці диспетчеризації, а не десь посередині
Де вилучення зупиняється і що робити тоді
Будьте чесні із собою щодо меж. Зображення, чий фінальний фільтр лежить поза підтримуваним набором, повертає nil, як і те, чий колірний простір збірка не може інтерпретувати. М'які маски й альфа не відновлюються в растрі; ви отримуєте базове зображення, а не скомпонований результат. Розрядності понад 8 із JPEG 2000 передискретизуються вниз, і це навмисно втратна дія та хибний хід, якщо ви переархівовуєте, а не показуєте. А маска зображення, однобітний трафарет без власного кольору, описується дескриптором, але є іншою річчю, ніж образотворче зображення; декодуйте її, чекаючи на фотографію, і ви будете здивовані
Коли вилучення не досить, сирий потік усе ще лежить у завантаженому графі об'єктів разом із фільтром, і ви можете витягти його байт за байтом і передати власному спеціалізованому кодеку. Саме це запасне поле навмисно зберігає наскрізний дизайн: початкові байти ніколи не викидаються, тож найгірший випадок полягає в тому, що ви декодуєте їх самі, а не в тому, що даних більше немає. Утім, для більшості справжніх завдань підтримувані вісім фільтрів покривають те, що насправді видають сканери, офісні пакети та рушії звітів, а цикл по GetLoadedImageCount з охороною за Decodable перетворює завантажений PDF назад на теку з растрами за кілька рядків
API вилучення завантажених зображень разом із повним набором описаних тут фільтрів декодування постачається у складі HotPDF Delphi Component для Delphi та C++Builder