บทความคู่หูของเราเรื่องการเรียงลำดับหน้า PDFได้อธิบายกฎพื้นฐานไว้แล้ว: ลำดับการแสดงผลมาจากการเดินแบบ depth-first จากซ้ายไปขวาในอาร์เรย์ /Kids ของโครงสร้างต้นไม้ /Pages ไม่ได้มาจากหมายเลขวัตถุแต่อย่างใด บทความนี้จะมองต้นไม้จากมุมที่ต่างออกไป — รูปทรงของมัน เหตุใดโปรแกรมเขียน PDF ที่เป็นผู้ใหญ่จึงสร้างลำดับชั้นของโหนดระดับกลาง ทั้งที่อาร์เรย์แบบแบนราบเพียงชุดเดียวก็ถูกต้องตามข้อกำหนดอยู่แล้ว เกิดอะไรขึ้นจริง ๆ เมื่อเครื่องมือทำให้ต้นไม้แบนลงหรือสร้างขึ้นใหม่ และจะเป็นอย่างไรเมื่อการทำบัญชี /Count ที่ทำให้โครงสร้างทั้งหมดทำงานได้เร็วนั้นหยุดบอกความจริง
การกระจายกิ่ง (Fan-Out) คือการตัดสินใจด้านประสิทธิภาพ
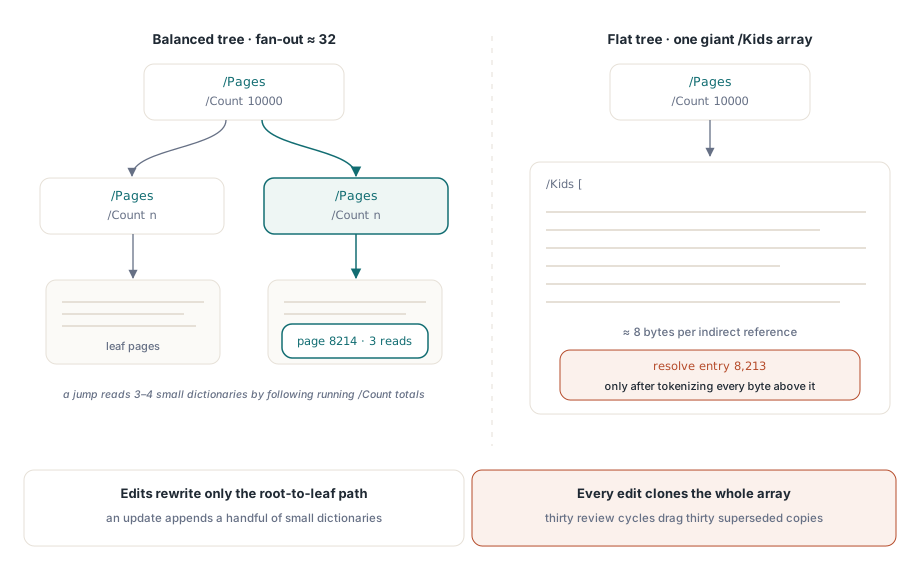
ไม่มีสิ่งใดบังคับให้โปรแกรมเขียนต้องซ้อนโครงสร้าง เอกสาร 10,000 หน้าที่มีโหนดราก /Pages เพียงโหนดเดียวและมีการอ้างอิงใบหน้า 10,000 รายการอยู่ในอาร์เรย์ /Kids เดียวก็ยังถูกต้องตามข้อกำหนด ถึงกระนั้น PDF Reference ก็แนะนำให้ใช้ต้นไม้แบบสมดุลสำหรับเอกสารขนาดใหญ่ และโปรแกรมสร้างไฟล์กระแสหลักก็ทำตามคำแนะนำนั้นด้วยการกระจายกิ่งแบบพอประมาณ โดยทั่วไปคือลูกไม่กี่สิบรายการต่อโหนดระดับกลางหนึ่งโหนด
เหตุผลอยู่ที่สิ่งที่โปรแกรมอ่านต้องอ่านก่อนที่จะแสดงผลอะไรได้เลย ลองพิจารณาการกระโดดตรงไปยังหน้า 8,214 ของไฟล์ 10,000 หน้านั้น ด้วยต้นไม้แบบแบนราบ โปรแกรมอ่านต้องแยกวิเคราะห์โหนดรากก่อน และโหนดรากนั้นคืออาร์เรย์ขนาดมหึมาชุดเดียว: ที่ประมาณแปดไบต์ต่อการอ้างอิงทางอ้อมหนึ่งรายการ นั่นคือวัตถุขนาด 80 KB ที่ต้องถูกแยกโทเคนตั้งแต่ต้นจนจบก่อนที่รายการที่ 8,213 จะถูกไขความหมายได้ ด้วยต้นไม้แบบสมดุลที่มีการกระจายกิ่งเท่ากับ 32 การกระโดดแบบเดียวกันนี้เพียงอ่านราก เทียบผลรวม /Count สะสมเพื่อเลือกลูกที่ถูกต้อง แล้วจึงเดินลงไป — รวมแล้วเป็นพจนานุกรมเล็ก ๆ สามหรือสี่ชุด แต่ละชุดมีขนาดเพียงไม่กี่ร้อยไบต์ นี่คือการเข้าถึงแบบสุ่มระดับ O(log n) ที่ต้นไม้ถูกออกแบบมาให้รองรับ และนี่คือเหตุผลทั้งหมดที่ /Count มีอยู่บนโหนดระดับกลาง: มันช่วยให้โปรแกรมอ่านข้ามทรีย่อยทั้งชุดได้โดยไม่ต้องเปิดวัตถุแม้แต่ชิ้นเดียวภายในนั้น
รูปทรงของต้นไม้ยังกำหนดต้นทุนของการแก้ไขด้วย การอัปเดตแบบเพิ่มส่วนที่แทรกหน้าใหม่หนึ่งหน้าจะต้องเขียนทุกโหนดที่ /Kids หรือ /Count เปลี่ยนแปลงใหม่ นั่นคือเส้นทางจากโหนดแม่ของใบใหม่ขึ้นไปจนถึงราก ในต้นไม้แบบสมดุล เส้นทางนั้นคือพจนานุกรมเล็ก ๆ ไม่กี่ชุดที่ถูกต่อท้ายไฟล์ ในต้นไม้แบบแบนราบ "เส้นทาง" นั้นคืออาร์เรย์รากขนาดยักษ์เดียว ซึ่งถูกทำสำเนาเต็มรูปแบบในทุกครั้งที่แก้ไข สัญญาที่ผ่านรอบการตรวจทานและใส่คำอธิบายประกอบสามสิบรอบอาจลงเอยด้วยการแบกสำเนาที่ถูกแทนที่แล้วของอาร์เรย์ 80 KB เดิมถึงสามสิบชุดไว้ในสตรีมไบต์ของมัน
โหนดภายในบรรทุกคุณสมบัติที่สืบทอดได้
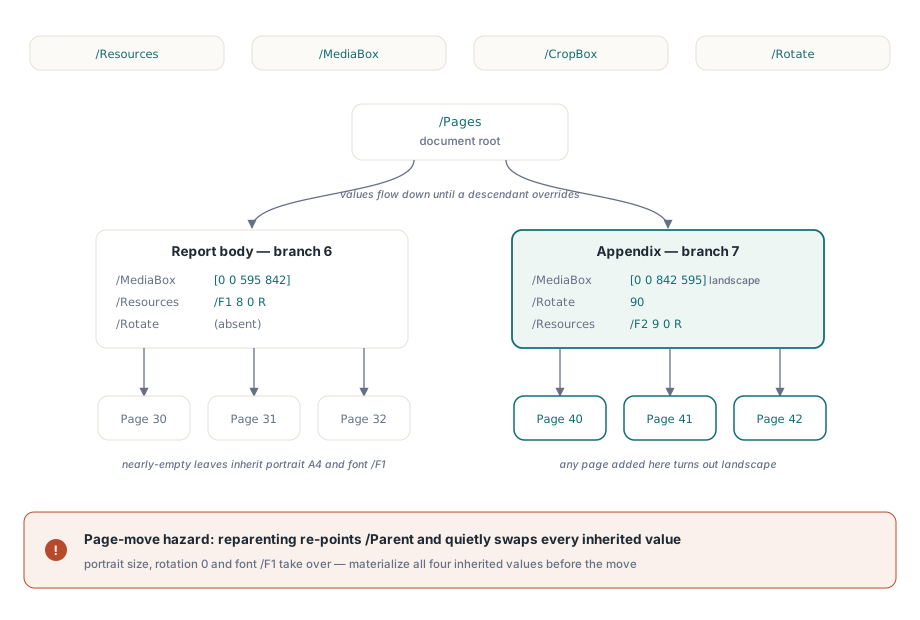
โหนดระดับกลางไม่ได้ทำหน้าที่แค่จัดเส้นทางเท่านั้น คุณสมบัติหน้าที่สืบทอดได้ทั้งสี่รายการ — /Resources, /MediaBox, /CropBox และ /Rotate — สามารถถูกยกขึ้นไปไว้บนโหนด /Pages ใดก็ได้ ซึ่งจะมีผลกับทุกใบที่อยู่ใต้มันเว้นแต่ลูกหลานจะลบล้างค่านั้น โปรแกรมเขียนที่สร้างรายงานที่มีภาคผนวกแนวนอนสามารถแสดงเลย์เอาต์นั้นไว้ในต้นไม้ได้เลย:
5 0 obj   % รากเอกสาร
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % เนื้อหารายงาน: A4 แนวตั้ง ฟอนต์เนื้อหา
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % ภาคผนวก: A4 แนวนอน หมุนแล้ว มีฟอนต์ของตัวเอง
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % หน้าในภาคผนวก: สืบทอดขนาด การหมุน และฟอนต์
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
วัตถุ 40 ถึง 42 แทบจะว่างเปล่า ขนาดหน้า การหมุน และทรัพยากรฟอนต์ของมันทั้งหมดมาจากการสืบทอดจากโหนด 7 ซึ่งทำให้ไฟล์กะทัดรัดและดูแลตัวเองได้: เพิ่มหน้าที่สี่ไว้ใต้โหนดภาคผนวกแล้วมันจะออกมาเป็นแนวนอนโดยอัตโนมัติ
กลไกเดียวกันนี้ก่อให้เกิดอันตรายคลาสสิกจากการย้ายหน้า สมมติว่าเครื่องมือหนึ่งย้ายวัตถุ 40 เข้าไปในเนื้อหารายงานโดยแก้ไขอาร์เรย์ /Kids ทั้งสองชุดและเปลี่ยน /Parent ให้ชี้ไปยังโหนด 6 การย้ายนี้ถูกต้องในเชิงโครงสร้าง แต่วัตถุ 40 กลับสืบทอด /MediaBox แบบแนวตั้ง ไม่มีการหมุน และฟอนต์ /F1 — ในขณะที่สตรีมเนื้อหาของมันยังคงเลือกใช้ /F2 ซึ่งไม่สามารถไขความหมายได้อีกต่อไป หน้าจึงหดตัวลง คลายการหมุน และสูญเสียข้อความไปในการแก้ไขเพียงครั้งเดียว ดังนั้นโค้ดจัดเรียงลำดับใหม่ที่แข็งแรงจึงต้องฝังค่าที่ไขความหมายแล้วของคุณสมบัติที่สืบทอดได้ทั้งสี่รายการลงบนพจนานุกรมหน้าก่อนที่จะเปลี่ยนโหนดแม่ หากคุณเคยลากหน้าในโปรแกรมแก้ไขแล้วเห็นมันเปลี่ยนขนาดหรือทิศทาง นี่คือกลไกที่คุณได้เห็น
การทำให้แบนลง: ถูกต้องตามกฎ พบได้ทั่วไป และบางครั้งก็มีต้นทุนสูง
เครื่องมือจำนวนมากเลือกทำในทางตรงกันข้าม โปรแกรมเขียนแบบมินิมอลสร้างต้นไม้ระดับเดียวเพราะมันง่าย และยูทิลิตี้รวม/แยกไฟล์จำนวนมากสร้างต้นไม้ที่มันอ่านเข้ามาขึ้นใหม่ให้เป็นอาร์เรย์ /Kids แบบแบนราบเดียว เพราะการสร้างโครงสร้างแบบสมดุลเป็นงานเพิ่มเติม และผลลัพธ์แบบแบนราบก็ถูกต้องตามข้อกำหนดเสมอ การสร้างใหม่ที่ถูกต้องต้องไขความหมายการสืบทอดไปพร้อมกันด้วย: ทุกคุณสมบัติที่ใบเคยสืบทอดมาต้องถูกคัดลอกลงไปบนใบนั้น หรือถูกยกขึ้นไปไว้บนรากใหม่หากมันเหมือนกันทั่วทั้งเอกสาร — มิฉะนั้นผลลัพธ์จะเปลี่ยนรูปทรงเรขาคณิตในแบบเดียวกับกรณีการย้ายหน้าเป๊ะ ๆ
สำหรับเอกสารทั่วไปแล้ว การทำให้แบนลงไม่เป็นอันตรายแต่อย่างใด มันจะสร้างความเสียหายเมื่อขยายขนาด ในสองลักษณะที่กล่าวไปแล้ว: อาร์เรย์รากกลายเป็นวัตถุขนาดใหญ่ชิ้นเดียวที่ทุกการเปิดไฟล์และทุกการกระโดดหน้าต้องแยกวิเคราะห์ทั้งหมด และทุกการแก้ไขโครงสร้างจะเขียนมันใหม่ทั้งชุด สิ่งที่การทำให้แบนลงไม่ได้ทำลายคือการใช้ร่วมกันผ่านการอ้างอิงทางอ้อม — ต้นไม้แบบแบนราบที่หน้าทั้ง 10,000 หน้าชี้ไปยังวัตถุพจนานุกรม /Resources เดียวกันก็ยังคงถูกขจัดความซ้ำซ้อนอยู่ สิ่งที่สูญเสียไปมีเพียงทางเลือกที่จะละรายการนั้นไว้จากหน้าแล้วให้บรรพบุรุษเป็นผู้จัดหาให้เท่านั้น
เมื่อ /Count โกหก
/Count เป็นเพียงการทำบัญชีล้วน ๆ: มันต้องเท่ากับจำนวนหน้าใบในทรีย่อยของโหนดนั้น และไม่มีสิ่งใดในรูปแบบไฟล์บังคับให้เป็นเช่นนั้น รูปแบบความเสียหายสองแบบคือสาเหตุส่วนใหญ่ของค่าที่โกหกซึ่งพบได้ในโลกจริง
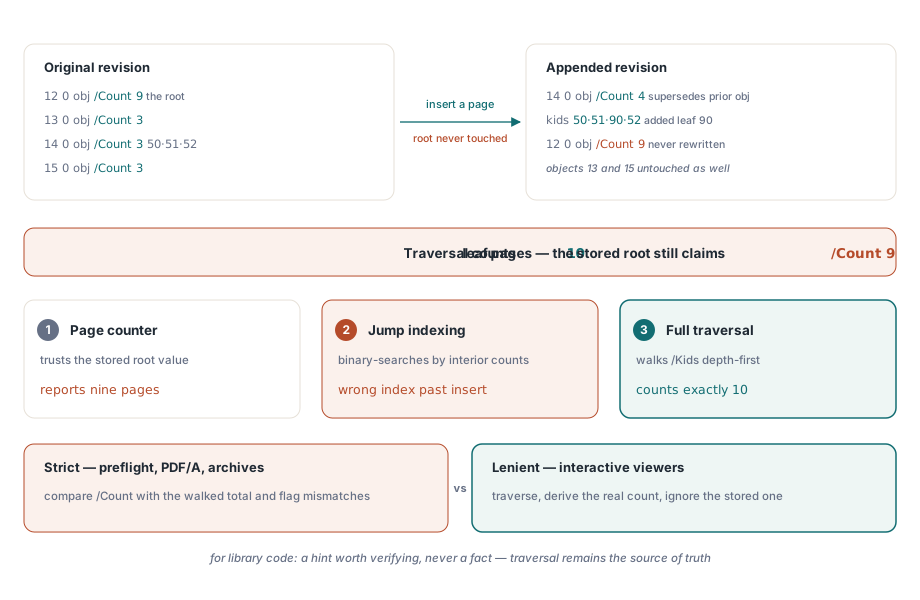
แบบแรกคือค่าที่ล้าสมัยซึ่งตกค้างจากการอัปเดตแบบเพิ่มส่วน โปรแกรมแก้ไขแทรกหน้าหนึ่งหน้า เขียนโหนดแม่ที่อยู่ติดกันใหม่ด้วย /Kids ชุดใหม่และ /Count ที่อัปเดตแล้ว แล้วต่อท้ายทั้งสองอย่างลงในไฟล์ — แต่ไม่เคยแตะต้องบรรพบุรุษเลย:
% รุ่นดั้งเดิม
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% รุ่นที่ต่อท้าย: มีการแทรกหน้าหนึ่งหน้าเข้าไปในกิ่งกลาง
% วัตถุ 14 ถูกแทนที่แล้ว ส่วนวัตถุ 12 ไม่เคยถูกเขียนใหม่เลย
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
ตอนนี้ต้นไม้มีสิบใบแล้ว แต่รากยังคงบอกว่าเก้า โปรแกรมอ่านที่เชื่อรากจะรายงานเก้าหน้าในตัวนับหน้าของมัน ส่วนโปรแกรมที่ใช้ค่านับภายในเพื่อทำ binary search สำหรับการกระโดดหน้าจะคำนวณดัชนีผิดสำหรับทุกหน้าหลังจุดที่แทรก การเดินสำรวจแบบเต็มรูปแบบจะพบว่ามีสิบหน้า สามคำตอบที่ต่างกัน ไฟล์เดียวกัน
รูปแบบที่สองคือค่านับที่ไม่มีทางถูกต้องได้เลย: เป็นค่าลบ เป็นศูนย์บนโหนดที่มีข้อมูลอยู่ หรือมีค่ามหาศาลอย่างไร้เหตุผล ค่าเหล่านี้มาจากการทำ fuzzing ความเสียหายระหว่างการส่งข้อมูล และบางครั้งก็มาจากบั๊กด้านคำนวณเลขในโปรแกรมแก้ไข มันเป็นอันตรายโดยเฉพาะกับโค้ดที่เชื่อ /Count เพื่อใช้จัดสรรหน่วยความจำ — การกำหนดขนาดอาร์เรย์จากค่า /Count ที่เป็น -3 อย่างดีที่สุดก็จะทำให้เกิด range error และการทำเช่นนั้นจากค่า /Count สองพันล้านก็คือการจัดสรรหน่วยความจำแบบ denial-of-service ค่านี้คือข้อมูลนำเข้าที่ไม่น่าเชื่อถือ เช่นเดียวกับตัวเลขอื่น ๆ ทุกตัวในไฟล์
ตัวแยกวิเคราะห์ (parser) แบ่งออกเป็นสองค่ายในเรื่องนี้ทั้งหมด ผู้ใช้งานแบบเข้มงวด — เครื่องมือ preflight, ตัวตรวจสอบ PDF/A, ไปป์ไลน์การจัดเก็บถาวร — จะเทียบ /Count กับผลของการเดินสำรวจแล้วปฏิเสธหรือตั้งค่าสถานะไฟล์นั้น ส่วนโปรแกรมอ่านแบบโต้ตอบเกือบทั้งหมดจะผ่อนปรน: มันเดินสำรวจ คำนวณค่านับจริง แล้วเพิกเฉยต่อค่าที่เก็บไว้อย่างเงียบ ๆ ซึ่งนี่เองคือเหตุผลที่ไฟล์ที่มีค่านับล้าสมัยสามารถหมุนเวียนอยู่ได้เป็นปี ๆ โดยไม่มีการร้องเรียน จนกว่ามันจะไปเจอกับตัวแยกวิเคราะห์ที่เข้มงวดกว่าในเวิร์กโฟลว์อัตโนมัติบางแห่ง จุดกึ่งกลางเชิงป้องกันสำหรับโค้ดไลบรารีคือการปฏิบัติต่อ /Count เป็นเพียงคำใบ้ — มีประโยชน์สำหรับการจัดสรรล่วงหน้า และสำหรับการข้ามทรีย่อยเมื่อได้รับการยืนยันแล้ว — ในขณะที่ปล่อยให้การเดินสำรวจยังคงเป็นแหล่งความจริงต่อไป
สำหรับอัลกอริทึมการเดินสำรวจเอง กฎการค้นหาการสืบทอด และการเดินจากแค็ตตาล็อกไปยังใบ ให้เริ่มจากบทความอธิบายการเรียงลำดับหน้า ส่วนลักษณะของรูปแบบความล้มเหลวเหล่านี้เมื่อเอกสารของลูกค้าจริงมาถึงโค้ด production ให้อ่านกรณีศึกษาการดีบักลำดับหน้า ซึ่งติดตามเหตุการณ์หน้าสลับลำดับตั้งแต่อาการจนถึงสาเหตุที่แท้จริง
HotPDF Delphi Component จัดการเรื่องทั้งหมดนี้ไว้ภายใน: มันเดินสำรวจต้นไม้ที่ซ้อนกันในทุกความลึก ไขความหมายคุณสมบัติที่สืบทอดเมื่อมีการคัดลอกหรือย้ายหน้า และตรวจสอบ /Count กับจำนวนใบจริงแทนที่จะเชื่อมันเฉย ๆ ดังนั้นดัชนีหน้าใน API ของมันจึงหมายถึงหน้าทางตรรกะเสมอ