หมายเลขวัตถุที่ 1 ไม่ใช่หน้าที่ 1 ข้อเท็จจริงเพียงข้อเดียวนี้เป็นสาเหตุที่ทำให้โค้ดประมวลผล PDF สะดุดมากกว่าแง่มุมอื่นใดของรูปแบบไฟล์นี้ และการทำความเข้าใจสาเหตุนั้นต้องมองข้ามสิ่งที่โปรแกรมอ่านแสดงให้คุณเห็น แล้วเข้าไปดูกราฟวัตถุที่โปรแกรมอ่านอ่านจริง ๆ
ไฟล์ PDF คือชุดของวัตถุทางอ้อม (indirect object) ที่มีหมายเลขกำกับ วัตถุแต่ละชิ้นมีหมายเลขวัตถุและหมายเลขรุ่น และวัตถุอื่น ๆ จะชี้มาที่มันด้วยการอ้างอิงที่เขียนในรูปแบบ N G R: 3 0 R หมายถึงเวอร์ชันปัจจุบันของวัตถุ 3 หน้าต่าง ๆ ก็เป็นหนึ่งในวัตถุเหล่านั้น แต่ลำดับการแสดงผลของมันไม่มีส่วนเกี่ยวข้องใด ๆ กับตำแหน่งที่มันอยู่ในไฟล์หรือหมายเลขที่มันถืออยู่เลย ลำดับการแสดงผลถูกกำหนดทั้งหมดโดยต้นไม้ /Pages ซึ่งเป็นโครงสร้างที่เชื่อมโยงกันโดยมีรากอยู่ที่แค็ตตาล็อกเอกสาร หากคุณละเลยต้นไม้นี้แล้วสแกนวัตถุตามลำดับหมายเลข คุณจะประกอบหน้าต่าง ๆ ผิดลำดับในไฟล์จริงจำนวนมากทีเดียว
ต้นไม้หน้า: สิ่งที่กำหนดลำดับอย่างแท้จริง
PDF ทุกไฟล์เริ่มต้นด้วยแค็ตตาล็อกเอกสาร (ISO 32000-2 §7.7.2) แค็ตตาล็อกมีรายการ /Pages ที่ชี้ไปยังโหนดรากของต้นไม้หน้า โหนดรากนั้นคือพจนานุกรมที่มี /Type /Pages, อาร์เรย์ /Kids ที่เก็บการอ้างอิงทางอ้อม และ /Count ที่ระบุจำนวนหน้าใบรวมที่อยู่ใต้มัน ลำดับการแสดงผลคือการเดินสำรวจแบบ depth-first จากซ้ายไปขวาของต้นไม้นั้น จบเพียงเท่านี้
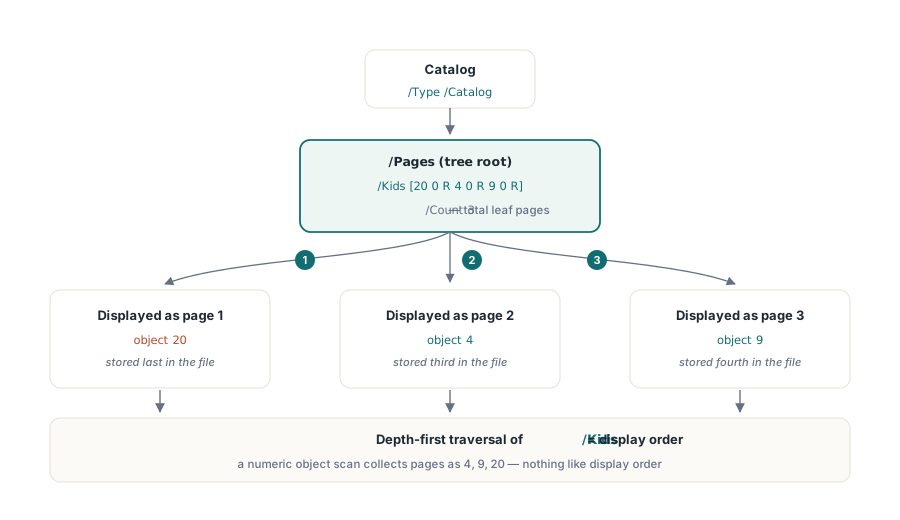
ไฟล์สามหน้าแบบมินิมอลจะทำให้เรื่องนี้เป็นรูปธรรม:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% วัตถุ 4 ถูกเก็บไว้เป็นลำดับที่สามในไฟล์ แต่เป็นหน้าที่ 2 ในลำดับการแสดงผล
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% วัตถุ 9 ถูกเก็บไว้เป็นลำดับที่สี่ แต่เป็นหน้าที่ 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% วัตถุ 20 ถูกเก็บไว้เป็นลำดับสุดท้าย แต่เป็นหน้าที่ 1; Kids[0] เป็นตัวกำหนด ไม่ใช่หมายเลขวัตถุ
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
อาร์เรย์ /Kids อ่านได้ว่า [20 0 R 4 0 R 9 0 R] ดังนั้นวัตถุ 20 คือหน้า 1 วัตถุ 4 คือหน้า 2 และวัตถุ 9 คือหน้า 3 การกำหนดหมายเลขวัตถุไม่มีความสำคัญเลย โค้ดใดก็ตามที่วนซ้ำวัตถุตามลำดับหมายเลขแล้วรวบรวมวัตถุที่มี /Type /Page จะให้ลำดับที่ผิดสำหรับไฟล์นี้
เหตุใดโปรแกรมสร้างไฟล์จึงสร้างเลย์เอาต์ที่ไม่เรียงลำดับ มีหลายสาเหตุ ไลบรารีที่จัดสรรหมายเลขวัตถุล่วงหน้าให้ทุกหน้าก่อนเขียนเนื้อหาจะกำหนดหมายเลขตามลำดับที่สร้าง แล้วจึงเขียนไบต์จริงตามลำดับที่เหมาะกับตัว serializer เครื่องมือรวมไฟล์ที่เย็บเอกสารเข้าด้วยกันจะกำหนดหมายเลขวัตถุใหม่จากแต่ละเอกสารต้นทางเพื่อหลีกเลี่ยงการชนกัน วัตถุหน้าที่ถูกกำหนดหมายเลขใหม่จึงกระจัดกระจายอยู่ทั่วตารางวัตถุที่รวมกัน ในขณะที่อาร์เรย์ /Kids ของรากใหม่ยังคงเก็บลำดับการแสดงผลที่ถูกต้องไว้ การอัปเดตแบบเพิ่มส่วนจะต่อท้ายวัตถุใหม่ไว้ที่ท้ายไฟล์ด้วยหมายเลขใหม่ ดังนั้นหน้าที่ถูกเพิ่มเข้ามาในรุ่นแก้ไขหนึ่งจึงอยู่ใกล้ท้ายสตรีมไบต์ แม้ว่ามันจะอยู่ในตำแหน่งที่ 1 ของลำดับการแสดงผลก็ตาม
ต้นไม้แบบแบนราบและทรีย่อยที่ซ้อนกัน
ข้อกำหนดอนุญาตให้ต้นไม้หน้ามีรูปทรงได้สองแบบ โปรแกรมสร้างไฟล์แบบง่ายจะสร้างโครงสร้างแบบแบนราบ: โหนดราก /Pages เดียวที่อาร์เรย์ /Kids ของมันมีแต่วัตถุใบ /Page เท่านั้น ซึ่งเดินสำรวจได้ง่าย: ลึกเพียงระดับเดียว ผ่านครั้งเดียว
เอกสารขนาดใหญ่มักใช้ต้นไม้แบบสมดุลแทน อาร์เรย์ /Kids ของโหนดราก /Pages จะมีโหนด /Pages ระดับกลางอยู่ภายใน และแต่ละโหนดนั้นก็มีอาร์เรย์ /Kids ของตัวเองอีกที /Count บนแต่ละโหนดระดับกลางจะรายงานจำนวนหน้าใบทั้งหมดในทรีย่อยของมัน ดังนั้นโปรแกรมอ่านจึงสามารถข้ามทรีย่อยทั้งชุดได้เมื่อกระโดดไปยังหน้าตามดัชนีโดยไม่ต้องแยกวิเคราะห์ทุกวัตถุ เอกสาร 1,000 หน้าที่มีโครงสร้างเป็นต้นไม้แบบสมดุลโดยมี 10 หน้าต่อโหนดใบสามารถค้นหาหน้าที่ 750 ได้ด้วย binary search ผ่านการค้นพจนานุกรมเพียงสามหรือสี่ครั้ง แทนที่จะสแกนรายการ /Kids ถึง 750 รายการ
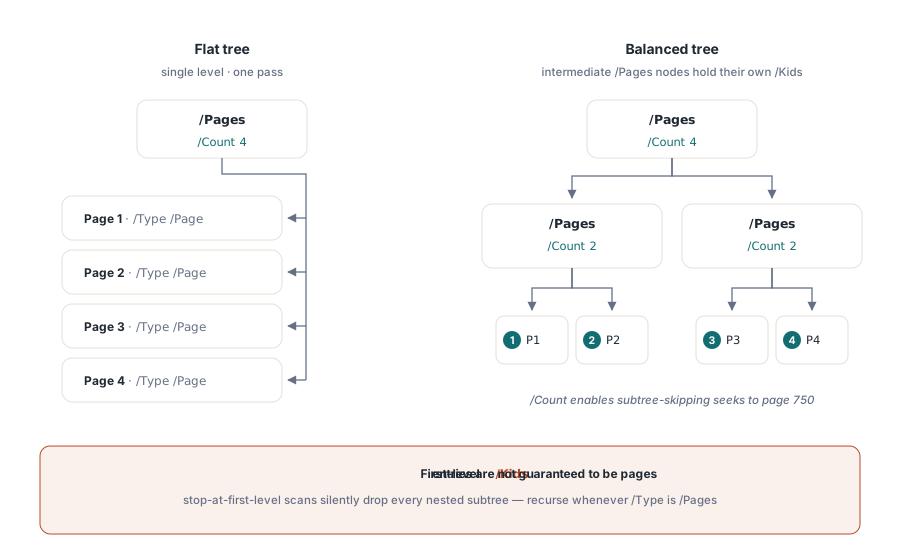
ผลที่ตามมาสำหรับโค้ดประมวลผลคือ: คุณไม่สามารถสันนิษฐานได้ว่าระดับแรกของ /Kids มีแต่วัตถุ /Page ต้องตรวจสอบลูกแต่ละตัว หาก /Type ของมันคือ /Pages ให้เรียกซ้ำเข้าไปในมัน หาก /Type ของมันคือ /Page มันคือใบ การหยุดที่ระดับแรกจะทำให้ทรีย่อยทั้งชุดหายไปอย่างเงียบ ๆ ในเอกสารใดก็ตามที่โปรแกรมสร้างไฟล์เลือกซ้อนโครงสร้าง เหตุผลที่โปรแกรมเขียนเลือกใช้ต้นไม้ที่ลึกตั้งแต่แรก สิ่งที่เครื่องมือทำให้แบนลงต้องสูญเสียไป และวิธีที่ความเสียหายของ /Count ปรากฏออกมาในทางปฏิบัติ ถูกอธิบายไว้ในบทความคู่หูของเราเรื่องรูปทรงต้นไม้หน้า การกระจายกิ่ง และความถูกต้องของ /Count
คุณสมบัติหน้าที่สืบทอดได้
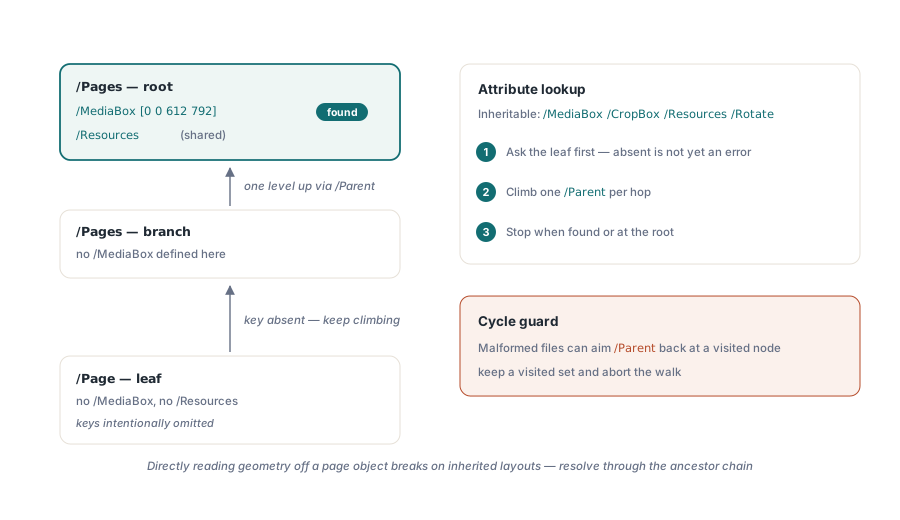
ต้นไม้หน้ายังบรรทุกกลไกการใช้ทรัพยากรร่วมกันด้วย คุณสมบัติหน้าบางอย่าง ได้แก่ /MediaBox, /CropBox, /Resources และ /Rotate สามารถสืบทอดได้ (ISO 32000-2 §7.7.3.4) หากพจนานุกรม /Page ละรายการใดรายการหนึ่งไว้ โปรแกรมอ่านจะเดินขึ้นไปตามสาย /Parent จนกว่าจะพบคุณสมบัตินั้นหรือไปถึงราก การวางพจนานุกรมฟอนต์ที่ใช้ร่วมกันไว้ในโหนดราก /Pages แทนที่จะคัดลอกมันลงไปในทุกหน้าใบสามารถลดขนาดไฟล์ได้อย่างเห็นได้ชัดสำหรับเอกสารที่ใช้แบบอักษรเดียวกันตลอดทั้งเล่ม
กฎการสืบทอดนี้สร้างจุดที่ต้องระวังสำหรับโค้ดที่อ่านคุณสมบัติหน้า การอ่าน /MediaBox โดยตรงจากวัตถุ /Page แล้วถือว่าคีย์ที่ขาดหายไปเป็นข้อผิดพลาดนั้นไม่ถูกต้อง เพราะคีย์นั้นอาจเป็นแค่ค่าที่สืบทอดมาก็ได้ โค้ดที่ไขความหมายรูปทรงเรขาคณิตของหน้าได้อย่างถูกต้องต้องเดินตามสาย parent นอกจากนี้ยังต้องมีตัวป้องกันวงจรซ้ำด้วย: ไฟล์ที่เสียหายอาจมีการอ้างอิง /Parent ที่ชี้กลับไปยังโหนดที่เคยเยี่ยมชมไปแล้ว ซึ่งจะวนลูปไม่รู้จบหากไม่มีการตรวจสอบวัตถุที่เคยเยี่ยมชม
ตาราง xref และสตรีมการอ้างอิงโยง
การค้นหาวัตถุทางอ้อมจะผ่านตารางการอ้างอิงโยง (หรือตัวสืบทอดของมัน คือสตรีมการอ้างอิงโยงที่เริ่มใช้ใน PDF 1.5) xref จะจับคู่หมายเลขวัตถุแต่ละหมายเลขกับออฟเซ็ตไบต์ภายในไฟล์ โปรแกรมอ่านที่เป็นไปตามข้อกำหนดจะใช้ xref เพื่อกระโดดไปยังวัตถุใด ๆ ได้โดยตรง มันจะไม่สแกนไฟล์ตามลำดับ การออกแบบที่เข้าถึงแบบสุ่มนี้เองที่ทำให้การกระโดดหน้าอย่างรวดเร็วเป็นไปได้: โปรแกรมอ่านจะอ่านแค็ตตาล็อก ไขความหมายการอ้างอิง /Pages ผ่าน xref อ่านโหนดราก /Pages ไขความหมายรายการ /Kids และเป็นเช่นนี้ต่อไป โดยแตะต้องเฉพาะวัตถุที่มันต้องการเท่านั้น
การอัปเดตแบบเพิ่มส่วนจะเพิ่มส่วน xref ใหม่ไว้ที่ท้ายไฟล์ พร้อม trailer ที่เชื่อมโยงกลับไปยังส่วนก่อนหน้า วัตถุที่ถูกอัปเดตในรุ่นแก้ไขหนึ่งจะได้รับรายการใหม่ในส่วน xref ที่ต่อท้ายมา ไบต์ดั้งเดิมยังคงอยู่ในตำแหน่งเดิมแต่ถูกแทนที่แล้ว นี่คือวิธีที่ PDF ที่มีลายเซ็นดิจิทัลยังคงตรวจสอบได้แม้หลังจากมีการเพิ่มรุ่นแก้ไขสำหรับคำอธิบายประกอบหรือการกรอกฟอร์ม: ช่วงไบต์ที่ถูกเซ็นชื่อจะไม่ถูกแตะต้องเลย และเนื้อหาใหม่จะอยู่ในส่วนที่ต่อท้าย ต้นไม้หน้าก็สามารถถูกอัปเดตได้เช่นกัน ดังนั้นการเพิ่มหรือลบหน้าในรุ่นแก้ไขหนึ่งจะสร้างราก /Pages ใหม่ที่มีอาร์เรย์ /Kids ที่แก้ไขแล้ว ในขณะที่วัตถุรากเดิมยังคงอยู่ในตำแหน่งเดิมในไฟล์ ไฟล์แบบ Linearized (ปรับให้เหมาะกับเว็บ) เพิ่มลูกเล่นด้านการจัดวางไบต์เข้ามาอีกอย่าง: วัตถุสำหรับหน้า 1 จะถูกย้ายไปไว้ที่ต้นไฟล์ทางกายภาพ เพื่อให้โปรแกรมอ่านสามารถแสดงหน้าแรกได้ในขณะที่ส่วนที่เหลือยังดาวน์โหลดอยู่ แต่ต้นไม้หน้ายังคงเป็นผู้กำหนดลำดับแต่เพียงผู้เดียว — มีเพียงออฟเซ็ตที่บันทึกไว้ใน xref เท่านั้นที่เปลี่ยนไป
จะเกิดอะไรผิดพลาดหากไม่เดินสำรวจต้นไม้
รูปแบบความล้มเหลวของวิธีการสแกนวัตถุนั้นเงียบมาก เอกสารผลลัพธ์ดูสมเหตุสมผล: มันมีจำนวนหน้าถูกต้องและแต่ละหน้าก็มีเนื้อหาที่จำได้ เพียงแต่ลำดับผิดเท่านั้น และผิดในแบบที่ขึ้นอยู่กับโปรแกรมสร้างไฟล์ จำนวนรุ่นแก้ไข และมีการรวมหน้าจากแหล่งภายนอกหรือไม่ ชุดไฟล์ทดสอบที่สร้างจากเครื่องมือเดียวอาจผ่านทั้งหมด แต่ไฟล์จากเครื่องมืออื่นหรือเวิร์กโฟลว์การรวมไฟล์จะล้มเหลว ความไม่สอดคล้องกันนี้เองคือเหตุผลที่การแก้ปัญหาแบบฮิวริสติกไม่เคยใช้ได้ผลถาวร สำหรับตัวอย่างของความล้มเหลวแบบนี้ในเอกสารของลูกค้าจริง — อาการ การวินิจฉัยผิดพลาด และวิธีแก้ด้วยการเดินสำรวจ — ดูได้ที่กรณีศึกษาการดีบักลำดับหน้าของเรา
ไฟล์ที่มีการอัปเดตแบบเพิ่มส่วนมีแนวโน้มเกิดปัญหานี้เป็นพิเศษ เพราะหน้าที่ถูกเพิ่มหรือจัดเรียงใหม่ในรุ่นแก้ไขภายหลังจะมีหมายเลขวัตถุสูง ในขณะที่ลำดับการแสดงผลถูกควบคุมโดยอาร์เรย์ /Kids ที่อัปเดตแล้ว การสแกนที่ประมวลผลวัตถุตามลำดับหมายเลขจะวางหน้าที่มีหมายเลขสูงเหล่านั้นไว้ท้ายสุด ไม่ว่าต้นไม้จะระบุว่าหน้าเหล่านั้นควรอยู่ที่ใดก็ตาม
วิธีแก้ไม่ซับซ้อนเลย เริ่มจากแค็ตตาล็อก ไขความหมายการอ้างอิง /Pages เดินอาร์เรย์ /Kids แบบเรียกซ้ำ แล้วปล่อยใบตามลำดับที่พบ นั่นคือลำดับการแสดงผลตามคำนิยาม ไม่ว่าจะเป็นหมายเลขวัตถุ ออฟเซ็ตไบต์ หรือโครงสร้างไฟล์ก็ตาม ไลบรารี PDF ที่เป็นผู้ใหญ่ส่วนใหญ่จะเปิดให้ใช้จำนวนหน้าและตัวเข้าถึงหน้าแบบมีดัชนีที่ทำสิ่งนี้ได้อย่างถูกต้องอยู่แล้ว ความเสี่ยงอยู่ที่โค้ดที่ข้ามโมเดลหน้าของไลบรารีแล้วแตะต้องเลเยอร์วัตถุโดยตรงต่างหาก
ความผิดปกติเชิงโครงสร้างอย่างหนึ่งที่ควรจัดการอย่างชัดเจน: ค่า /Count บนโหนด /Pages ระดับกลางอาจผิดพลาดได้ในไฟล์ที่ผิดรูปแบบ การเชื่อ /Count สำหรับการตรวจสอบขอบเขตแล้วหยุดก่อนเดินสำรวจให้ครบจะละหน้าไปอย่างเงียบ ๆ เมื่อค่านับต่ำกว่าความเป็นจริง การใช้ /Count เป็นเพียงคำใบ้ด้านประสิทธิภาพสำหรับการจัดสรรความจุล่วงหน้าหรือการทำ binary search แล้วคำนวณค่านับจริงจากการเดินสำรวจคือรูปแบบที่ปลอดภัยกว่าสำหรับเอกสารสำคัญ