หากตัดส่วนคำอธิบายหน้าเว็บออกไป สิ่งที่เหลืออยู่คือชั้นโครงสร้างบางๆ ที่ไม่มีใครสั่งพิมพ์ออกมา แต่โปรแกรมอ่าน โปรแกรมทำดัชนี และระบบจัดเก็บถาวรทุกตัวต้องพึ่งพามัน ออบเจ็กต์หน้าเว็บไม่รับรู้เลยว่าตัวเองอยู่ในบทไหน ใครเป็นคนเขียน หรือมีเชิงอรรถที่ลิงก์ไปที่ใด ความรู้เหล่านี้จะอยู่ในระดับที่สูงขึ้นไปอีกขั้น ภายในโครงสร้างสามส่วนที่แนบมากับ document catalog ได้แก่ สตรีมเมทาดาตา (metadata streams), โครงสร้างต้นไม้เค้าโครง (outline tree) และอาร์เรย์คำอธิบายประกอบในแต่ละหน้า (per-page annotation arrays) ทั้งสามส่วนนี้มีจุดเด่นร่วมกันอย่างหนึ่งที่ทำให้มักจะเกิดข้อผิดพลาดได้ง่าย นั่นคือพวกมันไม่แสดงร่องรอยใดๆ บนหน้าเว็บ ดังนั้นไฟล์จึงสามารถเรนเดอร์ออกมาได้อย่างสมบูรณ์แบบ ทั้งที่บุ๊กมาร์กหายไป ขัดแย้งกับช่องผู้เขียนของตัวมันเอง หรือลิงก์ไปยังออบเจ็กต์หน้าเว็บที่ไม่มีอยู่จริงแล้วก็ตาม
นี่คือชั้นของข้อมูลที่ไลบรารี PDF เผยแพร่ออกมาในรูปแบบของคุณสมบัติเอกสาร (document properties), API สำหรับบุ๊กมาร์ก และการเรียกใช้ลิงก์หรือคำอธิบายประกอบ และยังเป็นชั้นที่โปรแกรมรวบรวมข้อมูลการค้นหา (search crawler) อ่านเพื่อพิจารณาว่าเอกสารของคุณเกี่ยวกับอะไร โมเดลออบเจ็กต์ที่อยู่ข้างใต้นั้นได้อธิบายไว้แล้วใน การเจาะลึกโครงสร้างเอกสาร PDF ส่วนในที่นี้จะเน้นไปที่สิ่งที่พ่วงติดมากับ catalog เป็นหลัก
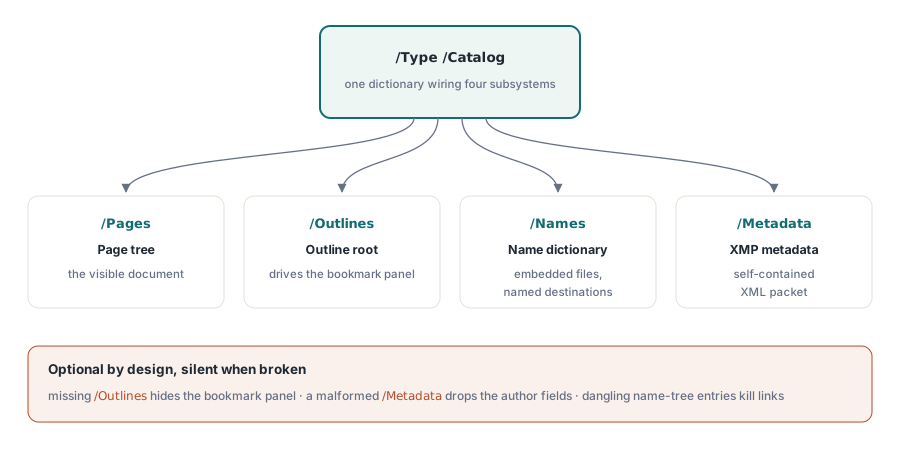
โครงสร้างทั้งสามส่วนเชื่อมต่อกันที่ catalog ซึ่ง catalog ที่สมบูรณ์แบบที่เชื่อมโยงสิ่งเหล่านี้เข้าด้วยกันจะมีลักษณะดังนี้:
1 0 obj
<< /Type /Catalog
   /Pages 2 0 R
   /Outlines 3 0 R
   /Names << /EmbeddedFiles 4 0 R >>
   /Metadata 5 0 R
>>
endobj
รายการสี่รายการ ระบบย่อยที่เป็นอิสระสี่ระบบ /Pages คือเอกสารที่มองเห็นได้; /Outlines คือโครงสร้างต้นไม้ของบุ๊กมาร์ก; /Metadata ชี้ไปที่สตรีม XMP; /Names ไปถึงดิกชันนารีชื่อที่ครอบคลุมทั้งเอกสาร ซึ่งใช้สำหรับเก็บไฟล์แนบที่ฝังไว้ เป็นต้น แต่ละส่วนเป็นทางเลือก (optional) และโปรแกรมอ่านที่ไม่พบส่วนใดๆ เหล่านี้ก็ยังคงแสดงหน้าเว็บได้ ความเป็นทางเลือกนี่เองคือเหตุผลที่ชั้นการนำทาง (navigation layer) มักจะพังเป็นส่วนแรกเมื่อไฟล์ถูกแก้ไขด้วยเครื่องมือที่เข้าใจเฉพาะหน้าเว็บเท่านั้น
ที่เก็บเมทาดาตาสองแห่งที่ไม่ตรงกัน
PDF จัดเก็บเมทาดาตาของเอกสารไว้ในสองที่พร้อมกัน และปัญหาจะเริ่มขึ้นเมื่อทั้งสองที่ให้ข้อมูลไม่ตรงกัน กลไกแบบดั้งเดิมคือ document information dictionary (ดิกชันนารีข้อมูลเอกสาร) ซึ่งอ้างอิงโดย /Info ใน trailer: เป็นชุดของคู่คีย์-ค่าแบบแบนๆ สำหรับ /Title, /Author, /Subject, /Keywords, /Creator, /Producer และวันที่สองค่า มันเรียบง่ายและโปรแกรมดูทุกตัวก็สามารถอ่านได้ แต่ PDF 2.0 ได้ยกเลิกการใช้งานส่วนใหญ่เพื่อเปลี่ยนไปใช้กลไกที่สอง นั่นคือสตรีมเมทาดาตา XMP
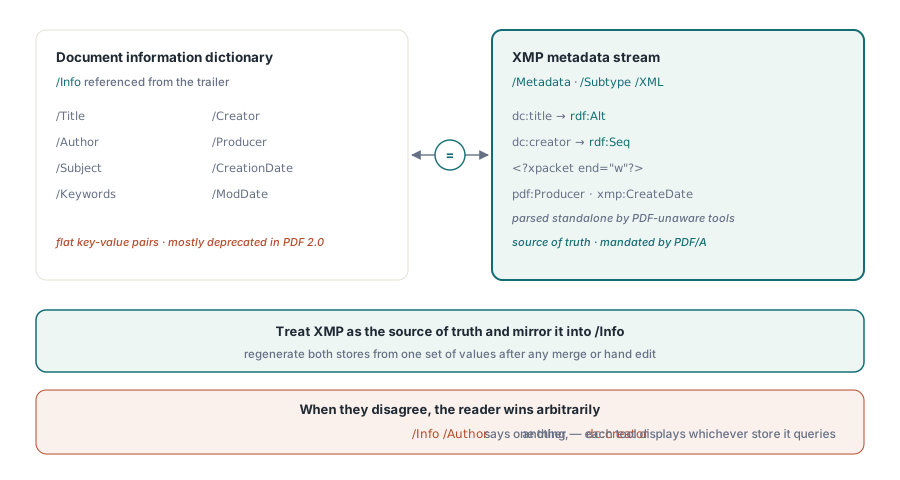
XMP เป็นเอกสาร XML ที่สมบูรณ์ในตัวเอง เขียนด้วย RDF เก็บเป็นสตรีมที่ catalog เข้าถึงผ่าน /Metadata และถูกทำเครื่องหมายเป็น /Type /Metadata /Subtype /XML ต่างจาก Info dictionary ที่ถูกฝังอยู่ภายในโครงสร้างออบเจ็กต์ PDF แพ็กเก็ต XMP ถูกออกแบบมาให้สามารถแยกออกและพาร์สได้ด้วยตัวเองโดยเครื่องมือที่ไม่จำเป็นต้องรู้จัก PDF นี่คือตัวอย่างแพ็กเก็ต:
5 0 obj
<< /Type /Metadata /Subtype /XML /Length 1235 >>
stream
<?xpacket begin="" id="W5M0MpCehiHzreSzNTczkc9d"?>
<x:xmpmeta xmlns:x="adobe:ns:meta/">
  <rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#">
    <rdf:Description rdf:about=""
        xmlns:dc="http://purl.org/dc/elements/1.1/"
        xmlns:xmp="http://ns.adobe.com/xap/1.0/"
        xmlns:pdf="http://ns.adobe.com/pdf/1.3/">
      <dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report</rdf:li></rdf:Alt></dc:title>
      <dc:creator><rdf:Seq><rdf:li>A. Author</rdf:li></rdf:Seq></dc:creator>
      <xmp:CreateDate>2026-06-16T10:46:27+08:00</xmp:CreateDate>
      <xmp:CreatorTool>Reporting Service 4.2</xmp:CreatorTool>
      <pdf:Producer>losLab PDF Library</pdf:Producer>
    </rdf:Description>
  </rdf:RDF>
</x:xmpmeta>
<?xpacket end="w"?>
endstream
endobj
รายละเอียดสามจุดในบล็อกนั้นเป็นตัวกำหนดว่าเมทาดาตาจะอยู่รอดเมื่อเจอเครื่องมือใช้งานจริงหรือไม่ คำสั่งประมวลผล xpacket ไม่ใช่แค่ของตกแต่ง: มันตีกรอบแพ็กเก็ตเพื่อให้โปรแกรมสกัด (extractor) สามารถค้นหามันได้ในสตรีมไบต์ขนาดใหญ่ และโปรแกรมเขียนที่ละเลย <?xpacket end="w"?> ปิดท้ายจะสร้างไฟล์ที่เปิดได้ปกติแต่ไม่ผ่านตัวตรวจสอบ (validators) ที่เข้มงวด ประเภทข้อมูลของคุณสมบัติก็สำคัญเช่นกัน dc:title เป็นภาษาทางเลือกที่ห่อหุ้มด้วย rdf:Alt ในขณะที่ dc:creator เป็นรายการที่มีลำดับและใช้ rdf:Seq; การปล่อยอย่างใดอย่างหนึ่งออกมาเป็นแค่ข้อความ (text node) เพียวๆ คือข้อผิดพลาดเกี่ยวกับ XMP ที่พบบ่อยที่สุด ซึ่งโปรแกรมดูส่วนใหญ่ยอมรับได้ จนกระทั่งเจอกับโปรแกรมที่ไม่ยอมรับ คำนำหน้าเนมสเปซเป็นเพียงธรรมเนียมปฏิบัติ แต่ URI ที่พวกมันผูกติดด้วยเป็นมาตรฐานที่ต้องปฏิบัติตาม: พาร์สเซอร์จะค้นหาจาก URI ไม่ใช่คำนำหน้า
กฎเหล็กของการมีที่เก็บข้อมูลสองแห่งคือพวกมันต้องตรงกัน หาก /Info ระบุว่าผู้เขียนคือคนหนึ่ง และ dc:creator ระบุชื่ออีกคน คุณได้ส่งมอบเอกสารที่ตอบคำถามเดียวกันได้สองแบบ และคำตอบใดจะชนะก็ขึ้นอยู่กับว่าเครื่องมือผู้บริโภคอ่านจากฟิลด์ไหน โดยปกติแล้วไลบรารีจะเขียนให้คุณทั้งสองอย่าง แต่ทันทีที่คุณแก้ไขอันใดอันหนึ่งด้วยตัวเอง หรือรวมไฟล์จากโปรแกรมสร้างที่ต่างกัน ทั้งสองส่วนนี้ก็จะเริ่มคลาดเคลื่อนออกจากกัน ให้ถือว่า Info dictionary เป็นความเข้ากันได้กับระบบเก่า (legacy compatibility) และ XMP เป็นแหล่งข้อมูลความจริง (source of truth) และควรสร้างทั้งคู่ใหม่จากชุดค่าเดียวกันแทนที่จะแก้ไขแยกกัน สำหรับ PDF/A นี่คือข้อกำหนดความสอดคล้อง: ISO 19005 บังคับให้ใช้ XMP และห้ามใช้คุณสมบัติ Info ใดๆ ที่ขัดแย้งกับคู่ขนานของมันใน XMP
โครงสร้างต้นไม้เค้าโครงเบื้องหลังแผงบุ๊กมาร์ก
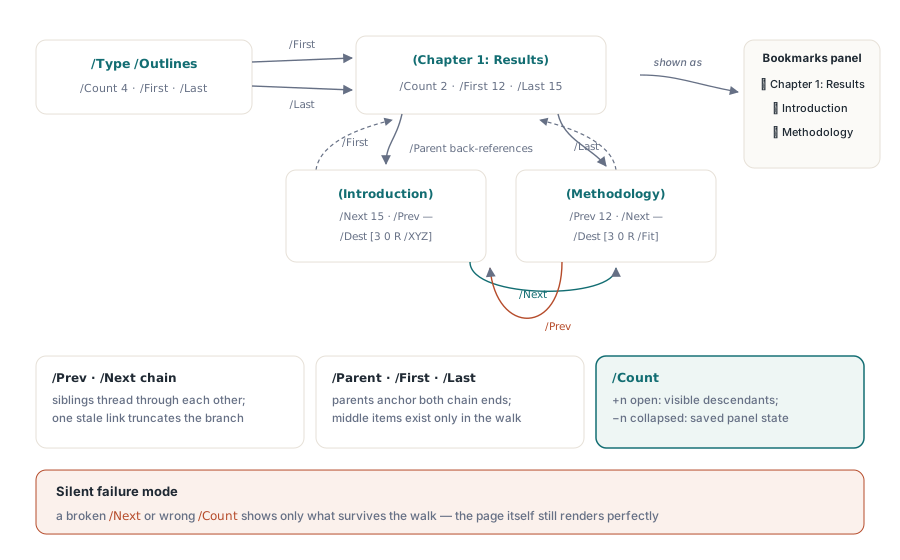
สิ่งที่โปรแกรมดูแสดงเป็นแผงบุ๊กมาร์ก แท้จริงแล้วในไฟล์คือโครงสร้างต้นไม้ของดิกชันนารีที่เชื่อมโยงกันแบบสองทิศทาง (doubly linked tree) ที่เรียกว่า document outline catalog ชี้ไปที่ดิกชันนารีเค้าโครงราก (root outline dictionary) ผ่าน /Outlines; รากชี้ไปที่รายการระดับบนสุดรายการแรกและรายการสุดท้าย; และทุกรายการจะเชื่อมโยงกับเพื่อนบ้านและพาเรนต์ของมัน ไม่เคยมีอาร์เรย์ของบุ๊กมาร์กอยู่ที่ไหนเลย โครงสร้างทั้งหมดถูกสร้างขึ้นใหม่โดยการตามการอ้างอิงไป ซึ่งนั่นคือเหตุผลอย่างชัดเจนว่าทำไมลิงก์ที่เสียเพียงลิงก์เดียวก็สามารถทำให้กิ่งก้านสาขาทั้งหมดหายไปจากแผงควบคุมได้โดยไม่มีข้อผิดพลาดใดๆ
8 0 obj                                    % root ของ outline
<< /Type /Outlines /Count 4 /First 9 0 R /Last 9 0 R >>
endobj
9 0 obj                                    % top-level: a chapter
<< /Title (Chapter 1: Results)
   /Parent 8 0 R /Count 2
   /First 12 0 R /Last 15 0 R >>
endobj
12 0 obj                                   % first child
<< /Title (Introduction)
   /Parent 9 0 R /Next 15 0 R
   /Dest [3 0 R /XYZ 72 720 0] >>
endobj
15 0 obj                                   % second child, last sibling
<< /Title (Methodology)
   /Parent 9 0 R /Prev 12 0 R
   /Dest [3 0 R /Fit] >>
endobj
เพียงแค่อ่านลิงก์ คุณก็จะเห็นความสม่ำเสมอได้อย่างชัดเจน ทุกรายการจะชี้กลับไปยัง /Parent ของมัน พี่น้องสร้างสายโซ่ผ่าน /Prev และ /Next โดยรายการแรกจะละเว้น /Prev และรายการสุดท้ายจะละเว้น /Next พาเรนต์ระบุชื่อลูกคนแรกและคนสุดท้ายผ่าน /First และ /Last และลูกที่อยู่ตรงกลางจะสามารถเข้าถึงได้โดยการเดินตามสายโซ่พี่น้องเท่านั้น หากทำผิดพลาดไปเพียงหนึ่งจุดก็จะเกิดความล้มเหลวแบบเงียบๆ: /Next ที่ไม่ทำงานจะตัดบทนั้นทิ้ง, พาเรนต์ที่มี /Last ไม่สิ้นสุดสายโซ่จะทำให้รายการนั้นกลายเป็นเด็กกำพร้า และโปรแกรมดูก็จะเรนเดอร์เฉพาะสิ่งที่มันสามารถเข้าถึงได้เท่านั้น
ฟิลด์ /Count เก็บข้อมูลสถานะที่ทำให้คนประหลาดใจ ที่รากและรายการที่ถูกขยาย (expanded item) ฟิลด์นี้จะเก็บจำนวนลูกหลานที่มองเห็นได้ในปัจจุบัน; สำหรับรายการที่ถูกพับเก็บ (collapsed item) จะเป็นตัวเลขติดลบซึ่งค่าสัมบูรณ์ของมันคือจำนวนลูกหลานที่จะปรากฏเมื่อถูกขยาย ดังนั้น /Count จึงไม่ใช่ข้อเท็จจริงเชิงโครงสร้างที่คงที่ของต้นไม้ แต่มันคือสถานะการเปิดหรือปิดของแผงควบคุมที่ถูกบันทึกไว้ และโปรแกรมสร้าง (generator) ที่ฮาร์ดโค้ดให้มันเป็นผลรวมเชิงบวก จะเป็นการเปิดทุกสาขาที่ผู้เขียนตั้งใจจะปิดไว้ขึ้นมาใหม่ทั้งหมด
แต่ละรายการมีตำแหน่งของมันได้จากการชี้ไปที่ใดที่หนึ่ง /Title คือสิ่งที่แผงแสดง; /Dest คือจุดที่การคลิกจะไปถึง ปลายทางสามารถอยู่ภายในรายการ (inline) ได้ตามด้านบน หรืออาจเป็นชื่อที่แก้ไขผ่านดิกชันนารีชื่อของเอกสาร ซึ่งเป็นตัวเลือกที่ดีกว่าเมื่อบุ๊กมาร์กและลิงก์จำนวนมากกำหนดเป้าหมายไปที่จุดเดียวกัน เพราะคุณสามารถแก้ไขเป้าหมายที่ถูกย้ายได้ในที่เดียว ไลบรารีทั่วไปมักจะซ่อนโครงสร้างต้นไม้นี้ไว้ด้านหลัง outline-root handle และใช้เมธอดในการเพิ่มรายการลูก; ใน HotPDF เอกสารจะเปิดเผย OutlineRoot ประเภท THPDFDocOutlineObject และจะร้อยเรียงลิงก์ /Prev, /Next, /Parent และ /Count ให้คุณขณะที่คุณผนวกรายการต่างๆ การใช้ประโยชน์จากสิ่งนี้นับว่าคุ้มค่า เพราะการดูแลความสม่ำเสมอเหล่านี้ด้วยมือผ่านการแก้ไข คือจุดที่มักจะทำให้โครงสร้างพังทลาย
ปลายทาง: ไวยากรณ์ของตำแหน่งที่คลิกไป
ทั้งบุ๊กมาร์กและลิงก์คำอธิบายประกอบจะชี้ไปยังปลายทาง (destinations) และปลายทางก็มีมากกว่าแค่หมายเลขหน้า มันคืออาร์เรย์ที่ระบุชื่อออบเจ็กต์หน้าเว็บ และจากนั้นจะระบุว่าโปรแกรมดูควรตีกรอบหน้าเว็บนั้นอย่างไรผ่านคำกริยาในสล็อตที่สอง สิ่งที่พบบ่อยและถูกใช้ผิดๆ มากที่สุดคือ /XYZ ซึ่งอยู่ในรูปแบบ [page /XYZ left top zoom] ตัวถูกดำเนินการทั้งสามเป็นอิสระต่อกัน และตัวใดตัวหนึ่งสามารถเป็น null เพื่อหมายถึง "ปล่อยไว้เหมือนที่ผู้อ่านได้เห็น" ดังนั้น [page /XYZ null null null] จึงข้ามไปยังหน้าเว็บโดยไม่แตะต้องตำแหน่งการเลื่อนหรือการซูม ซึ่งมักจะเป็นสิ่งที่คุณต้องการจากลิงก์ "ไปที่หน้า" ตัวเลขเหล่านี้อยู่ใน default user space (พื้นที่ผู้ใช้เริ่มต้น) วัดจากด้านล่างซ้ายโดยค่า y เพิ่มขึ้นขึ้นไปด้านบน ซึ่งเป็นระบบพิกัดเดียวกันกับที่ใช้ในเนื้อหาหน้าเว็บ ผู้เขียนที่คุ้นเคยกับเค้าโครงหน้าจอมักจะวัดจากด้านบน และส่งผู้อ่านไปยังส่วนท้ายหน้าเว็บแบบผิดๆ เสมอ
ตระกูล /Fit แลกการวางตำแหน่งที่แม่นยำกับความยืดหยุ่น [page /Fit] จะปรับขนาดทั้งหน้าให้พอดีกับหน้าต่าง, [page /FitH top] จะปรับความกว้างของหน้าให้พอดีกับขอบด้านบนที่กำหนด, และ [page /FitR l b r t] จะซูมสี่เหลี่ยมผืนผ้าให้เต็มมุมมอง เนื่องจากวิธีการเหล่านี้คำนวณมาตราส่วนจากรูปทรงของหน้าเว็บแทนที่จะเป็นพิกัดคงที่ ปลายทางแบบ /Fit จึงยังคงทำงานได้อย่างสมเหตุสมผลหลังจากที่หน้าเว็บถูกปรับขนาด ในขณะที่ปลายทางแบบ /XYZ ที่มีการซูมตายตัวอาจทำให้ผู้อ่านจ้องไปที่ขอบหน้าได้ สำหรับสารบัญ การใช้ /FitH กับพิกัดด้านบนของส่วนเนื้อหา จะมีอายุการใช้งานที่ยาวนานกว่า /XYZ ที่ใช้การเดาการซูม
คำอธิบายประกอบ: ทุกสิ่งที่โต้ตอบได้และไม่ใช่เนื้อหาหน้าเว็บ
คำอธิบายประกอบคือออบเจ็กต์ที่วางทับซ้อนหน้าเว็บโดยไม่ได้เป็นส่วนหนึ่งของสตรีมเนื้อหา ลิงก์, กระดาษโน้ต (sticky notes), ไฮไลต์, วิดเจ็ตฟอร์ม, ไอคอนแนบไฟล์, ตราประทับ (stamps): ทั้งหมดนี้ล้วนเป็นคำอธิบายประกอบ ซึ่งแสดงรายการอยู่ในอาร์เรย์ /Annots ของหน้าเว็บที่พวกมันตั้งอยู่ การลบคำอธิบายประกอบออกจากอาร์เรย์นั้น เป็นการลบมันออกจากหน้าเว็บ แม้ว่าเนื้อหาข้างใต้จะไม่ถูกแตะต้องเลยก็ตาม นั่นคือประเด็นสำคัญ: คำอธิบายประกอบคือชั้นของการแก้ไข ที่แยกส่วนต่างหากจากรอยต่างๆ ที่พวกมันวางทับอยู่
คำอธิบายประกอบทุกอันจะมีแกนร่วมกันเล็กๆ /Subtype บอกถึงชนิด, /Rect บอก bounding box ในพิกัดของหน้า, และ /Contents เก็บข้อความที่ทำหน้าที่เป็นคำอธิบายที่เข้าถึงได้ด้วย (accessible description) คำอธิบายประกอบแบบลิงก์เป็นกรณีที่น่าศึกษา เพราะมันมีอยู่สองรูปแบบ: ปลายทางแบบเปลือยๆ และแอ็กชัน (action)
12 0 obj
<< /Type /Annot /Subtype /Link
   /Rect [100 200 300 250]
   /Border [0 0 0]
   /Dest [5 0 R /XYZ null null null] >>
endobj
13 0 obj                                    % link that runs an action
<< /Type /Annot /Subtype /Link
   /Rect [50 50 200 100]
   /Border [0 0 0]
   /A << /Type /Action /S /URI /URI (https://www.example.com) >> >>
endobj
/Rect คือจุดฮอตสปอต; การคลิกข้างในจะส่งผู้อ่านไปยังปลายทาง โดยใช้ไวยากรณ์เดียวกับที่เค้าโครงใช้ /Border [0 0 0] มีหน้าที่สำคัญ คือการซ่อนสี่เหลี่ยมผืนผ้าเริ่มต้นที่น่าเกลียดซึ่งโปรแกรมดูมักจะวาดรอบลิงก์ รูปแบบที่สองจะเปลี่ยน /Dest เปลือยๆ เป็นแอ็กชัน /A โดย subtype ของมัน /S จะเลือกพฤติกรรม: /GoTo ภายในไฟล์นี้, /GoToR สำหรับไฟล์อื่น, /URI สำหรับที่อยู่เว็บ, /Launch เพื่อรันโปรแกรมภายนอก อย่างหลังสุดนี้เป็นสิ่งที่ควรระวังเป็นพิเศษ /Launch ที่เริ่มต้นไฟล์สั่งการ (executable) เป็นพฤติกรรมที่ทำให้ PDF กลายเป็นเวกเตอร์แพร่กระจายมัลแวร์ โปรแกรมดูที่ได้มาตรฐานจึงมักจะบล็อกมันหรือแจ้งเตือนอย่างชัดเจน ทำให้ลิงก์ใช้งานไม่ได้สำหรับผู้อ่านส่วนใหญ่ ดังนั้นควรเลือกใช้ /URI และ /GoTo แล้วปล่อย /Launch ไว้ตามเดิมจะดีที่สุด
คำอธิบายประกอบแบบมาร์กอัป (Markup annotations) เช่น ไฮไลต์และกระดาษโน้ต รวมถึงคำอธิบายประกอบรูปทรงอย่าง /Square มีสิ่งที่ต้องระวังเพิ่มเติม: รูปลักษณ์บนหน้าจอของพวกมันไม่ได้ถูกบอกเป็นนัยโดยประเภทของมัน โปรแกรมดูจะเรนเดอร์เวอร์ชันของตัวเอง เว้นแต่คุณจะกำหนดรูปลักษณ์ด้วย appearance stream คือรายการ /AP ซึ่งจะอ้างอิงไปยังฟอร์ม XObject ที่เก็บตัวดำเนินการวาดรูป (drawing operators) เอาไว้ หากข้ามส่วนนี้ไป ไฮไลต์แบบเดียวกันก็อาจดูแตกต่างกันได้ในโปรแกรมอ่านสองโปรแกรม หรือก่อนและหลังการแก้ไขไปและกลับ (round-trip) ในโปรแกรมแก้ไขเอกสาร สำหรับสิ่งใดก็ตามที่รูปลักษณ์ที่แน่นอนเป็นส่วนหนึ่งของเอกสาร ให้ระบุ /AP เสมอ อนึ่ง ไฟล์แนบ (File attachments) ก็ใช้กลไกแบบเดียวกันนี้: สตรีมไฟล์ที่ฝังไว้ (embedded file stream) และดิกชันนารีข้อกำหนดไฟล์ (file specification dictionary) ซึ่งปรากฏเป็นคำอธิบายประกอบ /FileAttachment หรือผ่านโครงสร้างต้นไม้ชื่อ /EmbeddedFiles ภายใต้ /Names ของ catalog
จุดที่ชั้นนี้มักจะพัง และวิธีตรวจจับ
ความล้มเหลวที่เกิดขึ้นบ่อยครั้งที่สุดสำหรับเรื่องนี้ทั้งหมด คือการอ้างอิงที่ห้อยต่องแต่ง (dangling reference) บุ๊กมาร์กหยุดแสดงผลเมื่อ catalog ไม่มีรายการ /Outlines หรือสายโซ่พี่น้องขาดตอนกลางโครงสร้างต้นไม้; เมทาดาตาจะถูกละเลยเมื่อสตรีม XMP ขาดเครื่องหมาย /Type /Metadata /Subtype /XML หรือ wrapper ของ xpacket มีรูปแบบที่ผิดเพี้ยน ในทุกกรณีเนื้อหาหน้าเว็บยังคงใช้งานได้ตามปกติ การเปิดดูแบบคร่าวๆ จึงดูเหมือนว่าถูกต้อง และข้อบกพร่องจะปรากฏก็ต่อเมื่อดูในแผงควบคุมที่ไม่มีใครตรวจสอบเท่านั้น
นิสัยง่ายๆ สองข้อสามารถช่วยตรวจจับปัญหาส่วนใหญ่ได้ เปิดไฟล์ที่เสร็จแล้วในโปรแกรมดูของจริง แล้วคลิกเข้าไปในแผงบุ๊กมาร์กและลิงก์ตัวอย่าง เพื่อทดสอบกราฟอ้างอิงแบบเดียวกับที่ผู้อ่านจะทำ จากนั้นใช้เครื่องมือแยกต่างหากอ่านเมทาดาตากลับมา เพื่อยืนยันว่า Info dictionary และ XMP สอดคล้องกัน ซึ่งเป็นความขัดแย้งจุดเดียวที่ไม่มีการคลิกใดๆ สามารถเปิดเผยได้ การสร้างชั้นข้อมูลนี้ผ่านไลบรารีที่จัดการการเก็บบันทึกลิงก์ จะช่วยให้คุณรอดพ้นจากกับดักเหล่านี้ได้ HotPDF Delphi Component สำหรับ Delphi และ C++Builder เผยแพร่โครงสร้างเค้าโครง คำอธิบายประกอบ และเมทาดาตาผ่าน API ระดับเอกสาร ดังนั้นคุณเพียงแค่อธิบายลำดับชั้นบุ๊กมาร์กและลิงก์ แล้วปล่อยให้มันร้อยเรียงการอ้างอิงให้เอง สำหรับโมเดลออบเจ็กต์ที่โครงสร้างเหล่านี้แนบมาด้วย ภาพรวมทางเทคนิคของโครงสร้างไฟล์ PDF ได้ครอบคลุมเรื่อง catalog และ cross-reference table ที่พวกมันต้องพึ่งพาเอาไว้แล้ว