ไฟล์ PDF โดยเนื้อแท้แล้วคือชุดของออบเจ็กต์ที่ชี้หากัน หากตัดเรื่องการบีบอัด การจัดการตารางการอ้างอิงข้าม (cross-reference bookkeeping) และไบต์ออฟเซ็ตออกไป สิ่งที่เหลืออยู่ก็คือกราฟ: ซึ่งก็คือกลุ่มของข้อมูลที่มีประเภทเชื่อมต่อกันด้วยการอ้างอิง โดยมีรากอยู่ที่ออบเจ็กต์ตัวเดียวที่โปรแกรมอ่านรู้วิธีค้นหา ทุกสิ่งที่ PDF สามารถแสดงออกมาได้ ตั้งแต่ย่อหน้าข้อความ ฟอนต์ที่ฝังไว้ ไปจนถึงลายเซ็นดิจิทัล ล้วนสร้างขึ้นจากออบเจ็กต์พื้นฐานแปดประเภทและกฎที่อนุญาตให้ออบเจ็กต์หนึ่งอ้างอิงถึงอีกออบเจ็กต์หนึ่งได้ หากเข้าใจสิ่งเหล่านี้ ส่วนที่เหลือของฟอร์แมตก็จะเข้าใจได้ว่าเป็นการประกอบเข้าด้วยกันแทนที่จะเป็นเรื่องลึกลับ
นี่คือเลเยอร์เชิงตรรกะของ PDF ซึ่งกำหนดไว้ใน ISO 32000-1 หมวด 7.3 และอยู่เหนือโครงสร้างไฟล์ทางกายภาพหนึ่งระดับ (header, body, cross-reference table และ trailer ซึ่งเป็นเรื่องที่อธิบายไว้ใน ภาพรวมทางเทคนิคของโครงสร้างไฟล์ PDF) โมเดลเชิงตรรกะคือความหมายของไบต์เหล่านั้นเมื่อถูกพาร์สแล้ว โปรแกรมดู (viewer) จะอ่านไฟล์ย้อนหลังเพื่อหา trailer ตามไปจนถึงราก และจากจุดนั้นเอกสารก็จะเผยออกมาในรูปแบบของออบเจ็กต์ที่อ้างอิงออบเจ็กต์ นี่คือส่วนที่คุณต้องนำมาใช้พิจารณาเมื่อคุณแก้บั๊กหน้าเอกสารที่ผิดรูปแบบ เขียนพาร์สเซอร์ หรือใช้ไลบรารีเพื่อประกอบเอกสารขึ้นมา
ออบเจ็กต์แปดประเภท และไม่มีอย่างอื่นอีก
PDF กำหนดออบเจ็กต์พื้นฐานไว้แปดประเภทถ้วน ทุกค่าในเอกสารจะเป็นหนึ่งในประเภทเหล่านี้ ซึ่งนี่คือสิ่งที่ทำให้ฟอร์แมตนี้จัดการได้ง่ายแม้จะครอบคลุมการใช้งานกว้างขวาง
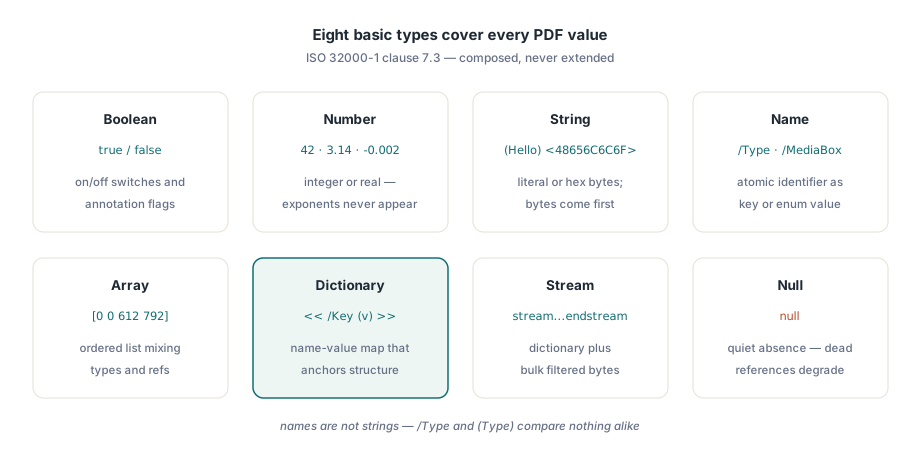
Booleans คือคีย์เวิร์ด true และ false พวกมันใช้เปิดและปิดแฟล็ก เช่น คำอธิบายประกอบจะถูกพิมพ์ออกมาหรือไม่
Numbers (ตัวเลข) มีสองรูปแบบซึ่งข้อกำหนดถือว่าเป็นประเภทเดียวกัน: จำนวนเต็มเช่น 42 และจำนวนจริงเช่น 3.14 หรือ -0.002 PDF ไม่มีสัญลักษณ์เลขยกกำลัง ดังนั้นคุณจะไม่มีวันเห็น 1e6 ในไฟล์ที่ถูกต้องตามมาตรฐาน พิกัด ขนาดฟอนต์ และมุมการหมุน ล้วนเป็นตัวเลข
Strings (สตริง) เก็บชุดของไบต์ เขียนอยู่ในวงเล็บเช่น (Hello) หรืออยู่ในเครื่องหมายวงเล็บมุมเป็นเลขฐานสิบหกเช่น <48656C6C6F> ทั้งสองรูปแบบเข้ารหัสเนื้อหาเดียวกัน รูปแบบฐานสิบหกคือทางออกสำหรับไบต์ที่ใส่ในวงเล็บได้ยาก สตริงเก็บข้อความก็จริง แต่มันเป็นไบต์ก่อนเป็นอันดับแรก ซึ่งเป็นเรื่องสำคัญทันทีที่คุณจัดการกับสิ่งใดก็ตามที่นอกเหนือจาก ASCII
Names (ชื่อ) คือโทเคนระดับอะตอมที่นำหน้าด้วยเครื่องหมายทับ: /Type, /Pages, /MediaBox ชื่อไม่ใช่สตริง แต่มันคือตัวระบุ ใช้เป็นคีย์ดิกชันนารีหรือค่าแจงนับ (enumerated value) และสองชื่อจะเท่ากันก็ต่อเมื่อมันตรงกันแบบไบต์ต่อไบต์ เครื่องหมายทับเป็นเพียงไวยากรณ์ ไม่ใช่ส่วนหนึ่งของชื่อ สิ่งนี้ทำให้มือใหม่ที่ปฏิบัติกับ /Times-Roman และสตริง (Times-Roman) ว่าใช้แทนกันได้ต้องสับสน เพราะฟอร์แมตนี้ไม่ได้เป็นเช่นนั้น
Arrays (อาร์เรย์) คือรายการที่มีลำดับและรวมข้อมูลได้หลายประเภทในวงเล็บก้ามปู: [0 0 612 792] คือสี่เหลี่ยมผืนผ้าของหน้า และอาร์เรย์สามารถผสมประเภทข้อมูลได้อย่างอิสระ รวมถึงการอ้างอิงไปยังออบเจ็กต์อื่น Dictionaries (ดิกชันนารี) คือตัวทำงานหลัก เขียนอยู่ระหว่าง << และ >> ดิกชันนารีทำหน้าที่จับคู่คีย์ชื่อกับค่าประเภทใดๆ และโครงสร้างที่มีความหมายแทบทุกอย่างใน PDF ทั้งหน้า catalog ฟอนต์ คำอธิบายประกอบ ล้วนเป็นดิกชันนารีที่มีคีย์ /Type ประกาศว่ามันคืออะไร
Streams (สตรีม) คือดิกชันนารีที่มีหางของข้อมูลไบต์ดิบระหว่างคีย์เวิร์ด stream และ endstream ดิกชันนารีจะอธิบายถึงไบต์เหล่านั้น (ความยาวของพวกมัน และฟิลเตอร์ใดๆ เช่น FlateDecode ที่ใช้บีบอัดพวกมัน) และส่วนไบต์ก็จะเก็บข้อมูลปริมาณมากเอาไว้: คำสั่งเนื้อหาหน้า โปรแกรมฟอนต์ที่ฝังไว้ รูปภาพ สตรีมคือที่ที่ PDF นำสิ่งใดก็ตามที่ใหญ่เกินไปหรือเป็นไบนารีเกินไปที่จะวางแทรกในบรรทัดมาเก็บไว้
ประเภทที่แปดคือ null object (ออบเจ็กต์ null) คือคีย์เวิร์ด null มันเป็นค่าที่มีอยู่จริง ซึ่งแตกต่างจากการไม่มีคีย์อยู่ รายการดิกชันนารีที่ตั้งค่าเป็น null จะถูกปฏิบัติเสมือนว่ามันไม่มีอยู่ และการอ้างอิงที่แก้ไขไปยังออบเจ็กต์ที่ไม่มีอยู่จริงก็จะให้ค่าเป็น null แทนที่จะเป็นข้อผิดพลาด พฤติกรรมที่ให้อภัยนี้ตั้งใจทำไว้: เพื่อให้ไฟล์ที่เสียหายสามารถลดทอนการทำงานลงได้แทนที่จะปฏิเสธการเปิดไฟล์ ไม่มีประเภทที่เก้า; ทุกสิ่งที่ PDF แสดงออกมาล้วนเกิดจากการรวมกันของออบเจ็กต์แปดประเภทนี้
ค่าทางตรง ออบเจ็กต์ทางอ้อม และการอ้างอิง
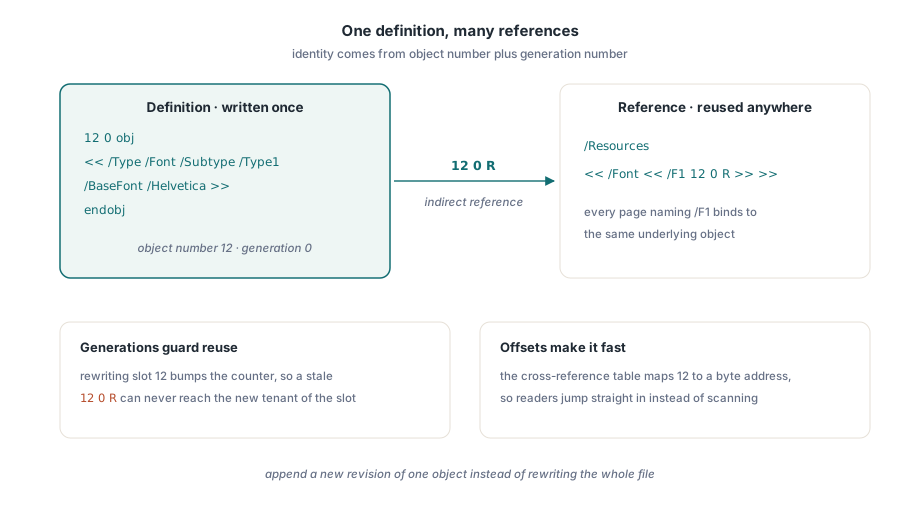
ทั้งแปดประเภทนั้นสามารถปรากฏได้สองแบบ ออบเจ็กต์ทางตรง (direct) จะถูกเขียนลงในตำแหน่งนั้นเลย เช่น 612 ภายในอาร์เรย์ MediaBox ส่วนออบเจ็กต์ทางอ้อม (indirect) จะได้รับอัตลักษณ์เพื่อให้ออบเจ็กต์อื่นชี้มาที่มันได้: ตัวเลขจำนวนเต็มสองตัว คือหมายเลขออบเจ็กต์และหมายเลขเจเนอเรชัน ห่อหุ้มด้วย obj และ endobj:
12 0 obj
<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica >>
endobj
นี่คือออบเจ็กต์ 12 เจเนอเรชัน 0 ซึ่งเป็นดิกชันนารีฟอนต์ หากส่วนอื่นในไฟล์ ออบเจ็กต์อื่นอ้างอิงถึงมันด้วย การอ้างอิงทางอ้อม: ก็จะใช้ตัวเลขสองตัวเดิมตามด้วยคีย์เวิร์ด R เป็น 12 0 R การอ้างอิงนี้คือพอยน์เตอร์ เมื่อดิกชันนารีทรัพยากรของหน้าบอกว่า /Font << /F1 12 0 R >> มันกำลังระบุชื่อออบเจ็กต์ 12 เป็นฟอนต์ที่อยู่เบื้องหลังชื่อทรัพยากร /F1 โดยไม่ต้องคัดลอกนิยามของฟอนต์เข้าไปในหน้านั้น
หมายเลขเจเนอเรชันมีไว้สำหรับการลบและการนำกลับมาใช้ใหม่ เมื่อออบเจ็กต์หนึ่งถูกเคลียร์และสล็อตของมันถูกนำมาใช้ใหม่ เจเนอเรชันจะเพิ่มขึ้นเพื่อไม่ให้ 12 0 R ที่เก่าแล้วสามารถอ้างอิงไปยังผู้เช่ารายใหม่ของสล็อต 12 ได้ ไฟล์ที่เพิ่งเขียนใหม่เกือบทั้งหมดจะเป็นเจเนอเรชัน 0 แต่ไฟล์ที่ถูกแก้ไขอย่างหนักอาจจะมีตัวเลขที่สูงกว่า และพาร์สเซอร์ที่เพิกเฉยต่อเจเนอเรชันก็จะอ่านออบเจ็กต์ผิดตัวในที่สุด
ความเป็นทางอ้อม (Indirection) คือสิ่งที่ทำให้ PDF มีประสิทธิภาพและแก้ไขได้ ฟอนต์ รูปภาพ หรือปริภูมิสีสามารถกำหนดได้ครั้งเดียวและอ้างอิงจากร้อยหน้า การเปลี่ยนแปลงเล็กๆ น้อยๆ สามารถต่อท้ายเป็นฉบับแก้ไขใหม่ซึ่งจะเข้าไปแทนที่ออบเจ็กต์เดี่ยวแทนที่จะเขียนไฟล์ใหม่ทั้งหมด ตารางการอ้างอิงข้ามคือดัชนีที่เปลี่ยนหมายเลขออบเจ็กต์เป็นไบต์ออฟเซ็ต เพื่อให้โปรแกรมอ่านข้ามตรงไปที่ 12 0 obj โดยไม่ต้องสแกน แต่นั่นคือการปรับปรุงประสิทธิภาพทางกายภาพ ในเชิงตรรกะแล้ว สิ่งที่คุณต้องรู้ก็คือ 12 0 R หมายถึง "ออบเจ็กต์ที่ระบุเป็น 12 0"
Catalog: จุดเริ่มต้นของทุกเอกสาร
การแก้ไขการอ้างอิงจะต้องเริ่มต้นจากที่ใดที่หนึ่ง และที่นั่นก็คือรายการ /Root ของ trailer ซึ่งจะชี้ไปที่ document catalog (แค็ตตาล็อกเอกสาร): ที่เป็นรากของกราฟออบเจ็กต์ เป็นดิกชันนารีที่มี /Type /Catalog โปรแกรมอ่านจะเข้าถึงมันเป็นอันดับแรกเนื่องจากเจอ trailer ก่อน และจากนั้นทุกส่วนอื่นๆ ของเอกสารก็จะเข้าถึงได้โดยการตามการอ้างอิงไป
catalog มีรายการที่บังคับใช้จริงๆ เพียงสองรายการเท่านั้น: คือ /Type ของมัน และ /Pages ซึ่งเป็นการอ้างอิงทางอ้อมไปยังรากของโครงสร้างต้นไม้หน้าเว็บ ส่วนที่เหลือนั้นเป็นทางเลือกและอธิบายถึงพฤติกรรมทั่วทั้งเอกสารแทนที่จะเป็นเนื้อหา: /Outlines ชี้ไปที่โครงสร้างต้นไม้ของบุ๊กมาร์ก, /Names เก็บโครงสร้างต้นไม้ของชื่อที่มีคีย์เป็นสตริง, /Metadata อ้างอิงไปยังสตรีมข้อมูลเมตา XMP, และ /PageMode กับ /PageLayout จะแนะนำว่าโปรแกรมดูควรเปิดเอกสารอย่างไร ไม่มีรายการใดที่จำเป็นต่อการเรนเดอร์หน้าเว็บ; พวกมันแค่กำหนดค่าประสบการณ์รอบๆ หน้าเว็บ โครงสร้างของบุ๊กมาร์ก ข้อมูลเมตา และคำอธิบายประกอบที่พ่วงมากับ catalog จะถูกหยิบยกมาอธิบายในบทความเรื่อง ข้อมูลเมตา บุ๊กมาร์ก และคำอธิบายประกอบใน PDF
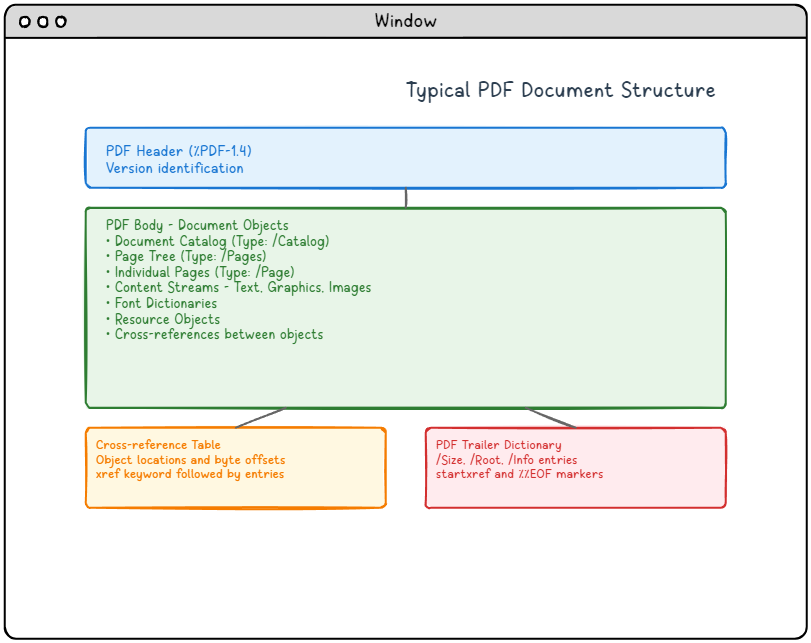
แผนภาพด้านล่างแสดงตำแหน่งของออบเจ็กต์บอดีที่อยู่ในไฟล์แวดล้อม catalog และโครงสร้างต้นไม้หน้าเว็บจะอาศัยอยู่ภายในบอดี้นั้นในฐานะออบเจ็กต์ทางอ้อมธรรมดา; ส่วน header, cross-reference table และ trailer ที่อยู่รอบๆ พวกมันคือโครงร่างทางกายภาพที่ทำให้โปรแกรมอ่านค้นหาพวกมันพบ
โครงสร้างต้นไม้หน้าเว็บ: ลำดับชั้นที่สมดุลของหน้าต่างๆ
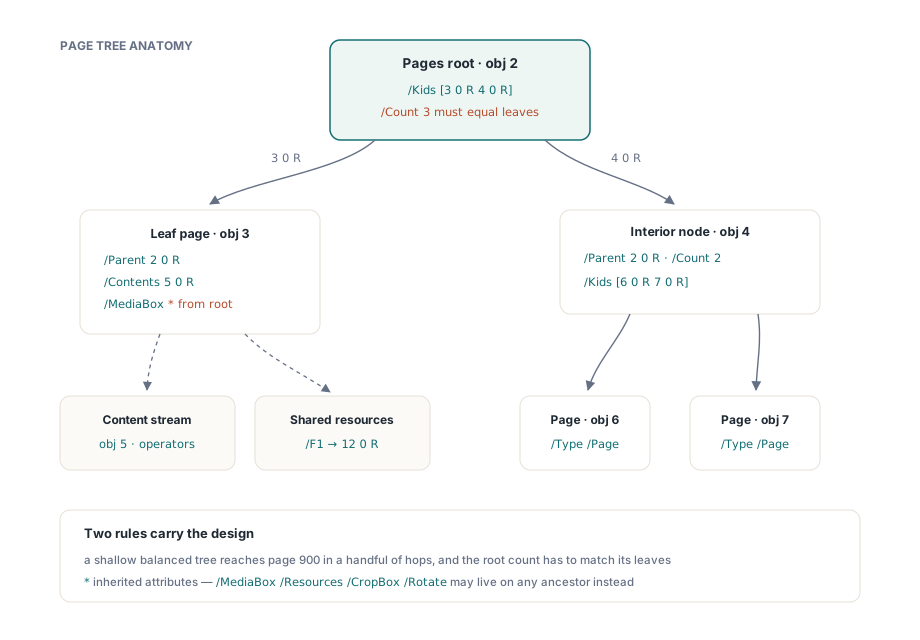
จาก /Pages เอกสารจะแตกแขนงออกเป็นโครงสร้างต้นไม้หน้าเว็บ (page tree) ซึ่งเป็นจุดที่ทางเลือกของ PDF ในการใช้กราฟแทนลิสต์แบบแบนๆ สัมฤทธิ์ผล หน้าต่างๆ ไม่ได้ถูกเก็บไว้เป็นลำดับอย่างง่ายๆ; มันเกาะอยู่กับโครงสร้างต้นไม้ที่โหนดภายในของมันคือ page tree nodes (โหนดของโครงสร้างต้นไม้หน้าเว็บ /Type /Pages) และใบของพวกมันคือ page objects (ออบเจ็กต์หน้าเว็บ /Type /Page) โหนดภายในแสดงรายการลูกๆ ในอาร์เรย์ /Kids และบันทึกจำนวนใบของหน้าเว็บที่อยู่ข้างใต้ใน /Count โหนดทุกโหนด ยกเว้นราก จะมีการอ้างอิง /Parent ชี้กลับขึ้นไป ดังนั้นต้นไม้สามารถเดินหน้าถอยหลังในทิศทางใดก็ได้
2 0 obj                                  % root ของ page tree
<< /Type /Pages /Kids [3 0 R 4 0 R] /Count 3 >>
endobj

3 0 obj                                  % a leaf page
<< /Type /Page /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 12 0 R >> >>
   /Contents 5 0 R >>
endobj

4 0 obj                                  % โหนดภายในที่จัดกลุ่มอีกสองหน้า
<< /Type /Pages /Parent 2 0 R /Kids [6 0 R 7 0 R] /Count 2 >>
endobj
ในที่นี้ ออบเจ็กต์ 2 คือราก ซึ่งมีสามหน้าอยู่ใต้รากนี้: หน้าที่เป็นใบหมายเลข 3 และอีกสองหน้าที่เข้าถึงได้ผ่านโหนดภายในหมายเลข 4 ค่า /Count 3 ของรากจะต้องเท่ากับจำนวนใบทั้งหมดที่อยู่ใต้มัน และการนับที่ไม่ตรงกับโครงสร้างจริงก็เป็นวิธีทั่วไปที่ไฟล์ที่แก้ไขด้วยมือจะเกิดข้อผิดพลาด ประเด็นของโครงสร้างต้นไม้คือความเฉพาะที่ของการเข้าถึง (locality of access) โปรแกรมอ่านที่เปิดหน้า 900 ของเอกสารความยาวพันหน้าไม่ต้องเดินผ่าน 900 ออบเจ็กต์; มันจะลงไปยังโหนดเพียงไม่กี่โหนด เนื่องจากโครงสร้างต้นไม้ที่ถูกต้องจะมีความตื้นและสมดุล การสร้างโครงสร้างต้นไม้แบบนั้นด้วยมือก็ยุ่งยากพอที่จะคุ้มค่ากับการดูการทำงานตั้งแต่ต้นจนจบ ซึ่งคำอธิบายเรื่อง การสร้างเอกสาร PDF ตั้งแต่เริ่มต้น ได้ทำไว้แล้ว
โครงสร้างต้นไม้ยังมีประโยชน์อีกอย่างผ่าน การสืบทอด (inheritance) แอตทริบิวต์ของหน้าเว็บจำนวนหนึ่ง ได้แก่ /Resources, /MediaBox, /CropBox และ /Rotate สามารถตั้งค่าบนโหนดภายในและปล่อยให้ละเว้นในหน้าเว็บแต่ละหน้าได้ ซึ่งจากนั้นก็จะสืบทอดค่าจากบรรพบุรุษที่ใกล้ที่สุด ตั้งค่า /MediaBox เพียงครั้งเดียวที่ราก และทุกใบก็จะได้รับขนาดหน้าเว็บที่เท่ากันโดยไม่ต้องทำซ้ำ; หน้าใดที่ต้องแตกต่างออกไปก็ประกาศเป็นของตัวเอง นี่คือจุดเดียวในโมเดลออบเจ็กต์ที่ความหมายของค่าจะขึ้นอยู่กับตำแหน่งของออบเจ็กต์ในโครงสร้างต้นไม้ ไม่ใช่แค่เนื้อหาของมันเท่านั้น
สิ่งที่หน้าเว็บที่เป็นใบมีอยู่จริงๆ
ออบเจ็กต์หน้าเว็บคือจุดเชื่อมต่อระหว่างโมเดลเชิงโครงสร้างกับเนื้อหาที่มองเห็นได้ รายการ /Contents ของมันจะอ้างอิงไปยังสตรีมเนื้อหาหนึ่งหรือหลายสตรีม ซึ่งก็คือตัวดำเนินการวาดรูปที่วาดข้อความและกราฟิกลงบนหน้า ดิกชันนารี /Resources จะตั้งชื่อให้กับฟอนต์ รูปภาพ และปริภูมิสีที่ตัวดำเนินการเหล่านั้นต้องใช้ แต่ละรายการจะเป็นการอ้างอิงทางอ้อมไปยังออบเจ็กต์ที่แชร์ข้ามหน้า /MediaBox จะกำหนดพื้นที่หน้าในหน่วยพอยต์ (1/72 นิ้ว) และรายการเช่น /Rotate และ /CropBox จะปรับรูปแบบการแสดงผล
การแบ่งงานนั้นคือทั้งโมเดลในแบบย่อส่วน ดิกชันนารีหน้าเว็บคือโครงสร้าง: เป็นรายการข้อมูลระบุประเภทและการอ้างอิงที่บอกว่าหน้าคืออะไรและมันวาดด้วยอะไร สตรีมเนื้อหาคือคำสั่ง: เป็นก้อนข้อมูลแยกต่างหากที่บีบอัดได้ ซึ่งบอกวิธีวาด ฟอนต์ที่อยู่เบื้องหลัง /F1 คือทรัพยากรที่ใช้ร่วมกัน ซึ่งถูกกำหนดไว้ครั้งเดียวและถูกชี้ไปในทุกที่ที่ใช้งาน ดิกชันนารี สตรีม และการอ้างอิงจะทำงานร่วมกันเพื่อเรนเดอร์หนึ่งหน้า และรูปแบบที่เหมือนกันก็สเกลไปสู่ทั้งเอกสาร ตัวดำเนินการสตรีมเนื้อหาที่อยู่ภายในก้อนข้อมูลนั้นจะถูกอธิบายแยกต่างหากในเรื่อง ข้อความและฟอนต์ และเรื่อง กราฟิกและองค์ประกอบภาพ
/Count และส่งลงแอตทริบิวต์อย่าง /MediaBox ให้ลูกหลานทุกตัวเหตุใดโมเดลนี้จึงน่ารู้
นักพัฒนาส่วนใหญ่มักจะพบกับโมเดลออบเจ็กต์ก็ต่อเมื่อมีสิ่งใดผิดปกติเท่านั้น: หน้าเว็บเรนเดอร์มาว่างเปล่าเพราะการอ้างอิง /Contents ของมันลอยเคว้ง ข้อความออกมาเป็นกล่องสี่เหลี่ยมเพราะไม่เคยฝังทรัพยากรฟอนต์เลย เครื่องมือรายงานค่า /Count ที่ไม่ตรงกับหน้าที่มันหาพบ สิ่งเหล่านี้ล้วนเป็นข้อความบ่งชี้เกี่ยวกับกราฟ และการอ่านกราฟโดยตรงก็ดีกว่าการเดา ออบเจ็กต์ทั้งแปดประเภทและกฎการอ้างอิงเป็นคำศัพท์ที่เล็กพอที่จะจำไว้ในหัวได้ และเมื่อคุณมองเห็น PDF ว่าเป็นออบเจ็กต์ที่ชี้ไปยังออบเจ็กต์อื่นๆ ไฟล์ที่ผิดรูปแบบก็จะเลิกเป็นเรื่องลึกลับ
ถึงอย่างนั้น การเขียนโมเดลด้วยมือก็แทบจะไม่ใช่ทางเลือกที่ถูกต้องนอกเหนือจากการเรียนรู้ การรักษาความสอดคล้องของออฟเซ็ตการอ้างอิงข้าม หมายเลขเจเนอเรชัน จำนวนโครงสร้างต้นไม้หน้าเว็บ และความยาวของสตรีมเมื่อมีการแก้ไขคือการจัดการบัญชีที่ไลบรารีมีหน้าที่จัดการ ในสายการผลิต ไลบรารีพัฒนา PDF ที่สมบูรณ์แบบ จะจัดการกับกราฟออบเจ็กต์ในขณะที่ปล่อยให้คุณคิดเรื่องหน้าเว็บและเนื้อหา การเข้าใจถึงโมเดลนี้ก็ยังมีประโยชน์: คุณจะเข้าใจว่าไลบรารีสร้างอะไรไว้ข้างใต้ และทำไมถึงทำเช่นนั้น