สเปรดชีตที่มีแถวเป็นล้านและคอลัมน์เป็นโหลเป็นเพียงการส่งออกธรรมดาทั่วไปจากงานจัดทำรายงานของฐานข้อมูล หากเปิดใช้งานด้วยวิธีปกติ โดยการโหลดเวิร์กบุ๊กทั้งหมดลงใน TXLSWorkbook กระบวนการจะต้องสร้างออบเจ็กต์สด (live object) สำหรับทุกเซลล์ในจำนวนสิบสองล้านเซลล์นั้น ก่อนที่โค้ดตรรกะทางธุรกิจบรรทัดแรกของคุณจะเริ่มทำงาน ไฟล์บนดิสก์อาจเป็น XML ที่บีบอัดแล้วขนาดหกสิบเมกะไบต์ โครงสร้างต้นไม้ออบเจ็กต์ที่มันขยายตัวออกมานั้นใหญ่กว่าหลายเท่า และมันทั้งหมดต้องอยู่ในหน่วยความจำพร้อมกันเนื่องจากโมเดลนี้ออกแบบมาให้เข้าถึงแบบสุ่ม (random-access) สำหรับรายงานที่คุณตั้งใจจะอ่านจากบนลงล่างแล้วทิ้งไป นั่นถือเป็นการใช้หน่วยความจำจำนวนมหาศาลกับโครงสร้างที่คุณไม่เคยต้องการ
มีเส้นทางที่สองผ่านไฟล์เดียวกันนี้ แทนที่จะสร้างโมเดล คุณสแกน XML ของเวิร์กชีตไปข้างหน้าอย่างเดียว ทีละเซลล์ และปล่อยให้แต่ละเซลล์ผ่านไปหลังจากที่คุณดูเสร็จแล้ว จะไม่มีอะไรสะสม หน่วยความจำจะคงที่เกือบตลอดเวลาไม่ว่าชีตนั้นจะมีพันแถวหรือสิบล้านแถวก็ตาม เพราะเครื่องอ่านจะไม่ถือครองอะไรมากไปกว่าส่วนที่กำลังแยกวิเคราะห์บวกกับตารางค้นหาเล็กๆ สองสามตาราง นี่คือสิ่งที่เครื่องอ่านโดยตรงของ HotXLS ทำ และเนื้อหาที่เหลือในบทความนี้จะพูดถึงสาเหตุที่มันมีขนาดเล็กและสิ่งที่คุณจะได้รับเป็นการตอบแทน
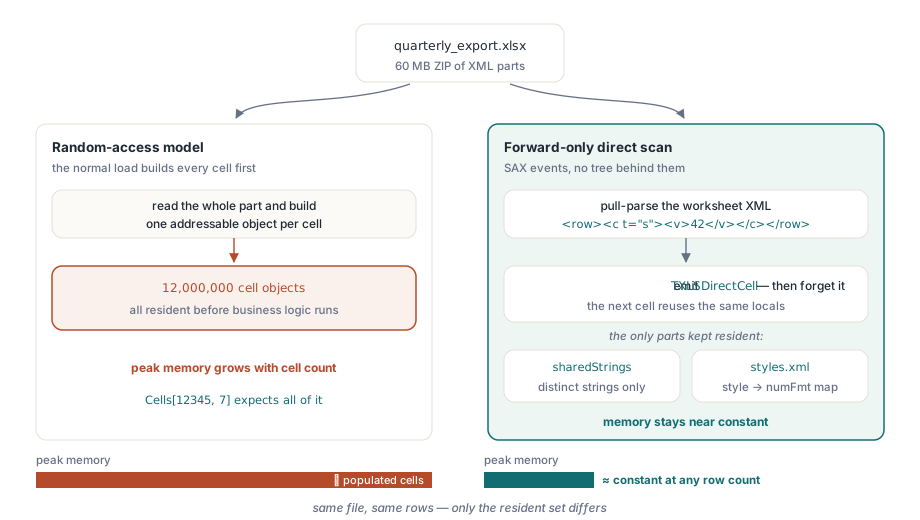
เหตุใดโมเดลในหน่วยความจำจึงไม่สามารถปรับขนาดได้
ไฟล์ XLSX เป็นแพ็กเกจ ZIP ของส่วนประกอบ XML ที่อธิบายโดย ECMA-376 แต่ละเวิร์กชีตจะเป็นส่วนของตัวมันเอง xl/worksheets/sheetN.xml และข้างในนั้น ทุกแถวจะเป็นอิลิเมนต์ <row> ที่มีอิลิเมนต์เซลล์ <c> เส้นทางการโหลดปกติจะอ่านส่วนนั้นและสร้างออบเจ็กต์ที่สามารถระบุตำแหน่งได้สำหรับแต่ละเซลล์ เพื่อที่คุณจะได้สามารถเรียก Cells[12345, 7] ในภายหลังและได้คำตอบในเวลาคงที่ การเข้าถึงแบบสุ่มคือจุดประสงค์ทั้งหมดของโมเดลเวิร์กบุ๊ก และนั่นคือสิ่งที่ทำให้การแก้ไข การประเมินสูตร และการจัดรูปแบบสะดวกสบาย
ค่าใช้จ่ายที่ต้องเสียคือ การเข้าถึงแบบสุ่มต้องการให้ทุกอย่างแสดงอยู่พร้อมกัน คุณไม่สามารถจัดทำดัชนีลงในโครงสร้างที่คุณเพิ่งสร้างเสร็จเพียงบางส่วน ดังนั้นหน่วยความจำสูงสุดของการโหลดเต็มรูปแบบจึงเป็นฟังก์ชันของจำนวนเซลล์ และบนชีตที่มีเซลล์ที่มีข้อมูลหลายล้านเซลล์ ฟังก์ชันนั้นจะไปตกอยู่ในที่ที่บริการของคุณไม่ต้องการอยู่ โดยเฉพาะอย่างยิ่งหากมีงานดังกล่าวหลายงานรันพร้อมกันบนเครื่องที่ใช้งานร่วมกัน เมื่อรูปแบบการเข้าถึงที่คุณต้องการจริงๆ เป็นแบบตามลำดับ การจ่ายสำหรับการเข้าถึงแบบสุ่มคือการจ่ายสำหรับความสามารถที่คุณจะไม่ได้ใช้
การสแกนแบบ SAX ไปข้างหน้าอย่างเดียวที่ไม่สร้างโครงสร้างต้นไม้
เครื่องอ่านโดยตรงจะเปิดแพ็กเกจ ZIP และสำรวจแต่ละส่วนของเวิร์กชีตด้วยตัวแยกวิเคราะห์แบบดึง (pull parser) สไตล์ SAX คำว่า SAX ในที่นี้หมายความว่าตัวแยกวิเคราะห์จะรายงานเหตุการณ์การแยกวิเคราะห์เมื่อมันพบเจอ ได้แก่ อิลิเมนต์เริ่มต้น, ชุดข้อความ, อิลิเมนต์สิ้นสุด แล้วจึงเดินหน้าต่อไป มันไม่ได้เก็บรักษาโครงสร้างต้นไม้ของโหนดใดๆ ไว้เบื้องหลัง เครื่องอ่านจะติดตามแถวและคอลัมน์ปัจจุบันจากแอตทริบิวต์ r, รวบรวมประเภทของเซลล์ ดัชนีสไตล์ ค่า และข้อความสูตรเมื่อมีเหตุการณ์มาถึง และเมื่อพบแท็กปิด </c> มันจะปล่อยหนึ่งเซลล์ออกมาแล้วก็ลืมมันไป เซลล์ถัดไปก็จะนำตัวแปรท้องถิ่นชุดเดิมที่มีอยู่หยิบมือเดียวนั้นมาใช้ซ้ำ
เนื่องจากไม่มีการเก็บสิ่งใดไว้ระหว่างเซลล์เลย ขนาดหน่วยความจำที่ใช้งานจึงไม่เพิ่มขึ้นตามจำนวนเซลล์ นั่นคือคุณสมบัติที่ควรค่าแก่การรักษาไว้ ชีตที่มีสองร้อยแถวกับชีตที่มียี่สิบล้านแถวใช้หน่วยความจำที่รันโปรแกรมของเครื่องอ่านเท่ากัน และความแตกต่างระหว่างทั้งสองคือระยะเวลาที่ใช้ในการสแกนเท่านั้น คุณยอมทิ้งการเข้าถึงแบบสุ่ม ซึ่งเป็นคุณลักษณะเด่นของโมเดลนี้ และเพื่อเป็นการแลกเปลี่ยน คุณจะได้รับเพดานหน่วยความจำที่จำนวนเซลล์ไม่สามารถผลักดันให้ทะลุได้
สิ่งใดที่ยังคงอยู่ และเหตุใดจึงต้องเป็นสองส่วนนั้น
การสแกนไม่ใช่ว่าจะไม่มีการรักษาสถานะ (stateless) ไปเสียทั้งหมด และข้อยกเว้นก็เป็นสิ่งที่น่าเรียนรู้ มีตารางขนาดเล็กสองตารางที่ต้องถูกเก็บไว้ในหน่วยความจำตลอดช่วงเวลา เนื่องจากเซลล์เพียงอย่างเดียวนั้นไม่ได้มีข้อมูลเพียงพอที่จะตีความได้หากไม่มีตารางเหล่านั้น
อย่างแรกคือตารางสตริงที่ใช้ร่วมกัน (shared string table) ใน SpreadsheetML เซลล์ข้อความไม่ได้จัดเก็บข้อความของตัวเอง มันมี t="s" และเนื้อหาตัวเลขที่เป็นดัชนีชี้ไปยัง xl/sharedStrings.xml ซึ่งเป็นรายการสตริงที่แตกต่างกันทุกตัวในเวิร์กบุ๊กที่ถูกลบรายการซ้ำออกหมดแล้ว นี่เป็นการประหยัดพื้นที่ที่ดีสำหรับไฟล์ที่ฉลาก (label) เดียวกันซ้ำกันเป็นพันๆ แถว แต่มันหมายความว่าเครื่องอ่านต้องโหลดตารางสตริงนั้นตั้งแต่เริ่มต้นและเก็บมันไว้ในหน่วยความจำ เนื่องจากเซลล์ใดๆ ก็ตามที่ใดก็ได้ในชีตใดๆ อาจอ้างอิงถึงรายการใดก็ได้ในนั้น ตารางถูกกำหนดขนาดตามจำนวนของสตริงที่แตกต่างกัน ไม่ใช่ตามจำนวนเซลล์ ดังนั้นจึงมีขนาดพอประมาณแม้บนชีตที่ใหญ่โตมโหฬาร
อย่างที่สองคือการแมปรูปแบบตัวเลข (number-format) จากส่วนของสไตล์ (styles) เซลล์ตัวเลขและเซลล์วันที่นั้นเหมือนกันทุกไบต์ในระดับล่าง: ทั้งคู่คือตัวเลขล้วนๆ เพราะวันที่ใน SpreadsheetML เป็นเพียงการนับวันแบบอนุกรม สิ่งเดียวที่แยกแยะมันออกจากกันคือสไตล์ของเซลล์ ซึ่งชี้ผ่าน cellXfs ใน xl/styles.xml ไปยัง ID ของรูปแบบตัวเลข ในการรายงานวันที่ในฐานะวันที่ ไม่ใช่เป็นหมายเลขลำดับดิบ เครื่องอ่านต้องโหลดตารางแมปรูปแบบของสไตล์นั้นและเก็บไว้ในหน่วยความจำ สิ่งอื่นๆ ในไฟล์ คือข้อมูลเซลล์จริงที่เป็นส่วนใหญ่ของไบต์ จะสตรีมผ่านไปโดยไม่ถูกจัดเก็บ
ทุกเซลล์รายงานชนิดและค่า
เซลล์ที่ถูกส่งออกแต่ละเซลล์มาในรูปแบบของเรกคอร์ด TXLSDirectCell มันมาพร้อมกับดัชนีเวิร์กชีตและชื่อ, แถวและคอลัมน์ที่เริ่มต้นด้วย 1 (1-based), Kind ในเชิงความหมาย, Value เป็น Variant, ข้อความ Formula โดยไม่มีเครื่องหมายเท่ากับนำหน้า และ StyleIndex แบบดิบ ชนิดเป็นหนึ่งใน xdkNumber, xdkString, xdkBoolean, xdkDate หรือ xdkError ดังนั้นคุณจึงสามารถแยกสาขาว่าเซลล์มีความหมายอย่างไรแทนที่จะได้มาใหม่จากแอตทริบิวต์ เซลล์สูตรจะรายงานชนิดของผลลัพธ์ที่แคชไว้ พร้อมกับข้อความสูตรที่อยู่เคียงข้าง ดังนั้นผลรวมที่คำนวณได้จะส่งผ่านมาเป็นตัวเลขซึ่งยังบอกคุณได้ด้วยว่ามันถูกสร้างมาได้อย่างไร
type
  TReportScan = class
    procedure OnCell(Sender: TObject; const Cell: TXLSDirectCell;
      var Abort: Boolean);
  end;

procedure TReportScan.OnCell(Sender: TObject; const Cell: TXLSDirectCell;
  var Abort: Boolean);
begin
  case Cell.Kind of
    xdkString:  AccumulateLabel(Cell.Row, Cell.Col, VarToStr(Cell.Value));
    xdkNumber:  AddToTotals(Cell.Col, Double(Cell.Value));
    xdkDate:    NoteWhen(Cell.Row, VarToDateTime(Cell.Value));
    xdkBoolean: FlagRow(Cell.Row, Boolean(Cell.Value));
    xdkError:   LogBadCell(Cell.Row, Cell.Col, VarToStr(Cell.Value));
  end;
end;
การแยกวันที่ออกจากตัวเลข
คำถามเกี่ยวกับวันที่จะต้องดูอย่างใกล้ชิดเนื่องจากเป็นจุดที่เครื่องสแกนที่เรียบง่ายส่วนใหญ่ผิดพลาด ไม่มีชนิดข้อมูลวันที่ในเซลล์ตัวเลข เซลล์ที่เก็บค่าอนุกรม 46000 อาจเป็นปริมาณ ราคา หรือวันที่ 17 กุมภาพันธ์ 2025 ก็ได้ และไฟล์จะบอกคุณว่าเป็นแบบใดผ่านรหัสรูปแบบตัวเลข (number-format id) ที่เข้าถึงผ่านสไตล์ของเซลล์เท่านั้น ECMA-376 สงวนกลุ่มของรหัสรูปแบบที่มาพร้อมกับตัว ซึ่งความหมายนั้นตายตัวในทุกโปรแกรมสร้างไฟล์ที่สอดคล้องตามมาตรฐาน และรหัสที่มีหน้าทีถือวันที่นั้นอยู่ในช่วงสองช่วง: 14 ถึง 22 สำหรับรูปแบบวันที่และเวลามาตรฐาน และ 45 ถึง 47 สำหรับรูปแบบเวลาที่ผ่านไป (elapsed-time formats) เช่น [h]:mm:ss เมื่อเปิดใช้ DetectDates (ซึ่งจะเปิดโดยค่าเริ่มต้น) เครื่องอ่านจะแก้ปัญหาสไตล์ของเซลล์ตัวเลขแต่ละเซลล์ให้เป็น ID ของรูปแบบ และเซลล์ที่มี ID ตกอยู่ในช่วงที่สงวนไว้เหล่านั้นจะถูกรายงานเป็น xdkDate โดยที่ Value ของมันถูกแปลงเป็น TDateTime ของ Delphi เรียบร้อยแล้ว รูปแบบที่กำหนดเองก็จะถูกตรวจสอบด้วย โดยการตรวจสอบโค้ดรูปแบบเพื่อหาโทเคนวันที่และเวลา แต่ช่วงที่สงวนไว้คือแกนหลักที่เชื่อถือได้ หากปิดการทำงานของ DetectDates ตารางสไตล์ก็จะไม่ถูกโหลดแม้แต่น้อย ทุกเซลล์ตัวเลขจะมาเป็น xdkNumber และการสแกนจะใช้ทรัพยากรน้อยลงเล็กน้อย
ข้ามชีตและยกเลิกก่อนกำหนด
การสแกนตามลำดับมีข้อได้เปรียบที่เงียบเชียบซึ่งการเข้าถึงแบบสุ่มไม่สามารถเทียบได้: คุณสามารถหยุดได้ อีเวนต์ OnSheet จะถูกเรียกก่อนที่เวิร์กชีตแต่ละเวิร์กชีตจะถูกเปิด และมันจะให้สวิตช์แก่คุณสองตัว กำหนดให้ SkipSheet แล้วชิ้นส่วนทั้งหมดนั้นก็จะไม่ถูกแยกวิเคราะห์เลย ซึ่งนี่เป็นวิธีที่คุณจะสแกนเฉพาะชีตที่คุณสนใจในเวิร์กบุ๊กที่มีหลายชีตโดยไม่ต้องเสียทรัพยากรในการอ่านส่วนที่เหลือ กำหนดให้ Abort แล้วการสแกนทั้งหมดจะสิ้นสุดลงทันที อีเวนต์ OnCell มี Abort ของมันเอง คุณจึงสามารถหยุดได้ทันทีที่คุณพบสิ่งที่คุณกำลังค้นหา เช่น แถวที่เฉพาะเจาะจง, ค่าเซนทิเนล (sentinel value), สิ้นสุดบล็อกส่วนหัว โดยไม่ต้องอ่านเซลล์หลายล้านเซลล์ที่เหลืออยู่ ในการสแกนแบบไปข้างหน้าอย่างเดียว การยกเลิกนั้นไม่เสียค่าใช้จ่ายอย่างแท้จริง เนื่องจากงานที่คุณข้ามไปคืองานที่ยังไม่เกิดขึ้น
procedure TReportScan.OnSheet(Sender: TObject; SheetIndex: Integer;
  const SheetName: WideString; var SkipSheet: Boolean; var Abort: Boolean);
begin
  // สแกนเฉพาะ sheet "Data" และไม่อ่านส่วนที่เหลือ
  SkipSheet := SheetName <> 'Data';
end;
การนับจำนวนเซลล์โดยไม่มีตัวจัดการ
การปรับปรุงล่าสุดอย่างหนึ่งก็น่ากล่าวถึงเพราะมันเปลี่ยนคำถามที่พบบ่อยให้กลายเป็นการเรียกใช้งานราคาถูกเพียงครั้งเดียว เครื่องอ่านจะนับจำนวนเซลล์ที่มีข้อมูลทุกเซลล์ที่มันผ่าน และจะทำเช่นนี้ไม่ว่าจะมีการแนบตัวจัดการ OnCell ไว้หรือไม่ ก่อนหน้านี้ หากไม่ได้ตั้งค่าตัวจัดการ จำนวนเซลล์ที่มีข้อมูลจะกลับมาเป็นศูนย์ เนื่องจากผลของการนับคือผลข้างเคียงของการส่งออก ตอนนี้การนับจำนวนเป็นอิสระจากการส่งออก นั่นหมายความว่าคุณสามารถถามคำถามหนึ่งข้อได้ว่า เวิร์กบุ๊กนี้มีเซลล์ที่มีข้อมูลอยู่จริงกี่เซลล์ และรับคำตอบในราคาของการสแกนที่ไม่มีการโทรกลับ (callback) เลย ทั้ง ReadFile และ ReadStream จะส่งคืนผลรวมนั้นเป็น Int64 และหลังจากนั้น ตัวเลขเดียวกันก็จะมีให้เป็นพร็อพเพอร์ตี้ CellCount การส่งคืนค่า -1 เป็นสัญญาณว่าไฟล์ไม่สามารถเปิดได้หรือไม่ใช่แพ็กเกจ OOXML

var
  Reader: TXLSDirectReader;
  Populated: Int64;
begin
  Reader := TXLSDirectReader.Create;
  try
    // No OnCell handler: a pure populated-cell census, still near-constant memory
    Populated := Reader.ReadFile('quarterly_export.xlsx');
    if Populated < 0 then
      raise Exception.Create('Not a readable XLSX package')
    else
      Writeln(Format('%d populated cells (CellCount = %d)',
        [Populated, Reader.CellCount]));
  finally
    Reader.Free;
  end;
end;
สำหรับการสแกนเต็มรูปแบบ คุณแนบตัวจัดการและเรียก ReadFile ด้วยวิธีเดียวกันทุกประการ ความแตกต่างจากการโหลดเต็มรูปแบบคือประเด็นสำคัญ: ในขณะที่การโหลด quarterly_export.xlsx ลงในเวิร์กบุ๊กจะขยายเซลล์ทุกเซลล์ให้กลายเป็นออบเจ็กต์ในหน่วยความจำและถือไว้ทั้งหมด แต่เครื่องอ่านโดยตรงเก็บเฉพาะสตริงที่แชร์และตารางสไตล์เท่านั้น ในขณะที่เซลล์กว่าสิบสองล้านเซลล์ไหลผ่าน OnCell ของคุณทีละเซลล์ การคำนวณที่ทำงานต่อเซลล์ไม่ได้ทิ้งอะไรไว้เบื้องหลัง ดังนั้นหน่วยความจำสูงสุดจึงถูกกำหนดโดยจำนวนสตริงที่แตกต่างกันของเวิร์กบุ๊ก ไม่ใช่จำนวนแถว
เครื่องอ่านโดยตรงเป็นเครื่องมือที่เหมาะสมเมื่อหน้าที่คือการอ่านเวิร์กบุ๊กขนาดใหญ่เพียงครั้งเดียวแล้วคัดลอกหรือสรุป แต่เมื่อคุณต้องการการเข้าถึงแบบสุ่มของโมเดลเต็มรูปแบบแทน แต่ต้องการให้มันทำงานได้ดีกับไฟล์ขนาดใหญ่ การปรับแต่งใน บันทึกเกี่ยวกับประสิทธิภาพของเวิร์กบุ๊กขนาดใหญ่ใน Delphi ของเราก็ครอบคลุมเส้นทางนั้น และเมื่อทิศทางสวนกลับ เป็นการสร้างเอาต์พุตขนาดใหญ่แทนการใช้งานมัน การอธิบายการเขียนแบบสตรีมมิ่งสำหรับงานแบทช์ของเซิร์ฟเวอร์ ก็ใช้ระเบียบวินัยเรื่องหน่วยความจำคงที่แบบเดียวกันกับการเขียน ทั้งสามส่วนนี้มีจัดส่งให้โดยเป็นส่วนหนึ่งของ HotXLS Delphi Component สำหรับ Delphi และ C++Builder ควบคู่ไปกับ API การอ่าน การเขียน สูตร และการจัดรูปแบบที่ครอบคลุมในส่วนอื่นๆ ของบล็อกนี้
