สมมติว่าบริการ Delphi ที่รันทุกคืนสร้างไฟล์ XLSX หนึ่งไฟล์ต่อลูกค้าหนึ่งราย รวมหลายร้อยไฟล์ บางไฟล์กว้างถึง 400,000 แถว พอ profile ดูแล้ว สิ่งที่น่าประหลาดใจแทบไม่ใช่ loop เติมเซลล์เลย แต่เป็นการเรียก SaveAs ต่างหาก ด้วย writer เริ่มต้น worksheet แต่ละแผ่นจะถูก serialize เป็นสตริง XML ก้อนเดียวในหน่วยความจำก่อน แล้วค่อยบีบอัดสตริงนั้นเข้าไปใน zip แบบ OOXML และสำหรับ sheet ที่กว้างมาก สตริงชั่วคราวนี้อาจใหญ่กว่าตัวโมเดลเซลล์ที่มันถูกสร้างขึ้นมาจากเสียอีก ดังนั้นงานที่สร้างข้อมูลได้อย่างสบาย ๆ ที่ 800 MB จะพุ่งทะลุขีดจำกัด container 2 GB ระหว่างการ save และตัว OOM killer ก็จะไปแจ้ง bug report ตอนตีสามตอนที่ไม่มีใครเฝ้าดูอยู่ HotXLS ไลบรารีสเปรดชีตแบบ native ของ losLab สำหรับ Delphi และ C++Builder มี property ที่เล็งตรงไปที่จุดพุ่งนั้นโดยเฉพาะ: StreamingWrite รอบ ๆ มันยังมีคันโยกอีกสองตัวที่กำหนดว่า batch worker จะยังอยู่ในงบหน่วยความจำและเวลาหรือไม่ นั่นคือ callback เขียนระดับแถวและพฤติกรรมของ style pool ภายใน loop ที่รันถี่ ๆ
default save path บัฟเฟอร์อะไรไว้บ้าง และ StreamingWrite เปลี่ยนอะไรไป
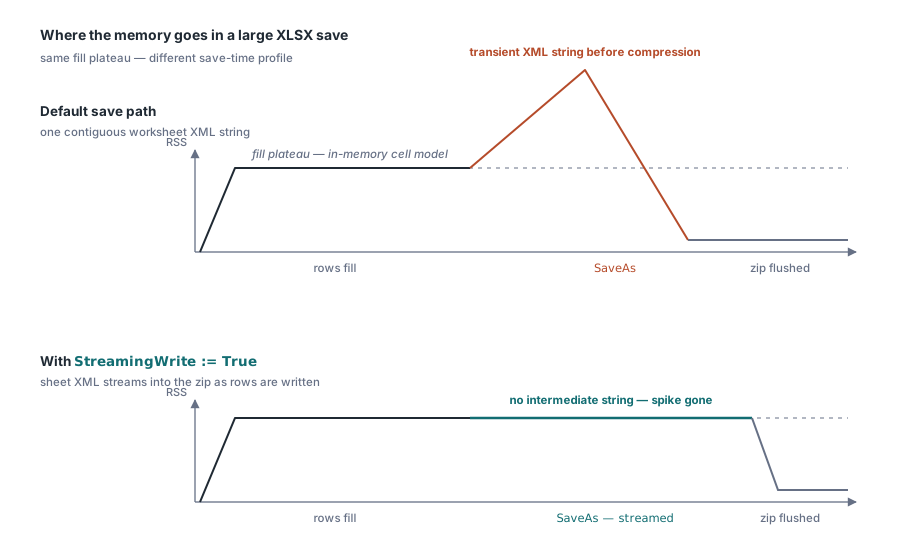
XLSX writer เริ่มต้นเลือกความเรียบง่ายเป็นหลัก มัน render XML ของ worksheet ออกมาให้ครบก่อน แล้วค่อยส่งสตริงที่เสร็จแล้วให้ตัวบีบอัด zip นี่คือการแลกเปลี่ยนที่ถูกต้องสำหรับ workbook ส่วนใหญ่อย่างท่วมท้น ที่ XML ของทั้ง sheet มีขนาดพอดีกับไม่กี่เมกะไบต์ มันเลิกถูกต้องเมื่อรูปแบบที่ serialize แล้วของ sheet เดียวพุ่งไปถึงหลายร้อยเมกะไบต์ XML ของสเปรดชีตนั้นยืดยาวมาก: ทุกเซลล์ที่เป็นตัวเลขกินอักขระ markup หลายสิบตัว และสตริงที่เก็บทั้งหมดนั้นต้องต่อเนื่องกันเป็นก้อนเดียว บนกราฟหน่วยความจำ ลายเซ็นแบบนี้พลาดดูยากมาก คือที่ราบยาว ๆ ระหว่างเติมแถว ตามด้วยจุดพุ่งเป็นรูปสามเหลี่ยมแหลม ๆ ระหว่าง SaveAs แล้วก็ยุบตัวลงเมื่อ zip ถูก flush เสร็จ
การตั้งค่า Book.StreamingWrite := True จะเปลี่ยน SaveAs ให้ใช้ worksheet writer ที่ปล่อย XML ของ sheet ตรงเข้าไปใน zip stream ทันทีที่มันถูกสร้างขึ้น สตริงกลางไม่เคยถูกจัดสรรเลย และจุดพุ่งรูปสามเหลี่ยมก็แบนราบจนกลืนไปกับ noise
ต้องพูดให้ชัดว่ามันให้อะไรกับคุณจริง ๆ เพราะถ้าโฆษณาเกินจริงจะนำไปสู่แผนความจุที่ผิดพลาด flag นี้เปลี่ยนแค่ save path เท่านั้น การสร้าง workbook ยังคงจัดสรรโมเดลเซลล์เต็มรูปแบบในหน่วยความจำเหมือนเดิม ดังนั้นที่ราบระหว่างช่วงเติมข้อมูลก็ยังสูงเท่าเดิมทุกประการ สิ่งที่หายไปคือจุดพุ่งของการ serialize ที่เคยซ้อนอยู่บนที่ราบนั้นตอน save และสำหรับงานที่เติมข้อมูล 400,000 แถว จุดพุ่งนั้นมักเป็นความต่างทั้งหมดระหว่างการอยู่ในงบหน่วยความจำกับการระเบิดออกนอกงบ property ตัวนี้มีค่าเริ่มต้นเป็น False เพื่อรักษาพฤติกรรมเดิมไว้ ดังนั้นการเปิดใช้งานจึงเป็นบรรทัดที่คุณต้องเขียนขึ้นมาเองอย่างตั้งใจ
การ export จำนวนมากเมื่อเปิด flag นี้ไว้
Book := TXLSXWorkbook.Create;
try
  BoldIdx := Book.Fonts.Add('Calibri', 11, True, False); // index ของ pool เริ่มที่ 0
  Sheet := Book.Sheets.Add('Bulk');
  for R := 1 to 100000 do
  begin
    Sheet.Cells[R, 1].Value := R;
    Sheet.Cells[R, 2].Value := 'Row ' + IntToStr(R);
    Sheet.Cells[R, 3].Value := R * 1.5;
    if (R mod 1000) = 0 then
      Sheet.Cells[R, 2].FontIndex := BoldIdx + 1;        // ที่ตัวเซลล์เริ่มที่ 1
  end;
  Book.StreamingWrite := True;   // สตรีม XML ของ sheet ตรงเข้าไปใน zip
  Book.SaveAs('bulk.xlsx');
finally
  Book.Free;
end;
Cells[R, C] สร้างเซลล์แบบ on demand ซึ่งทำให้ตัว loop สะอาดตา มีขีดจำกัดของตารางสองตัวที่ควรจำไว้: 1,048,576 แถวและ 16,384 คอลัมน์ เปิดให้เข้าถึงผ่าน XlsxMaxRow และ XlsxMaxCol ถ้าแหล่งข้อมูลไหลล้นเกินขีดจำกัดแถว โค้ดของคุณเองต้องแบ่งข้อมูลออกเป็นหลาย sheet เอง ไม่มีอะไรในขั้นตอนถัดไปจะสังเกตเห็นการล้นหรือแก้ไขให้คุณ ไฟล์จะจบลงแบบถูกตัดทอนที่ขีดจำกัดนั้นเฉย ๆ
เติมแถวโดยไม่มีต้นทุน Variant ต่อเซลล์
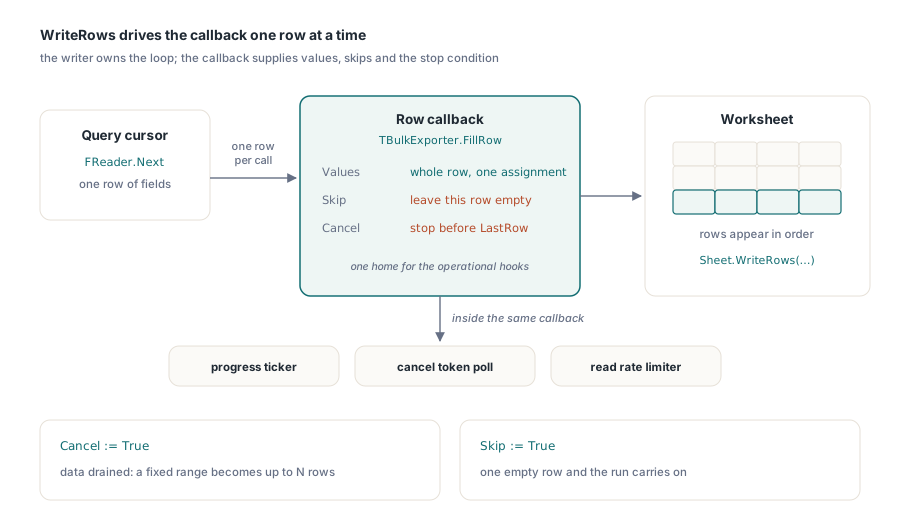
การกำหนดค่า Cells[R, C].Value ทุกครั้งต้องจ่ายต้นทุนของการค้นหาเซลล์และการแปลง Variant ที่หนึ่งหมื่นแถวไม่มีใครสังเกตเห็น แต่ที่หนึ่งล้านแถว ยี่สิบคอลัมน์ต่อแถว ต้นทุนต่อการเรียกนี้จะกลายเป็นต้นทุนหลักของช่วงเติมข้อมูล และตัว profiler ก็จะชี้ตรงไปที่จุดนั้น interface แบบ batch ให้คุณส่งข้อมูลทีละแถวทั้งแถวให้ writer แทนได้ WriteRows ขับเคลื่อนด้วย callback ที่ส่งข้อมูลมาทีละหนึ่งแถวต่อการเรียกหนึ่งครั้ง:
procedure TBulkExporter.FillRow(Sender: TObject; SheetIndex, Row, FirstCol,
  LastCol: Integer; var Values: Variant; var Skip: Boolean;
  var Cancel: Boolean);
begin
  if not FReader.Next then
  begin
    Cancel := True;              // แหล่งข้อมูลหมดแล้ว: หยุดอย่างสะอาด
    Exit;
  end;
  Values := VarArrayCreate([FirstCol, LastCol], varVariant);
  Values[FirstCol]     := FReader.RecordId;
  Values[FirstCol + 1] := FReader.CustomerName;
  Values[FirstCol + 2] := FReader.Amount;
end;

// เติมแถวที่ 2..100001 คอลัมน์ A..C โดยดึงข้อมูลจาก reader
Sheet.WriteRows(2, 1, 100001, 3, FillRow);
flag Cancel คือตัวที่เปลี่ยนช่วงแถวคงที่ให้กลายเป็น "สูงสุด N แถว" ซึ่งเป็นรูปแบบที่เป็นธรรมชาติเมื่อจำนวนแถวมาจาก query ที่ยังรันไม่เสร็จ ส่วน Skip เป็นตัวเลือกที่เบากว่า: มันปล่อยให้แถวใดแถวหนึ่งว่างเปล่าโดยไม่หยุดการรัน นอกเหนือจากการเติมเซลล์แล้ว callback ยังกลายเป็นที่อยู่ที่ดีสำหรับข้อกังวลด้านปฏิบัติการที่ปกติแล้วมักถูกยัดเข้าไปใน fill loop แบบเก้ ๆ กัง ๆ ตัวนับความคืบหน้าที่ขยับทุกพันแถว โทเค็นยกเลิกงานที่ถูก poll จาก job scheduler ตัวจำกัดอัตราการอ่านจากฐานข้อมูลต้นทาง ทั้งหมดนี้อยู่รวมกันในที่เดียว แทนที่จะถูกสอดแทรกกระจายอยู่ทั่วโค้ดเขียนเซลล์ ในฝั่งการอ่าน ForEachRow และ ForEachCell สะท้อนแพทเทิร์นเดียวกันนี้ ซึ่งสำคัญเมื่องาน batch ทั้งบริโภคและผลิตไฟล์ขนาดใหญ่
style pool ให้รางวัลกับการยก (hoist) ออกมานอก loop
โมเดลการจัดสไตล์ของ XLSX คือชุดของ pool ที่ใช้ร่วมกัน Fonts.Add, Fills.AddSolid และ Borders.Add ต่างคืนค่า index ของ pool ที่เริ่มที่ 0 ทั้งหมด และเซลล์จะอ้างอิงฟอนต์โดยเก็บ index นั้นบวกหนึ่งไว้ใน FontIndex ซึ่งค่าศูนย์ถูกสงวนไว้สำหรับค่าเริ่มต้นของ workbook ตัว +1 นั้นปรากฏอยู่ในตัวอย่างการ export จำนวนมากด้านบนพอดี ถ้าลืมมันไป เซลล์ก็จะรับสไตล์ผิดไปแบบเงียบ ๆ เพราะ index ของ style pool ที่คลาดเคลื่อนไปหนึ่งค่ายังคงเป็น index ที่ถูกต้องอยู่ดี ไม่มี error ใด ๆ โผล่ขึ้นมาเตือน
วินัยที่ตามมาคือให้สร้าง style object ทุกตัวก่อนเข้า loop แถว แล้วอ้างอิง index ของมันภายใน loop Fonts.Add จะลบความซ้ำซ้อนของนิยามที่เหมือนกันให้เอง ดังนั้นการเรียกมันครั้งเดียวต่อแถวก็แค่เปลืองซีพียูเปล่า ๆ Alignments.Add คือกับดัก เพราะมันคืนรายการใหม่ทุกครั้งที่เรียก ภายใน loop ที่มีหนึ่งแสนแถว สิ่งนี้จะฝัง styles.xml ไว้ใต้ alignment record ที่ซ้ำกันหนึ่งแสนรายการ ซึ่งทำให้ไฟล์บนดิสก์บวมขึ้นและทำให้การเปิดใน Excel ในภายหลังทุกครั้งช้าลง เพราะต้อง re-parse รายการซ้ำเหล่านั้น ให้สร้างแต่ละสไตล์เพียงครั้งเดียวนอก loop แล้วอ้างอิง index ของมันได้มากเท่าที่ต้องการ
stream ไดเรกทอรี temp และตัว batch loop ที่ครอบทุกอย่างไว้
ทั้งหมดนี้ไม่จำเป็นต้องมีไฟล์ระบบเลย facade ทั้งสองแบบมี overload แบบ TStream อยู่ทั่ว IO surface ของมัน ทั้ง Open, SaveAs, SaveAsCSV, SaveAsHTML และ SaveAsODS ก็รวมอยู่ในนั้นด้วย ดังนั้น batch worker จึง render ตรงเข้าไปใน TMemoryStream ที่มุ่งไปยัง blob storage หรือ HTTP response ได้เลยโดยไม่ต้องแตะดิสก์เลย มีจุดคมอยู่หนึ่งจุดที่ต้องจำไว้ SaveAs(Stream) เขียนจากตำแหน่งปัจจุบันของ stream และไม่ rewind ให้เองทีหลัง ดังนั้นให้ตั้ง Position := 0 เองก่อนส่ง stream ให้กับสิ่งที่จะนำมันไปส่งต่อ ไม่งั้นผู้บริโภคปลายทางจะอ่านได้ศูนย์ไบต์ facade ของ XLS เพิ่มคันโยกของตัวเองมาอีกสองตัว SetTempDir ชี้ไฟล์ temp ของ BIFF writer ไปยัง volume ที่มีทั้งพื้นที่และ IO headroom พอรองรับมันได้ ซึ่งสำคัญบนเซิร์ฟเวอร์ที่ path temp เริ่มต้นอยู่บน disk ระบบที่คับแคบ UseSharedFormulas พับตัวสูตรที่ซ้ำกันให้กลายเป็นกลุ่มที่ใช้ร่วมกัน ซึ่งลดขนาดไฟล์ได้จริงสำหรับรูปแบบรายงานคลาสสิกที่สูตรเดียวถูกคัดลอกลงไปตลอดทั้งคอลัมน์
ตัว batch loop เองก็ยังจงใจให้น่าเบื่อธรรมดา ๆ ต่อไป:
for FileName in SourceFiles do
begin
  Book := TXLSXWorkbook.Create;        // อินสแตนซ์ใหม่: ไม่มี state รั่วไหลข้ามกัน
  try
    Book.StreamingWrite := True;
    if Book.Open(FileName) <> 1 then
      Continue;                        // input ที่เสียหนึ่งตัวต้องไม่ทำให้ batch ทั้งชุดตายไปด้วย
    Book.SaveAsCSV(ChangeFileExt(FileName, '.csv'), 0, ',');
  finally
    Book.Free;
  end;
end;
การสร้างอินสแตนซ์ workbook ใหม่ต่อไฟล์มีต้นทุนแค่ไมโครวินาที และกำจัดบั๊กประเภทการปนเปื้อนข้ามไฟล์ไปทั้งหมวดหมู่: style, defined name และ document property จากไฟล์ที่ 17 ไม่มีทางรั่วไหลไปยังไฟล์ที่ 18 ได้เลย การ skip-and-continue เมื่อ Open ล้มเหลวก็คุ้มค่าไม่แพ้กัน เพราะไฟล์อัปโหลดที่เสียหนึ่งไฟล์ในชุด 600 ไฟล์ควรมีต้นทุนแค่บรรทัด log บรรทัดเดียว ไม่ใช่ทำให้การรันที่เหลือทั้งหมดพังไปด้วย สิ่งที่ควรพูดถึงด้วยคือสิ่งที่ขา CSV จงใจไม่ทำ SaveAsCSV เขียนสูตรออกมาเป็นข้อความตัวอักษรล้วน ๆ และไม่เคยประเมินค่าเลย ดังนั้น batch การแปลงที่ผู้บริโภคปลายทางคาดหวังตัวเลขที่คำนวณแล้วต้องรัน Calculate กับเซลล์ที่เกี่ยวข้องก่อน หรือไม่ก็เริ่มจาก workbook ที่มีผลลัพธ์แคชไว้จากการคำนวณครั้งก่อนอยู่แล้ว
โมเดล concurrency: หนึ่ง workbook ต่อหนึ่งเธรด
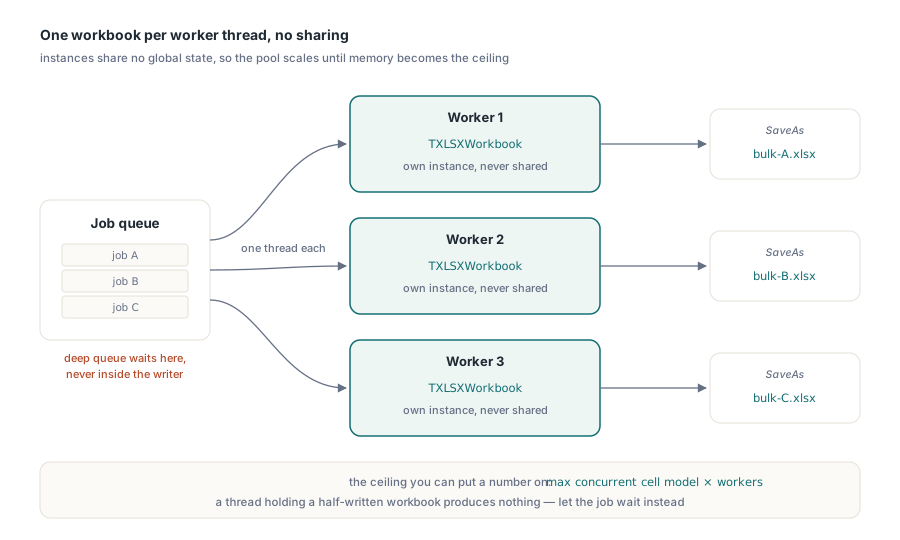
อ็อบเจ็กต์ของ facade ทั้งสองแบบไม่ thread-safe เลย และการออกแบบก็ไม่เคยแสร้งว่าเป็นอย่างอื่น เพราะไม่มี global state ที่แชร์กันระหว่างอินสแตนซ์เลย กฎการ scale จึงเรียบง่าย: หนึ่ง workbook ต่อหนึ่ง worker thread โดยไม่แชร์ workbook ข้าม thread เลย pool ของ worker จำนวน N ตัว แต่ละตัวเป็นเจ้าของ TXLSXWorkbook ของตัวเอง จะ scale ใกล้เคียงเชิงเส้นจนกว่าหน่วยความจำจะกลายเป็นเพดาน และเพดานนั้นก็เป็นตัวเลขที่คุณคำนวณได้: โมเดลเซลล์ที่ใหญ่ที่สุดที่รันพร้อมกัน คูณด้วยจำนวน worker บวกกับ overhead ตอน save ใด ๆ ที่ StreamingWrite ทำให้แบนราบไปแล้ว เมื่อคิวลึกขึ้นเรื่อย ๆ ให้ใส่ back-pressure ที่ job queue แทนที่จะใส่ไว้ข้างใน writer เธรดที่อดอยากทรัพยากรจนเขียน workbook ค้างครึ่ง ๆ กลาง ๆ ไม่ได้ผลิตอะไรที่มีประโยชน์เลย ในขณะที่งานที่รอ worker ว่างสักไม่กี่วินาทีจะเสร็จสมบูรณ์
สำหรับภาพรวมการปรับจูนที่กว้างขึ้น รวมถึง shared formula การข้ามกราฟิกฝั่งอ่าน และคันโยกเฉพาะของ XLS ดูได้ที่ คู่มือประสิทธิภาพของ workbook ขนาดใหญ่ ส่วนงาน batch ที่แถวข้อมูลมาตรงจาก query ครอบคลุมแยกไว้ต่างหากใน รูปแบบการ export จากฐานข้อมูลสำหรับรายงาน Delphi
HotXLS คอมไพล์เข้ากับบริการ Delphi หรือ C++Builder ของคุณในฐานะ Object Pascal แบบ native โดยไม่มี dependency ภายนอกเลย ส่วนรุ่นและการออกไลเซนส์อยู่ที่ หน้าผลิตภัณฑ์ HotXLS Delphi Component