HotXLS ซึ่งเป็นไลบรารี Excel แบบเนทีฟสำหรับ Delphi และ C++Builder จะวิเคราะห์แผ่นงาน XLSX บนหลายเธรดผ่านขั้นตอนการโหลดสามเฟส: ไฟล์ XML ของแผ่นงานจะถูกคลายการบีบอัดแบบอนุกรม วิเคราะห์โครงสร้างแบบขนาน และอ่านชิ้นส่วนขนาดเล็กแบบอนุกรมหลังจากนั้น ในการปล่อยฟีเจอร์นี้ครั้งแรก อัตราประสิทธิภาพเพิ่มขึ้นเพียง 12–25% เท่านั้น เนื่องจากระบบล็อกตัวจัดการหน่วยความจำเริ่มต้นของ Delphi ทำการจัดเรียงเธรดทำงานให้อยู่ในรูปแบบอนุกรม การลดการจัดสรรหน่วยความจำฮีป (heap allocation) จากประมาณ 20 ครั้งเหลือ 9.1 ครั้งต่อเซลล์ ช่วยยกระดับประสิทธิภาพความเร็วขนานให้เพิ่มขึ้นเป็น ×1.90 เท่าบนระบบแปดเธรด บทความนี้จะนำคุณไปดูรายละเอียดการวัดผล จุดที่เลือกใช้วิธีที่ผิดพลาด และการแก้ไขสองประการที่ประสบความสำเร็จในการแก้ปัญหาจริง
HotXLS วิเคราะห์แผ่นงาน XLSX แบบขนานอย่างไร?
HotXLS จะแบ่งขั้นตอน Open ออกเป็นสามเฟส และมีเพียงเฟสกลางเท่านั้นที่ทำงานบนเธรดทำงาน เหตุผลมาจากตัวคอนเทนเนอร์ zip: ไฟล์ zip ที่จัดเก็บถาวรจะเป็นสตรีมอินพุตที่แชร์กันช่องทางเดียวโดยมีเครื่องสถานะ inflate (state machine) เพียงหนึ่งชุด และเครื่องสถานะนั้นไม่สามารถถูกอ่านโดยสองเธรดพร้อมกันได้ การครอบระบบด้วยล็อกย่อมไม่มีประโยชน์ เนื่องจาก inflate เป็นการรันแบบอนุกรมโดยธรรมชาติสำหรับแต่ละข้อมูลรายการ การล็อกจึงเป็นเพียงการทำซ้ำการรันแบบอนุกรมพร้อมมีภาระแฝงเพิ่มเติม เฟส A จึงคลายการบีบอัด XML ของแต่ละแผ่นงานลงใน TMemoryStream ของตัวเองโดยยังรันแบบเธรดเดี่ยวอยู่ ซึ่งในไฟล์ทดสอบของเราใช้เวลาประมาณ 4 มิลลิวินาทีสำหรับส่วนแผ่นงานทั้งแปดส่วน จึงห่างไกลจากการเป็นคอขวด เฟส B จะรันฟังก์ชัน ParseWorksheetXml สำหรับทุกแผ่นงานบนกลุ่มเธรดทำงาน (worker pool) ซึ่งเป็นจุดที่ใช้เวลาโหลดเกือบทั้งหมด เฟส C จะย้อนกลับไปจัดการกับไฟล์ zip แบบอนุกรมสำหรับชิ้นส่วนขนาดเล็ก ได้แก่: ความคิดเห็น ภาพวาด แผนภูมิ และตาราง
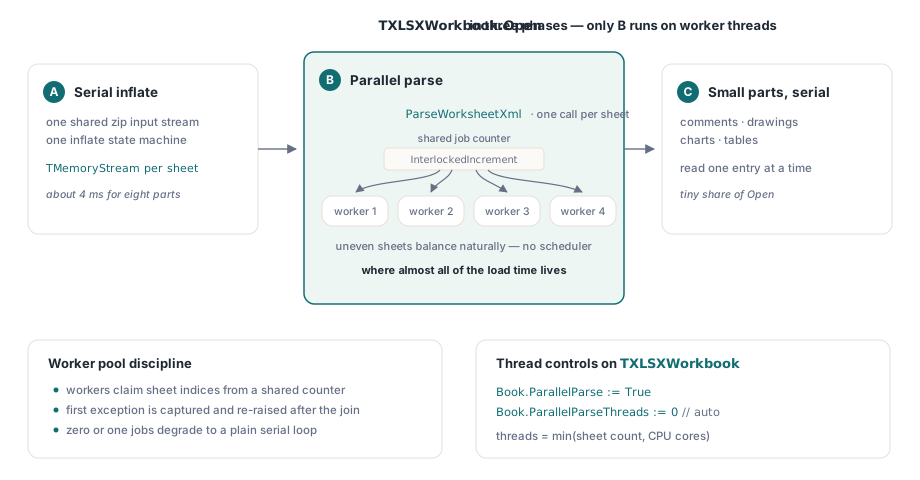
ระบบกลุ่มเธรดทำงานได้รับการออกแบบให้เรียบง่ายโดยเจตนา เธรดทำงานจะดึงข้อมูลดัชนีงานจากตัวนับที่แชร์ร่วมกันด้วยคำสั่ง InterlockedIncrement เพื่อให้แผ่นงานที่มีขนาดไม่เท่ากันสามารถจัดแบ่งงานได้อย่างเหมาะสมโดยไม่จำเป็นต้องใช้ระบบจัดกำหนดการใดๆ จำนวนเธรดจะเท่ากับ min(จำนวนแผ่นงาน, คอร์ของ CPU) ข้อยกเว้น (exception) แรกที่เกิดขึ้นในเธรดทำงานจะถูกจับข้อมูลด้วยคำสั่ง AcquireExceptionObject และส่งไปทริกเกอร์ใหม่บนเธรดหลักหลังจากจบบรรจบการรัน และตัวจัดส่งงานจะลดระดับกลับไปเป็นลูปอนุกรมทั่วไปเมื่อไม่มีงานหรือมีงานเพียงรายการเดียว มีคุณสมบัติสองประการของ TXLSXWorkbook ทำหน้าที่ควบคุมฟีเจอร์นี้: ได้แก่ ParallelParse เป็นสวิตช์เปิดปิดระบบ และ ParallelParseThreads เป็นตัวจำกัดจำนวนเธรด โดยค่า 0 หมายถึงระบบอัตโนมัติ สมุดงานที่มีหลายแผ่นงานคือรูปแบบแผ่นงานที่ได้รับประโยชน์สูงสุด รวมถึงสมุดงานประเภทที่คุณสร้างขึ้นจากการทำซ้ำแผ่นงานเทมเพลต จำนวนหลายสิบครั้ง
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // เปิดใช้งานระบบเธรดทำงานแบบขนาน
    Book.ParallelParseThreads := 0;  // 0 = อัตโนมัติ: min(แผ่นงาน, คอร์ของ CPU)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('เปิดล้มเหลว');
    // ... อ่านข้อมูลเซลล์ตามปกติ; สมุดงานได้รับการเตรียมเสร็จสมบูรณ์ ...
  finally
    Book.Free;
  end;
end;
เหตุใดการเพิ่มเธรดจึงทำให้การวิเคราะห์ XLSX ช้าลงใน Delphi?
เนื่องจากตัวจัดการหน่วยความจำเริ่มต้นของ Delphi จะคุ้มครองหน่วยความจำฮีปของมันด้วยระบบล็อกส่วนกลาง และการวิเคราะห์แผ่นงานเป็นงานที่ต้องการการจัดสรรทรัพยากรหนาแน่นมาก: ทั้งตัวเซลล์, ตัวแปร Variant และสตริง WideString นับล้านตัว เธรดทำงานทุกตัวที่ต้องเข้าถึงฮีปจะต้องต่อแถวรอล็อกนั้น ส่งผลให้เธรดที่ดูเป็นอิสระต่อกันในรหัสโปรแกรมกลับต้องประมวลผลทีละตัวสลับกันไปในการทำงานจริง การทดสอบวัดประสิทธิภาพรอบแรกของเราชี้ให้เห็นปัญหานี้อย่างชัดเจน บนสมุดงานขนาด 8 แผ่นงานซึ่งมี 5,000 แถวคูณ 4 คอลัมน์ต่อแผ่นงาน ทดสอบบน i5-11600K (6 คอร์, 12 เธรด) ภายใต้ระบบ Win64 พบว่าขั้นตอน Open แบบขนานทำประสิทธิภาพดีขึ้นเพียง 12–25% เทียบกับค่าคาดการณ์ของแผนงานที่อย่างน้อย 40% การไล่ทดสอบจำนวนเธรดที่ 2, 3, 4, 6 และ 8 เธรดแสดงกราฟที่แบนราบ และในภายหลังการวัดผลรหัสที่ควบคุม เธรดจำนวน 2 เธรดกลับทำงานช้ากว่าแบบอนุกรมถึง 26% ซึ่งเป็นพฤติกรรมดั้งเดิมของเธรดสองเธรดที่แย่งชิงล็อกเดียวกันสลับไปมา
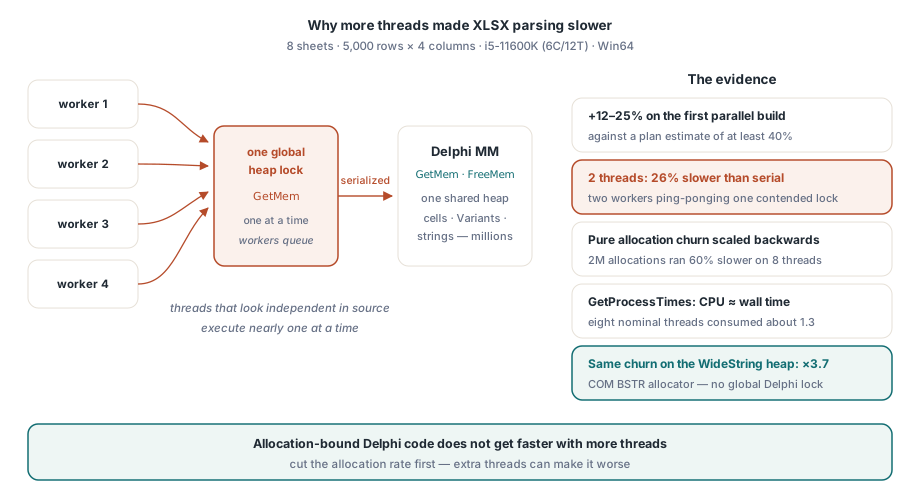
การวัดผลสามประการช่วยให้วิเคราะห์ปัญหาได้แม่นยำ และแต่ละตัวก็ล้มล้างความเข้าใจแรกเริ่มไปจนหมดสิ้น ประการแรก ไฟล์ขนาดเล็กมาก (8 แผ่นงาน แผ่นงานละ 1 แถว) เปิดในเวลา 1.2 มิลลิวินาที พิสูจน์ให้เห็นว่าขั้นตอนการวิเคราะห์เป็นแกนหลัก 100% ของฟังก์ชัน Open และไม่มีต้นทุนเวลาคงที่ที่ซ่อนอยู่อื่น ประการที่สอง การทดสอบระดับย่อยของระบบสลับสับเปลี่ยนหน่วยความจำแสดงให้เห็นว่าตัวจัดการหน่วยความจำของ Delphi มีประสิทธิภาพลดลงเมื่อขยายขนาด: ปริมาณการจัดสรรออบเจกต์และ AnsiString จำนวน 2 ล้านครั้งเท่ากัน รันช้าลง 60% บนระบบ 8 เธรดเทียบกับเธรดเดี่ยว ในขณะที่การทำงานบนฮีป WideString ซึ่งใช้ COM BSTR allocator แทนตัวจัดการหน่วยความจำของ Delphi สามารถขยายประสิทธิภาพขึ้นเป็น ×3.7 เท่า การที่ HotXLS ใช้ WideString ตลอดทั้งระบบกลายเป็นเรื่องดีในท้ายที่สุด ประการที่สาม คำสั่ง GetProcessTimes แสดงให้เห็นว่าระหว่างกระบวนการ Open แบบขนาน เวลาของ CPU มีค่าใกล้เคียงกับเวลาจริงที่ผ่านไป: เธรดจำนวนแปดเธรดใช้งานกำลัง CPU ไปเพียงประมาณ 1.3 เธรดเท่านั้น เธรดทำงานไม่ได้ปั่นกำลังการประมวลผลอยู่ แต่พวกมันกำลังหลับใหลอยู่ในเส้นทางต่อแย่งล็อกของตัวจัดการหน่วยความจำ ซึ่งเป็นสถานะถูกบล็อกแทนที่จะทำงาน
บทความในทางปฏิบัติสามารถขยายขอบเขตการใช้งานได้นอกเหนือจากสเปรดชีต หากงานของ Delphi มีขั้นตอนการจัดสรรหน่วยความจำหนาแน่น การเพิ่มจำนวนเธรดจะไม่มีประโยชน์จนกว่าอัตราการขอหน่วยความจำจะลดลง และมันสามารถทำให้ผลลัพธ์แย่ลงได้ง่าย ก่อนการแก้ไขจุดนี้ เราแจ้งความจริงกับผู้ใช้ที่พยายามปรับแต่งค่า ParallelParseThreads ว่า: บนไฟล์ที่ค้างกับการขอใช้หน่วยความจำ เธรดที่เพิ่มเข้ามาแทบไม่ได้ช่วยอะไรเลย
การขอจัดสรรหน่วยความจำฮีป 20 ครั้งต่อเซลล์มาจากที่ใด?
ตัวนับครอบคลุมที่ติดตั้งด้วยคำสั่ง SetMemoryManager ตอบคำถามนั้นได้อย่างแม่นยำ: มีการจัดสรรหน่วยความจำผ่าน Delphi-MM ประมาณ 20 ครั้งต่อเซลล์ โดยจำนวน 2.87 ล้านครั้งจากทั้งหมดเป็นงานขนาด 32 ไบต์หรือต่ำกว่า ตัวการสำคัญไม่ได้มาจากตัวออบเจกต์เซลล์เลย เมธอด TXMLScaner.GetTokenValue จะสร้างตัวแปร AnsiString ใหม่ในทุกการเรียกใช้ และมันถูกเรียกใช้ประมาณ 15–20 ครั้งต่อเซลล์: เช่น สำหรับชื่ออิลีเมนต์, ชื่อแอตทริบิวต์, ค่าแอตทริบิวต์ และข้อมูลเนื้อหา นอกจากนี้ เส้นทาง UTF8ToWideString ของ RTL จะสร้างตัวแปร UnicodeString ชั่วคราวขึ้นมาคั่นในทุกการแปลงข้อมูล ออบเจกต์เซลล์คิดเป็นสัดส่วนการจัดสรรเพียง 160,000 ครั้ง หรือประมาณ 8% ของทั้งหมด ซึ่งเป็นการทำลายแผนการดั้งเดิมของเราทันที: เนื่องจากตอนแรกเราตั้งใจจะสร้างออบเจกต์พูลสำหรับเซลล์ และตัวเลขวัดผลชี้ว่ามันจะไม่มีวันให้ผลลัพธ์ที่คุ้มค่าตัว
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // การเปลี่ยนหน่วยความจำขนาดเล็กที่เราสนใจ
  Result := OldMM.GetMem(Size);
end;

// ติดตั้งก่อนกระบวนการ Open และกู้คืนภายหลัง
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
กระบวนการวิเคราะห์เวลาสิบนาทีนี้คุ้มค่าที่จะนำไปปรับใช้กับการวิเคราะห์ประสิทธิภาพของ Delphi ทั่วไป การนับจำนวนการจัดสรรตามขนาดบล็อกมีต้นทุนในการสร้างโค้ดน้อยมากและช่วยบอกคุณว่าความดันของตัวจัดการหน่วยความจำเกิดขึ้นจากที่ใด ซึ่งในกรณีของเราเกิดจากพฤติกรรมระดับ RTL สองจุดภายในตัวสแกน XML แทนที่จะเป็นสิ่งใดก็ตามในแบบจำลองออบเจกต์ ตัววิเคราะห์ประสิทธิภาพทั่วไปมักจะชี้ไปที่ตัวประเมินผลไวยากรณ์โดยรวม แต่ตัวนับของเราชี้ไปที่บรรทัดของรหัสโปรแกรมเฉพาะสองบรรทัด
การแก้ไข: การใช้ Token Interning และตัวแปลงรหัส UTF-8 แบบไม่มีตัวแปรกลาง
การเปลี่ยนแปลงที่กำหนดเป้าหมายสองประการในตัวอ่าน XML ช่วยลดการจัดสรรหน่วยความจำต่อเซลล์ลงไปได้มากกว่าครึ่งโดยไม่ต้องปรับโครงสร้างของตัววิเคราะห์ไวยากรณ์ ประการแรกคือการทำ element-name interning ไฟล์ XML ของแผ่นงานจะทำซ้ำคำศัพท์กลุ่มเล็กๆ อย่างไม่มีที่สิ้นสุด: เช่น row, c, v, r, t, s และชื่อคุณลักษณะอีกไม่กี่ชื่อ เมธอด InternTokenName จะเก็บแคชขนาด 64 ช่องสำหรับชื่อที่เคยพบก่อนหน้า และเปรียบเทียบบัฟเฟอร์ของตัวสแกนกับรายการในแคชด้วยฟังก์ชัน TokenEqualsAnsi ซึ่งเป็นการเปรียบเทียบไบต์โดยตรงที่ไม่มีการขอจัดสรรหน่วยความจำเพิ่ม เมื่อข้อมูลตรงกัน มันจะส่งกลับตัวแปร AnsiString ในแคช และตรงนี้ประเภทข้อมูลมีความสำคัญมาก: AnsiString จะใช้ระบบนับจำนวนอ้างอิง (reference counted) การส่งกลับอินสแตนซ์ในแคชจึงมีค่าใช้จ่ายเพียงการเพิ่มตัวนับอ้างอิง (refcount) และไม่มีการยุ่งเกี่ยวกับฮีป ส่วน WideString ไม่มีตัวนับอ้างอิง และทุกการมอบหมายค่าจะต้องผ่านคำสั่ง SysAllocString การทำ interning บน WideString จึงไม่ได้ช่วยประหยัดทรัพยากรใดๆ การทำ interning จึงคุ้มค่าเมื่อทำบนประเภทสตริงที่มีระบบนับการอ้างอิงเท่านั้น
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // เพิ่มค่า refcount เท่านั้น ไม่มีการจัดสรรหน่วยความจำ
  else
  begin
    Result := GetTokenValue;        // จัดเตรียมข้อมูลครั้งเดียว จากนั้นบันทึกในแคช
    FInternNames[Slot] := Result;
  end;
end;
การเปลี่ยนแปลงประการที่สองมุ่งปรับปรุงข้อมูลข้อความของเซลล์ เส้นทางเดิมจะสร้างโทเค็น AnsiString ส่งต่อไปยังฟังก์ชัน UTF8ToWideString ซึ่งจะสร้างตัวแปร UnicodeString ขั้นกลางขึ้นมา ก่อนจะถูกแปลงเป็น WideString เพื่อจัดเก็บลงในเซลล์: ทำให้มีการจัดสรรหน่วยความจำผ่าน Delphi-MM สองครั้งต่อหนึ่งข้อความก่อนที่จะสร้างคีย์จริง เส้นทางใหม่คือคำสั่ง XmlUtf8ToWide(TokenPtr, TokenLen) ซึ่งเป็นตัวถอดรหัส UTF-8 ภาษา Pascal แท้แบบกวาดสองรอบที่อ่านข้อมูลจากบัฟเฟอร์สแกนโดยตรง: รอบแรกจะวัดความยาว UTF-16 และรอบที่สองจะถอดรหัสลงใน WideString ที่ขอจัดสรรหน่วยความจำเพียงครั้งเดียว ต้นทุนสุทธิต่อโทเค็นข้อความคือ: มีการจัดสรร COM หนึ่งครั้ง และไม่มีการขอจัดสรรหน่วยความจำผ่าน Delphi-MM เลย ประเด็นเชิงตรรกะสำหรับผู้ที่ระมัดระวังคือ: ในกรณีที่พบข้อมูลซีเควนซ์ UTF-8 ที่ผิดรูปแบบ ตัวแปลงรหัสตัวใหม่จะปล่อยข้อมูลไบต์ผ่านไปเลยแทนการใส่ตัวอักษรแทนที่อย่างที่ RTL ทำ ซึ่งส่งผลเฉพาะกับรูปแบบการแจ้งเตือนเมื่อไฟล์ชำรุด แต่บนข้อมูลขาเข้าที่ถูกต้อง ผลลัพธ์เอาต์พุตจะมีค่าไบต์ตรงกันทุกประการ ส่วนอักขระพิเศษ (character entities) ของ XML จะไม่มีวันส่งมาถึงตัวแปลงรหัสนี้ เนื่องจากตัวสแกนได้แปลงพวกมันเป็น UTF-8 ในบัฟเฟอร์โทเค็นเรียบร้อยแล้ว
สิ่งที่ได้รับ และจุดที่การวิเคราะห์แบบขนานยังช่วยไม่ได้
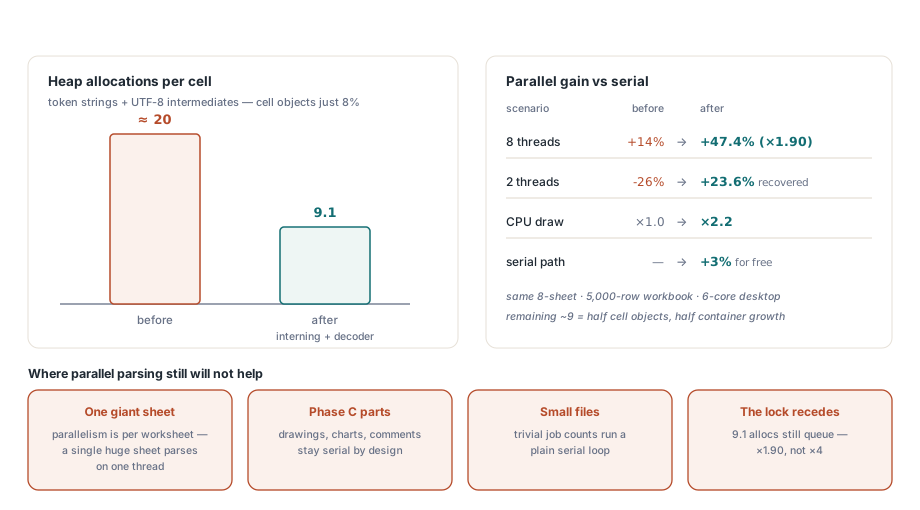
การแก้ไขสองประการช่วยลดปริมาณการจัดสรรต่อเซลล์จากประมาณ 20 ครั้งเหลือ 9.1 ครั้ง และตัวเลขประสิทธิภาพแบบขนานขยับขึ้นตามทฤษฎีที่ควรจะเป็น บนระบบ 8 แผ่นงาน 5,000 แถว และบนเครื่อง 6C12T เครื่องเดิม ประสิทธิภาพการรันแบบ 8 เธรดเพิ่มจาก 14% เป็น 47.4% หรือคิดเป็นความเร็วเพิ่มขึ้น ×1.90 เท่าเมื่อเทียบกับการรันแบบอนุกรม ในกรณีของ 2 เธรดเปลี่ยนจากช้ากว่าเดิม 26% เป็นเร็วขึ้น 23.6% และค่าการใช้งาน CPU เพิ่มขึ้นจาก ×1.0 เป็น ×2.2 เส้นทางการรันแบบอนุกรมยังเร็วขึ้นอีกประมาณ 3% เป็นของแถมเนื่องจากการจัดสรรหน่วยความจำที่ลดลงช่วยการทำงานของเธรดเดี่ยวด้วยเช่นกัน การจัดสรรที่เหลือประมาณ 9 ครั้งต่อเซลล์ประกอบด้วยออบเจกต์เซลล์ประมาณครึ่งหนึ่งและพื้นที่การขยายของคอนเทนเนอร์อีกครึ่งหนึ่ง เราวัดผลเหล่านี้แล้วประเมินว่าอัตราผลตอบแทนที่จะได้รับลดลงจึงตัดสินใจหยุดการพัฒนาต่อ โดยมีตัวครอบ MM ที่พร้อมสำหรับการใช้วัดผลอีกครั้งหากงานในอนาคตจำเป็นต้องทำเพิ่ม
ขอบเขตการทำงานเป็นสิ่งที่คุณควรระบุให้ชัดเจนเช่นเดียวกับความสำเร็จ HotXLS จะจัดการงานขนานในระดับแผ่นงาน (worksheet granularity) ดังนั้นสมุดงานที่มีแผ่นงานขนาดใหญ่เพียงแผ่นเดียวจะถูกวิเคราะห์ด้วยเธรดเดียวโดยไม่สนใจค่าที่ตั้งไว้ใน ParallelParseThreads สำหรับรูปแบบนั้น ตัวอ่านสตรีมตรง (streaming direct reader) จะเป็นเครื่องมือที่ดีกว่า เนื่องจากมันหลีกเลี่ยงกระบวนการเตรียมโครงสร้างสมุดงานทั้งหมดตั้งแต่แรก ไฟล์ที่ใช้เวลากับชิ้นส่วนเฟส C เป็นหลัก เช่น ภาพวาด แผนภูมิ และความคิดเห็น จะไม่ได้รับประโยชน์เท่าใดนักเนื่องจากเฟสนี้ทำงานแบบอนุกรมตามการออกแบบ ไฟล์ขนาดเล็กไม่ควรค่าแก่การรันระบบเธรดเลย ซึ่งเป็นเหตุผลว่าทำไมตัวจัดส่งงานจึงรันระบบอนุกรมเงียบๆ เมื่อพบจำนวนงานน้อย และเพดานของตัวจัดการหน่วยความจำไม่ได้หายไปไหน เพียงแต่ถูกผลักออกไป: ที่การจัดสรร 9.1 ครั้งต่อเซลล์ ระบบล็อกส่วนกลางยังคงลดทอนประสิทธิภาพของเธรดทำงาน ซึ่งเป็นเหตุผลว่าทำไมระบบแปดเธรดจึงให้ผลลัพธ์เป็น ×1.90 เท่าแทนที่จะเป็น ×4 เท่า สำหรับชุดเครื่องมืออื่นๆ ในการลดเวลาโหลดและบันทึกข้อมูล รวมถึงสไตล์ พูล และระบบคอลแบ็กแบบกลุ่ม สามารถศึกษาเพิ่มเติมได้จากบทความเกี่ยวกับประสิทธิภาพของสมุดงานขนาดใหญ่ใน Delphi
การวิเคราะห์ XLSX แบบขนาน, คุณสมบัติ ParallelParse และ ParallelParseThreads รวมถึงตัวอ่าน XML ที่ลดการจัดสรรหน่วยความจำที่อธิบายไว้ในบทความนี้ จัดส่งมาเป็นชิ้นส่วนมาตรฐานของคอมโพเนนต์ HotXLS Delphi Excel Component ซึ่งอ่านและเขียนไฟล์ XLS, XLSX และ ODS แบบเนทีฟจาก Delphi และ C++Builder โดยไม่มีความจำเป็นต้องทำงานร่วมกับระบบอัตโนมัติของ Excel