HotPDF โหลด PDF จากแหล่งข้อมูลแบบเข้าถึงสุ่มใดก็ตามที่คุณสร้างขึ้นเอง และ THPDFCoalescingRandomAccessSource จะห่อหุ้มแหล่งข้อมูลนั้นไว้ เพื่อให้การอ่านเล็ก ๆ ที่กระจัดกระจายของตัวแยกวิเคราะห์กลายเป็นชุดช่วงบล็อกที่แคชไว้แบบมีขอบเขต พร้อมการดึงข้อมูลล่วงหน้าแบบอะซิงโครนัส บนเอกสารที่ให้บริการผ่านคำขอ HTTP range นี่คือความต่างระหว่างการเดินทางไปกลับหลายร้อยครั้งกับเพียงไม่กี่สิบครั้ง
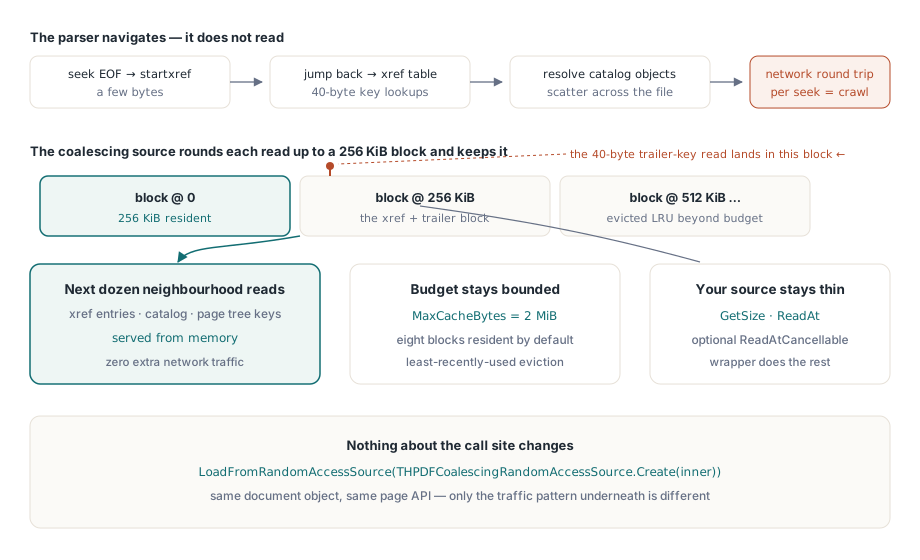
ไม่มีอะไรในตัวแยกวิเคราะห์เปลี่ยนแปลงเลย คุณยังคงเรียก LoadFromRandomAccessSource เหมือนเดิม ได้อ็อบเจกต์เอกสารเดิมกลับมา และ API ของหน้าก็ทำงานเหมือนเดิม สิ่งที่เปลี่ยนคือการรับส่งข้อมูลที่อยู่เบื้องล่าง
เหตุใด PDF เดียวกันจึงโหลดได้ทันทีเมื่ออยู่ในเครื่อง แต่คลานช้าผ่านเครือข่าย
เพราะตัวแยกวิเคราะห์ PDF ไม่ได้แค่อ่านไฟล์ มันนำทางไปในไฟล์ต่างหาก มันจะเลื่อนไปยังท้ายไฟล์เพื่อหา startxref กระโดดกลับไปที่ตารางอ้างอิงไขว้ แก้ดิกชันนารี trailer ตามการอ้างอิงไปยัง Catalog แล้วไปยังรากของต้นไม้หน้า แล้วไปยังโหนดหน้า แล้วไปยังดิกชันนารีทรัพยากรของมัน แต่ละขั้นตอนเหล่านี้อ่านข้อมูลไม่กี่สิบไบต์จากตำแหน่งที่ต่างกัน
บนไฟล์ในเครื่อง รูปแบบแบบนี้แทบไม่มีต้นทุนเลย เพราะระบบปฏิบัติการมีหน้า 4 KiB โดยรอบแคชไว้อยู่แล้ว ทำให้การอ่านครั้งที่สองมีต้นทุนแค่การทำ memcpy แต่บนการขนส่งผ่านเครือข่ายไม่มีความใกล้เคียงกันแบบนั้น การอ่านแต่ละครั้งคือคำขอที่มีเวลาแฝงของตัวเอง และคำขอตามลำดับ 300 ครั้งที่ 40 มิลลิวินาทีต่อครั้ง กินเวลาสิบสองวินาทีซึ่งเกือบทั้งหมดใช้ไปกับการรอ ทางแก้ไม่ใช่การอ่านให้น้อยลง เพราะตัวแยกวิเคราะห์ต้องการข้อมูลตามที่ขอไว้พอดี แต่ทางแก้คือทำให้การอ่านทางกายภาพแต่ละครั้งครอบคลุมสิ่งที่การอ่านเชิงตรรกะครั้งถัดไปต้องการมากขึ้น
การรวมช่วงข้อมูลเปลี่ยนอะไร
แหล่งข้อมูลแบบรวมช่วงจะปัดการอ่านทุกครั้งขึ้นไปเป็นหนึ่งบล็อกและแคชบล็อกนั้นไว้ BlockSize มีค่าเริ่มต้น 262,144 ไบต์ และ MaxCacheBytes มีค่าเริ่มต้น 2,097,152 ไบต์ ดังนั้นโดยค่าเริ่มต้นจะมีแปดบล็อกอยู่ในหน่วยความจำ และถูกไล่ออกตามลำดับที่ใช้งานล่าสุดน้อยที่สุด เทียบกับงบประมาณไบต์ที่ตายตัว การอ่าน 40 ไบต์ของคีย์ trailer โดยตัวแยกวิเคราะห์จะดึง 256 KiB โดยรอบเข้ามาด้วย และการอ่านอีกสิบกว่าครั้งถัดไปในบริเวณใกล้เคียงนั้น ซึ่งเป็นที่ที่ข้อมูลอ้างอิงไขว้และ catalog อาศัยอยู่ จะถูกให้บริการจากหน่วยความจำ
แหล่งข้อมูลของคุณเองยังคงเรียบง่าย ให้สร้าง GetSize และ ReadAt แล้วโอเวอร์ไรด์ ReadAtCancellable ถ้าการขนส่งของคุณสามารถยกเลิกระหว่างทางได้ แล้วปล่อยให้ตัวห่อหุ้มจัดการการแคช การรวมช่วง และการดึงข้อมูลล่วงหน้าแทน
type
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True: ตัวห่อหุ้มจะปล่อย Raw ไปพร้อมกับตัวมันเอง
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Pdf := THotPDF.Create(nil);
  try
    Cached.AsyncPrefetchEnabled := True;
    Cached.AdaptiveReadAheadEnabled := True;
    Cached.MaxReadAheadBlocks := 8;

    if Pdf.LoadFromRandomAccessSource(Cached, True) = 1 then
      RenderFirstPage(Pdf);
  finally
    Pdf.Free;
  end;
end;
ควรอ่านล่วงหน้าไปไกลแค่ไหน
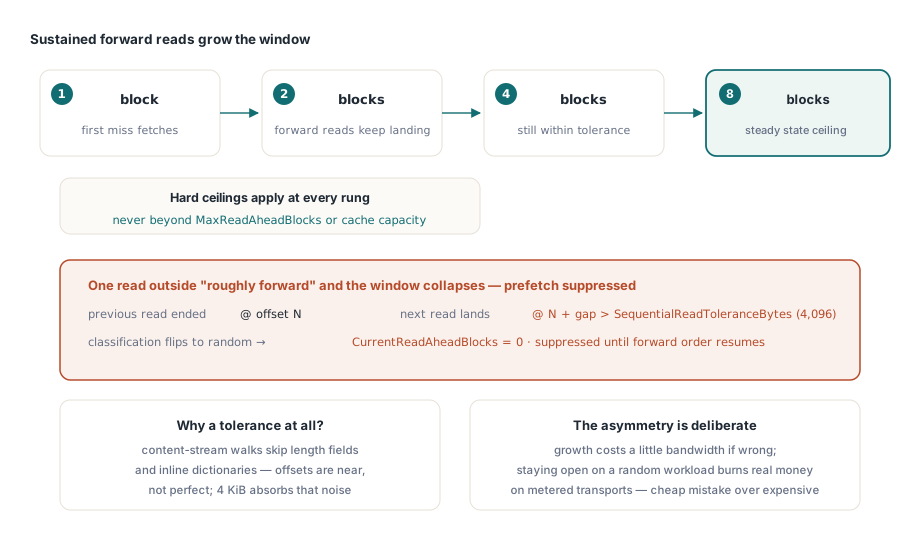
การอ่านล่วงหน้าแบบปรับตัวตอบคำถามนี้แยกตามเอกสารแต่ละไฟล์ แทนที่จะบังคับให้คุณเดา เมื่อตั้งค่า AdaptiveReadAheadEnabled ไว้ หน้าต่างการอ่านจะเติบโตผ่าน 1, 2, 4 และ 8 บล็อก ตามจำนวนการอ่านไปข้างหน้าอย่างต่อเนื่องที่สะสมไว้ และจะไม่เกิน MaxReadAheadBlocks หรือความจุแคชที่กำหนดไว้ ทันทีที่มีการอ่านที่ไม่ได้อยู่ในตำแหน่งใกล้เคียงกับจุดสิ้นสุดของการอ่านครั้งก่อน หน้าต่างจะยุบตัวลงและการดึงข้อมูลล่วงหน้าจะถูกระงับ
SequentialReadToleranceBytes ซึ่งมีค่าเริ่มต้น 4,096 คือตัวกำหนดความหมายของคำว่า “ใกล้เคียง” นี้ การอ่านที่อยู่ในระยะนั้นจากจุดสิ้นสุดของการอ่านครั้งก่อนยังคงนับเป็นการอ่านต่อเนื่อง ซึ่งสำคัญเพราะตัวแยกวิเคราะห์ PDF ที่เดินผ่านคอนเทนต์สตรีมไม่ได้สร้างออฟเซ็ตที่ต่อเนื่องกันสมบูรณ์แบบ มันข้ามฟิลด์ความยาวตรงนี้บ้าง ดิกชันนารีแบบอินไลน์ตรงนั้นบ้าง ถ้าตั้งค่าความคลาดเคลื่อนต่ำเกินไป การสแกนไปข้างหน้าตามปกติจะถูกจัดว่าเป็นการอ่านแบบสุ่ม ทำให้การอ่านล่วงหน้าไม่ทำงานเลย ถ้าตั้งค่าสูงเกินไป การเข้าถึงแบบสุ่มจริง ๆ จะดูเหมือนต่อเนื่อง ทำให้คุณดึงข้อมูลหลายเมกะไบต์ที่ไม่มีใครต้องการมา ค่าเริ่มต้นถูกปรับเทียบไว้สำหรับการเดินผ่านคอนเทนต์สตรีม และสถิติจะบอกคุณเองถ้าการขนส่งของคุณไม่สอดคล้องกัน
ความไม่สมมาตรนี้เป็นความตั้งใจ: การเติบโตเป็นไปอย่างค่อยเป็นค่อยไป แต่การยุบตัวเกิดขึ้นทันที การดึงข้อมูลเกินความจำเป็นบนภาระงานแบบเข้าถึงสุ่มมีต้นทุนแบนด์วิดท์และเงินจริงบนการขนส่งแบบคิดตามปริมาณการใช้งาน จึงเลือกความผิดพลาดที่ถูกกว่าดีกว่าความผิดพลาดที่แพงกว่า
การยกเลิกที่หยุดการถ่ายโอนได้จริง
คลาสฐานประกาศ ReadAtCancellable ไว้ และแหล่งข้อมูลแบบรวมช่วงก็เคารพมันตลอดทั้งกระบวนการ เมื่อการอ่านแบบ foreground มาถึงสำหรับช่วงที่การดึงข้อมูลล่วงหน้าที่กำลังทำงานอยู่ไม่ได้ให้บริการ การดึงข้อมูลล่วงหน้านั้นจะถูกยกเลิกแทนที่จะปล่อยให้ทำต่อจนจบ ทำให้คำขอหน้าของผู้ใช้ไม่ต้องรอต่อคิวหลังการรับส่งข้อมูลแบบเก็งกำไร การใช้งานเริ่มต้นบน THPDFRandomAccessSource จะถอยกลับไปใช้ ReadAt ธรรมดา ซึ่งหมายความว่าฟีเจอร์นี้เลือกใช้ได้เป็นรายการขนส่ง: ไคลเอนต์ HTTP ที่รองรับการยกเลิกคำขอจะได้การยกเลิกที่แท้จริง ส่วนแหล่งข้อมูลที่เรียบง่ายกว่าก็ยังคงทำงานได้เหมือนเดิม
รวมสิ่งนี้เข้ากับโทเคนการยกเลิกที่ร้อยผ่าน UI ของคุณ แล้วเมื่อผู้ใช้ปิดเอกสาร การรับส่งข้อมูลเครือข่ายจะหยุดจริง ๆ แทนที่จะรอให้มันระบายจนหมด โมเดลโทเคนเดียวกันนี้รองรับการจัดคิวที่อธิบายไว้ใน การเรนเดอร์เบื้องหลังพร้อมคิวคำขอ ดังนั้นโทเคนเดียวสามารถครอบคลุมเส้นทางทั้งหมดตั้งแต่วิวพอร์ตไปจนถึงซ็อกเก็ตได้
อ่านสถิติแคชช่วงข้อมูล
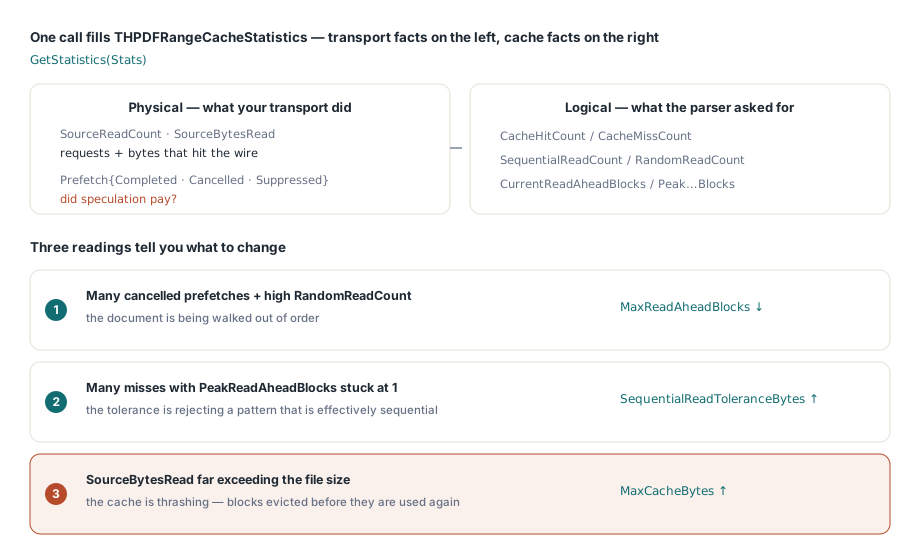
GetStatistics เติมข้อมูลลงในเรคคอร์ด THPDFRangeCacheStatistics ซึ่งแยกสิ่งที่การขนส่งของคุณทำออกจากสิ่งที่แคชทำ SourceReadCount และ SourceBytesRead คือการรับส่งข้อมูลทางกายภาพ CacheHitCount และ CacheMissCount คือการรับส่งข้อมูลเชิงตรรกะ SequentialReadCount และ RandomReadCount แสดงว่ารูปแบบการเข้าถึงถูกจัดประเภทอย่างไร CurrentReadAheadBlocks และ PeakReadAheadBlocks แสดงว่าหน้าต่างเปิดกว้างไปแค่ไหน และ PrefetchRequestCount, PrefetchCompletedCount, PrefetchCancelledCount และ SuppressedPrefetchCount แสดงว่าการเก็งกำไรคุ้มค่าหรือไม่
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d cancelled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
end;
การอ่านค่าสามชุดนี้จะบอกว่าควรเปลี่ยนอะไร การดึงข้อมูลล่วงหน้าที่ถูกยกเลิกจำนวนมากพร้อมกับจำนวนการอ่านแบบสุ่มที่สูง หมายความว่าเอกสารกำลังถูกเข้าถึงแบบไม่เป็นลำดับ ให้ลด MaxReadAheadBlocks และหยุดจ่ายค่าแบนด์วิดท์ที่คุณทิ้งไป การพลาดจำนวนมากในขณะที่หน้าต่างสูงสุดยังอยู่ที่ 1 หมายความว่าค่าความคลาดเคลื่อนกำลังปฏิเสธรูปแบบที่จริง ๆ แล้วต่อเนื่อง ให้เพิ่ม SequentialReadToleranceBytes และถ้าจำนวนไบต์ที่อ่านเกินขนาดไฟล์ไปมาก หมายความว่าแคชกำลังเกิดการเธรชชิง ให้เพิ่ม MaxCacheBytes ก่อนจะไปแตะอย่างอื่น
ไฟล์แบบ linearized เปลี่ยนสมการทั้งหมด
ถ้าคุณควบคุมผู้สร้างไฟล์ได้ การทำ linearization ให้เอกสารจะเปลี่ยนตัวปัญหาแทนที่จะแค่ปรับให้ดีขึ้น PDF แบบ linearized จะวางอ็อบเจกต์ของหน้าแรกและตาราง hint ไว้ที่ต้นไฟล์ ทำให้โปรแกรมดูสามารถเรนเดอร์หน้าแรกได้จากเมกะไบต์แรกโดยไม่ต้องเห็นส่วนที่เหลือ HotPDF เปิดเส้นทางนั้นให้ใช้งานได้โดยตรงผ่าน GetProgressiveLinearizedLoadInfo และ ReadProgressiveLinearizedFirstPageSection ส่วนฝั่งการเขียนอธิบายไว้ใน การสร้าง PDF แบบ linearized พร้อมตาราง hint
ทั้งสองเทคนิคนี้ประกอบกันได้ การรวมช่วงข้อมูลทำให้เอกสารใดก็ตามพอทนได้บนลิงก์ที่ช้า ส่วนการทำ linearization ทำให้หน้าแรกมาถึงเร็วบนเอกสารที่คุณสร้างขึ้นเอง สำหรับไฟล์ที่อยู่บนดิสก์ในเครื่องแต่ใหญ่เกินกว่าจะเก็บในหน่วยความจำได้ เส้นทางไฟล์แบบแมปและสตรีมแบบขี้เกียจที่อธิบายไว้ใน เวิร์กโฟลว์ Direct File API มักเป็นเครื่องมือที่ดีกว่า เพราะไม่มีเวลาแฝงของการเดินทางไปกลับที่ต้องเฉลี่ยตั้งแต่แรกอยู่แล้ว
HotPDF เป็นคอมโพเนนต์ VCL แบบเนทีฟสำหรับ Delphi และ C++Builder โดยไม่ต้องใช้ DLL ภายนอกสำหรับตัวแยกวิเคราะห์ และมีซอร์สโค้ดฉบับเต็มให้ใช้งาน API แหล่งข้อมูลแบบเข้าถึงสุ่ม ตัวห่อหุ้มแบบรวมช่วง และจุดเข้าใช้งานการโหลดแบบก้าวหน้า มีเอกสารอธิบายไว้ที่ หน้าคอมโพเนนต์ PDF สำหรับ Delphi ของ HotPDF