การนับจำนวนหน้าในไฟล์ archive ที่สแกนไว้ขนาด 1.4 GB ควรจะเป็นเรื่องที่ทำได้ง่ายและเบา แต่พอเรียก LoadFromFile กับไฟล์นั้น มันก็เลิกเบาทันที: HotPDF จะ parse ข้อมูล cross-reference และสร้าง object ในหน่วยความจำสำหรับ indirect object ทุกตัวจากหลายแสนตัวของเอกสาร และ worker แบบ 32 บิตจะชนเพดานพื้นที่แอดเดรส 2 GB อยู่ที่ไหนสักแห่งกลางกระบวนการ parse นั้น การทำงานที่คุณต้องการจริง ๆ คือแค่จำนวนหน้า ไม่เคยต้องการ object เหล่านั้นเลยแม้แต่ตัวเดียว มันต้องการแค่ page tree เท่านั้นไม่มีอะไรมากไปกว่านั้น ช่องว่างระหว่างสิ่งที่งานหนึ่งต้องการกับสิ่งที่ full load ส่งมอบให้ คือเหตุผลทั้งหมดที่ Direct File API มีอยู่
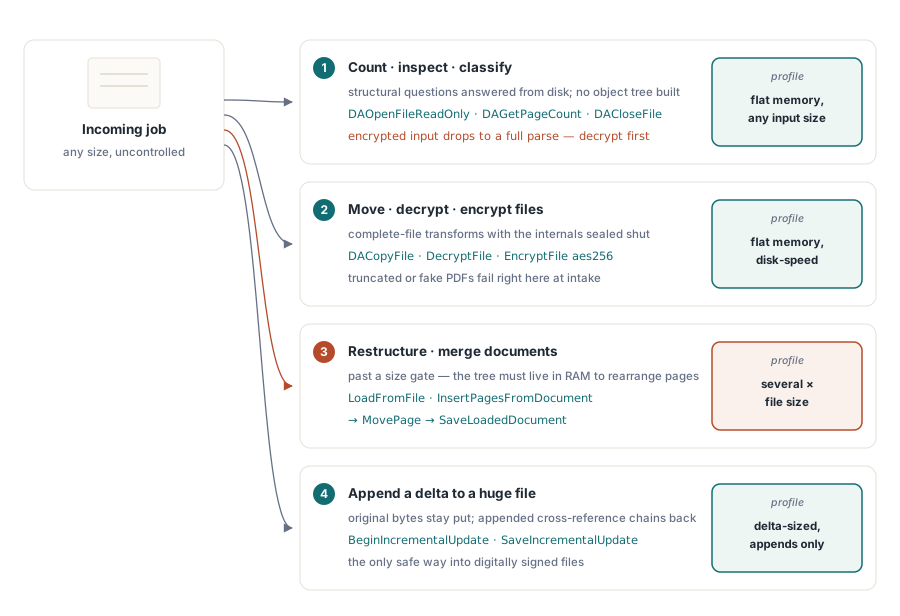
Direct File API มอบการเข้าถึง PDF ระดับไฟล์ให้กับ Delphi และ C++Builder: การนับหน้า การคัดลอก การถอดรหัส การต่อท้ายแบบ incremental ทั้งหมดนี้อ่านจากดิสก์เฉพาะสิ่งที่จำเป็นจริง ๆ แทนที่จะสร้างโมเดลเอกสารทั้งหมดขึ้นมาใหม่ในหน่วยความจำ ทักษะสำคัญคือการจับคู่แต่ละงานเข้ากับระดับที่เบาที่สุดที่ตอบโจทย์นั้นได้ จับคู่ให้ถูกต้อง แล้วบริการจะรักษาหน่วยความจำให้คงที่ไม่ว่าอินพุตจะมีขนาดเท่าใด จับคู่ผิดพลาด แล้วไฟล์ขนาดใหญ่เกินไปไฟล์แรกก็จะทำให้ worker ล่มได้ทันที
full load มีต้นทุนอะไรบ้าง
LoadFromFile ไม่ใช่ตัวร้าย มันคุ้มค่ากับหน่วยความจำที่ใช้: เมื่อ tree อยู่ในหน่วยความจำแล้ว คุณจะเข้าถึงทุกหน้าและทุก object แบบสุ่มได้ ซึ่งเป็นสิ่งที่ InsertPagesFromDocument, MovePage และการ re-serialize ผ่าน SaveLoadedDocument ต้องการพอดี ไม่มีทางลัดสำหรับการปรับโครงสร้างจริง ๆ คุณต้องถือเอกสารทั้งฉบับไว้เพื่อจัดเรียงมันใหม่
ปัญหาเริ่มขึ้นเมื่อขนาดของอินพุตไม่ได้อยู่ในการควบคุมของคุณ ไฟล์ที่ลูกค้าอัปโหลด ผลลัพธ์จากสแกนเนอร์ และ archive จากสิบปีก่อนล้วนไม่สนใจสิ่งที่ชุดข้อมูลทดสอบของคุณเคยสมมติไว้ ถ้า load ทุกอินพุตแบบไม่มีเงื่อนไข เพดานหน่วยความจำของคุณจะถูกกำหนดโดยไฟล์ที่ใหญ่ที่สุดเพียงไฟล์เดียวที่ใครสักคนจะส่งเข้ามา เวลา parse จะแปรผันตามจำนวน object และหน่วยความจำที่ค้างอยู่ในระบบจะตกลงมาอยู่ที่หลายเท่าของขนาดไฟล์เมื่อรวมโครงสร้าง object กับ stream ที่ถอดรหัสแล้ว ดังนั้นไฟล์ขนาดหนึ่งกิกะไบต์บนดิสก์อาจหมายถึงหน่วยความจำที่ค้างอยู่หลายกิกะไบต์
การ compile ใหม่ให้เป็น 64 บิตจะยกเพดานพื้นที่แอดเดรสขึ้น แต่ค่าใช้จ่ายยังคงเดิม worker ยังคงเผาผลาญ CPU หลายวินาทีและใช้หน่วยความจำหลายเท่าของขนาดไฟล์เพื่อตอบคำถามที่โครงสร้างของไฟล์เองสามารถตอบได้ภายในเสี้ยววินาที เมื่อมีการทำงานพร้อมกันหลายอย่าง คณิตศาสตร์ก็ยิ่งเลวร้ายลง: การ load ไฟล์ขนาดใหญ่สี่ครั้งพร้อมกันจะแย่งงบประมาณหน่วยความจำเดียวกัน และปริมาณงานที่ทำได้จะตกฮวบลงพอดีตอนที่คิวยาวที่สุดและคุณรับความเสี่ยงนั้นไม่ได้เลย
การอ่านไฟล์ผ่าน handle
ระดับ read-only จะเปิดไฟล์เป็น handle ตอบคำถามเชิงโครงสร้างเกี่ยวกับมัน แล้วปิดมันไป ไม่มี object tree ไม่มีการ render หน้า ไม่มีหน่วยความจำที่โตขึ้นตามขนาดอินพุต
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly('archive-2026-06.pdf', '');
    if Handle > 0 then
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      RouteByPageCount('archive-2026-06.pdf', PageCount);
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
มีสามนิสัยที่ช่วยรักษาความซื่อสัตย์ของระดับนี้ไว้ อย่างแรก ตรวจสอบค่าที่ return กลับมาเสมอ handle ที่ไม่เป็นบวกหมายถึงการเปิดล้มเหลว และการยิง DAGetPageCount ใส่ handle ที่ตายแล้วเป็นบั๊กประเภทที่จะซ่อนตัวอยู่จนกว่าวันหนึ่งที่ลูกค้าส่งไฟล์ที่ผิดรูปแบบเข้ามา อย่างที่สอง จับคู่การเปิดที่สำเร็จทุกครั้งกับ DACloseFile ไว้ภายในบล็อก finally บริการที่รั่วไหล handle จะไม่ล่มทันที แต่จะค่อย ๆ เน่าไปเรื่อย ๆ ซึ่งแย่กว่า อย่างที่สาม ต้องเข้าใจว่าพารามิเตอร์รหัสผ่านทำอะไรจริง ๆ DAOpenFileReadOnly รับพารามิเตอร์นี้ได้ แต่สำหรับอินพุตที่เข้ารหัสไว้ มันจะเงียบ ๆ ตกไปใช้ full parse เพื่ออ่านจำนวนหน้า ทำให้การรับประกันหน่วยความจำคงที่หายไป ให้ส่งไฟล์ที่มีการป้องกันผ่าน DecryptFile ก่อน แล้ว pipeline ที่เหลือก็จะยังคงเบาอยู่
การตรวจสอบแบบเดียวกันนี้ยังทำหน้าที่เป็นด่านคัดกรองได้ด้วย ไฟล์ที่ปรากฏขึ้นมาโดยติดป้ายผิด อัปโหลดมาครึ่งเดียว หรือเปลี่ยนชื่อมาจากฟอร์แมตอื่นไปเลย การตรวจสอบด้วย DAOpenFileReadOnly จะปฏิเสธทั้งหมดนี้ตั้งแต่หน้าประตูภายในเสี้ยววินาที พร้อมระบุ error ไปที่ไฟล์ที่มีปัญหาโดยตรง ทางเลือกอื่นคือปล่อยให้ไฟล์ขยะไหลลึกเข้าไปใน queue worker แล้วระเบิดที่นั่น ซึ่งการไล่หาว่าอินพุตตัวไหนเป็นต้นเหตุอาจกินเวลาไปทั้งบ่าย
การคัดลอก ถอดรหัส และเข้ารหัสไฟล์ทั้งไฟล์
ระดับที่สองจะย้ายและแปลงไฟล์ทั้งไฟล์โดยไม่เคยเปิดเผยโครงสร้างภายในเลย นี่คือชุดฟังก์ชันเรียกที่ intake pipeline พึ่งพามากที่สุด
// คัดลอกเชิงโครงสร้าง: ตรวจสอบและย้ายโดยไม่ parse object tree
Status := Pdf.DACopyFile('incoming\statement.pdf', 'verified\statement.pdf');
LogDirectFileStatus('copy', Status);

// ถอดรหัสระหว่างการคัดลอก: เส้นทาง Direct File สำหรับอินพุตที่มีการป้องกัน
Status := Pdf.DecryptFile('incoming\protected.pdf',
  'verified\plain.pdf', 'batch-password');
LogDirectFileStatus('decrypt-copy', Status);

// เข้ารหัสระหว่างการคัดลอก: ป้องกัน output โดยไม่ต้อง full load
Status := Pdf.EncryptFile('verified\statement.pdf',
  'outbound\statement.pdf', 'owner-secret', '', aes256, [prPrint]);
LogDirectFileStatus('encrypt-copy', Status);
แต่ละฟังก์ชันเรียกมีที่ทางของตัวเอง DACopyFile คือการคัดลอกแบบตรวจสอบความถูกต้องจากไดเรกทอรี quarantine ไปยัง storage ที่จัดการอยู่: มันเปิดและสร้างดัชนีโครงสร้าง PDF ไปพร้อมกัน ดังนั้นอินพุตที่ถูกตัดทอนหรือไม่ใช่ PDF จะล้มเหลวตรงจุดนี้เลย แทนที่จะไปล้มเหลวสามขั้นตอนถัดไป DecryptFile เขียนสำเนาที่ถอดรหัสแล้วผ่านเส้นทางเขียนใหม่แบบ AES-256 โดยตรง ที่ข้าม object tree ทุกครั้งที่อินพุตเอื้ออำนวย เป็นคู่หูสำหรับไฟล์ขนาดใหญ่ของขั้นตอนถอดรหัสแบบ load-and-resave ที่กล่าวถึงในบทความเรื่องการเข้ารหัส AES-256 EncryptFile ทำงานแบบเดียวกันในทิศทางกลับกัน โดยใช้การป้องกันด้วยรหัสผ่านระหว่างการคัดลอกระดับไฟล์ ด้วยพารามิเตอร์ key-type และ permission แบบเดียวกับที่เส้นทางในหน่วยความจำใช้อยู่แล้ว
การต่อท้ายการเปลี่ยนแปลงแทนการเขียนใหม่ทั้งหมด
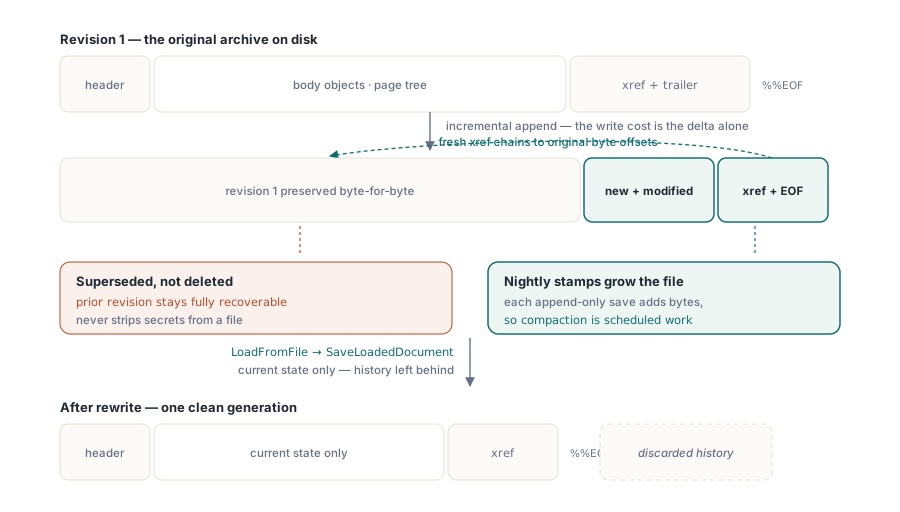
incremental update ตามที่นิยามไว้ใน ISO 32000-1 §7.5.6 คือระดับที่สาม ไบต์เดิมยังคงอยู่ที่เดิมบนดิสก์ และ object ใหม่หรือที่ถูกแก้ไขจะถูกต่อท้ายเข้าไปหลังจากนั้น ตามด้วยส่วน cross-reference ใหม่ที่เชื่อมโยงกลับไปยังไฟล์เดิม สำหรับ archive ขนาด 900 MB ที่ต้องการเพิ่มแค่หนึ่งหน้า ต้นทุนการเขียนจะเป็นแค่ส่วนต่าง ไม่ใช่ทั้งไฟล์
// ต่อท้ายหน้า audit เข้าไปใน archive ขนาดใหญ่โดยไม่ต้องเขียนใหม่ทั้งไฟล์
Pdf.BeginIncrementalUpdate('archive-2026-06.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Processed by intake service 2026-06-11');
Pdf.SaveIncrementalUpdate('archive-2026-06-stamped.pdf');  // ไบต์เดิม + ส่วนต่าง
มีวินัยสำคัญสองข้อในที่นี้ BeginIncrementalUpdate ต้องชี้ไปที่ไฟล์ต้นฉบับเสมอ เพราะข้อมูล cross-reference ที่ต่อท้ายเข้าไปจะเชื่อมโยงกลับไปยัง byte offset ภายในไฟล์นั้น และโมเดลนี้ถูกออกแบบมาให้เป็นแบบ append-only เท่านั้น: ทุกการบันทึกแบบ incremental จะทำให้ไฟล์โตขึ้น ไม่มีวันเล็กลง เอกสารที่ถูกประทับตราทุกคืนจะบวมขึ้นไม่มีที่สิ้นสุด จนกว่าจะมีการ re-serialize เป็นระยะ ๆ ด้วยการโหลดมันขึ้นมาแล้วเขียนกลับผ่าน SaveLoadedDocument ซึ่งจะบีบอัดให้เล็กลง คุณสมบัติแบบ append-only เดียวกันนี้เองที่ทำให้ incremental update เป็นวิธีเดียวที่ปลอดภัยในการแตะต้องเอกสารที่เซ็นชื่อดิจิทัลไว้ ซึ่งเป็นข้อจำกัดที่กล่าวถึงในบทความเรื่องลายเซ็นดิจิทัลและ PAdES ส่วนกลไก cross-reference ที่อยู่เบื้องหลังก็มีการอธิบายแยกไว้ในบทความเรื่อง object stream และ incremental update
มีกับดักหนึ่งในการบันทึกแบบ append-only ที่หลุดรอดสายตาการรีวิวส่วนใหญ่ไปได้ ไบต์เดิมยังคงอยู่ในไฟล์ อ่านได้สำหรับใครก็ตามที่ตั้งใจจะมองหา incremental update ที่ "แทนที่" หน้าใดหน้าหนึ่งจะไม่ลบหน้าเก่าทิ้ง มันแค่แทนที่หน้านั้นใน revision ปัจจุบัน ในขณะที่ revision ก่อนหน้ายังคงอยู่ที่นั่น กู้คืนได้เต็มรูปแบบ ดังนั้น incremental update จึงเป็นเครื่องมือที่ผิดสำหรับการลบเนื้อหาที่ละเอียดอ่อนออกไป การจะตัดประวัติที่ไม่ควรให้ผู้รับเห็นออกไปจริง ๆ คุณต้องทำ full re-serialization: LoadFromFile ตามด้วย SaveLoadedDocument ซึ่งจะเขียนเฉพาะสถานะปัจจุบันออกมาเท่านั้น และทิ้ง revision ที่ฝังอยู่ไว้เบื้องหลัง
การจับคู่ระดับให้เข้ากับการทำงาน
ตรรกะการเลือกนั้นสั้นพอที่จะจำไว้ในหัวได้ และคุ้มค่าที่จะเขียนมันออกมาเป็นการตัดสินใจ routing ที่ชัดเจนไว้ต้นสุดของ pipeline แทนที่จะปล่อยให้แต่ละงานด้นสดหาเส้นทางของตัวเอง งานที่คุณต้องการเป็นตัวกำหนดว่าจะใช้ระดับไหน:
- นับ ตรวจสอบ หรือจัดหมวดหมู่ ให้เปิด handle:
DAOpenFileReadOnly,DAGetPageCount,DACloseFile - การย้าย ถอดรหัส หรือเข้ารหัสไฟล์ทั้งไฟล์ ให้อยู่ในระดับไฟล์ด้วย
DACopyFile,DecryptFileหรือEncryptFile - การปรับโครงสร้างหน้าหรือรวมเอกสาร ต้องการ full load:
LoadFromFileจากนั้นInsertPagesFromDocumentหรือMovePageแล้วตามด้วยSaveLoadedDocument - การเพิ่มส่วนต่างเล็ก ๆ ให้กับไฟล์ขนาดใหญ่หรือไฟล์ที่เซ็นชื่อแล้ว ให้เรียก
BeginIncrementalUpdateแล้วบันทึก
pipeline ที่ผสมผสานหลายแบบทำได้ดีเมื่อวางเกณฑ์ขนาดไว้หน้าเส้นทาง full-load อะไรก็ตามที่เกินสองสามร้อยเมกะไบต์ให้ส่งผ่านระดับ Direct File และสงวน full load ไว้สำหรับการปรับโครงสร้างจริง ๆ บน worker แบบ 64 บิตที่มีงบประมาณหน่วยความจำเพียงพอ เกณฑ์นี้จะเปลี่ยนการล่มแบบ out-of-memory ให้กลายเป็นการตัดสินใจ routing ที่คุณมองเห็นและปรับแต่งได้
ไม่ว่าระดับไหนจะจัดการงานนั้น ให้เขียน output ไปยังชื่อชั่วคราวก่อน แล้วเปลี่ยนชื่อเข้าที่จริงก็ต่อเมื่อผลลัพธ์ผ่านการตรวจสอบแล้วเท่านั้น ไฟล์ที่เขียนไม่เสร็จแต่อยู่ภายใต้ชื่อสุดท้ายจะดูเหมือนไฟล์ที่ดีทุกประการสำหรับขั้นตอนถัดไปของ pipeline และฟังก์ชันเรียกของ Direct File ทำให้การตรวจสอบนี้ทำได้ง่าย: การยืนยัน output ก็แค่การตรวจ handle บรรทัดเดียว
Direct File API มาพร้อมกับHotPDF Delphi Componentสำหรับ Delphi และ C++Builder หน้าผลิตภัณฑ์มีลิงก์ไปยังเอกสารอ้างอิงฟังก์ชันฉบับเต็ม รวมถึงฟังก์ชันเรียกของ incremental-update ที่แสดงในบทความนี้