PDF 1.5 นำเสนอโครงสร้างการจัดเก็บสองแบบที่รูปแบบไฟล์รุ่นก่อนหน้าไม่มีทางแสดงออกมาได้: object stream และ cross-reference stream object stream คือ container ที่บีบอัดด้วย Flate หนึ่งชิ้น ติดแท็ก /Type /ObjStm ที่บรรจุ indirect object ขนาดเล็กจำนวนมากอัดเรียงต่อกันแทนที่จะกระจายไว้ทั่วเนื้อไฟล์ cross-reference stream คือตารางค้นหาของไฟล์ที่ถูกเขียนใหม่เป็นไบนารีบีบอัดที่มีฟิลด์ความกว้างแปรผัน แทนที่ตาราง ASCII ความกว้างคงที่ที่ปิดท้าย PDF ทุกไฟล์จนถึงเวอร์ชัน 1.4 ทั้งสองอย่างนี้เดินทางไปด้วยกันเสมอ เมื่อ object ถูกพับเข้าไปใน stream แล้ว ตารางข้อความแบบเดิมจะไม่สามารถอ้างอิงถึงมันได้อีกต่อไป ดังนั้น xref แบบไบนารีจึงต้องมาด้วยกันเสมอ
เทียบกับ layout แบบคลาสสิกแล้ว ต้นทุนที่มันตัดออกไปนั้นเห็นได้ชัดเจน ในไฟล์ PDF 1.4 indirect object ทุกตัวจะอยู่แบบไม่บีบอัดหลัง header obj ของตัวเอง และตารางที่ท้ายไฟล์ใช้พื้นที่ ASCII 20 ไบต์ต่อหนึ่งรายการพอดี ห้ามบีบอัดโดยเด็ดขาด เอกสารที่มี 200,000 object จะแบกข้อมูล cross-reference ไว้ราว 4 MB ก่อนที่จะวาด glyph แม้แต่ตัวเดียว บวกกับเนื้อหา dictionary ที่ไม่บีบอัดทั้งหมดซ้อนอยู่ด้านบนอีก PDF 1.5 จัดการทั้งสองตัวเลขนี้พร้อมกัน: dictionary จะถูกพับเข้าไปใน container แบบ Flate และตารางขนาด 4 MB จะหดเหลือแค่ไม่กี่ร้อยกิโลไบต์ในรูปแบบไบนารี ISO 32000-1 นิยามโครงสร้างทั้งสองแบบไว้ใน §7.5.7 และ §7.5.8
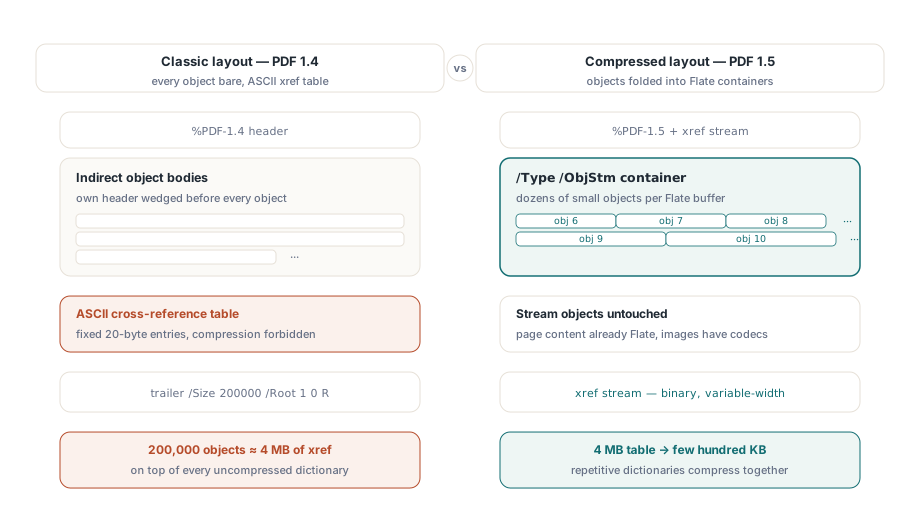
ที่ที่การประหยัดพื้นที่เกิดขึ้นจริง
object stream แตะแค่ object ที่ไม่ใช่ stream เท่านั้น ดังนั้นมันจึงบีบอัดโครงสร้าง ไม่ใช่พิกเซล เนื้อหาของหน้าถูกบีบอัดด้วย Flate มาตั้งแต่ก่อน 1.5 อยู่แล้ว และข้อมูลรูปภาพก็มี codec เป็นของตัวเอง นี่คือเหตุผลที่โบรชัวร์ที่เต็มไปด้วยรูปภาพแทบไม่ขยับขนาดเลย ไฟล์ที่ยุบตัวลงมากคือไฟล์ที่หนักไปทางโครงสร้าง: AcroForm ที่มี field dictionary นับพัน outline tree ที่ลึกมาก element โครงสร้างของ tagged-PDF object เหล่านี้มีขนาดเล็ก มีจำนวนมาก และเกือบจะเหมือนกันทุกตัว และความซ้ำซ้อนนี้เองที่ Flate ใช้ประโยชน์ได้เต็มที่ทันทีที่มันอยู่ในบัฟเฟอร์เดียวกัน แทนที่จะกระจายอยู่ทั่วเนื้อไฟล์โดยมี header คั่นอยู่ระหว่างกลาง
เป็นเรื่องง่ายที่จะประเมินต่ำไปว่าไฟล์เก่ามี overhead มากแค่ไหน archive ของฟอร์มที่ผ่านการแก้ไขมาหลายปีอาจใช้ไบต์มากกว่าครึ่งไปกับ dictionary header, xref padding และ revision ที่ไม่มีผู้อ่านคนไหนจะเปิดดูเลย ฟีเจอร์ทั้งสองในบทความนี้เรียกคืนพื้นที่สองอย่างแรกกลับมาได้ ส่วนอย่างที่สาม คือ revision ที่สะสมไว้ จะยอมแพ้ให้กับการบีบอัดก็ต่อเมื่อไฟล์ไม่ต้องจดจำประวัติของตัวเองอีกต่อไปเท่านั้น
ใน HotPDF คุณเปิดทั้งสองอย่างผ่าน property คู่หนึ่ง และการที่มันพึ่งพากันสำคัญกว่าลำดับที่คุณเขียนมันเสียอีก:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'catalog-2026.pdf';
    Pdf.UseXRefStream := True;      // xref แบบไบนารี เป็นข้อกำหนดเบื้องต้นของ ObjStm
    Pdf.UseObjectStreams := True;   // อัด object เข้าไปใน /Type /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 11);
    Pdf.CurrentPage.TextOut(50, 760, 0, 'Compressed structure demo');
    Pdf.EndDoc;                     // สร้าง container ของ XRefStm + ObjStm ออกมา
  finally
    Pdf.Free;
  end;
end;
UseObjectStreams ต้องการให้ UseXRefStream ถูกตั้งเป็น True object ที่ถูกบีบอัดจะถูกเข้าถึงผ่านรายการ xref แบบ type-2 ซึ่งบันทึกหมายเลข object-stream บวกกับ index ไว้ และแถวข้อความแบบคลาสสิกขนาด 20 ไบต์ก็ไม่มีที่ให้เก็บคู่ค่านี้ ดังนั้น UseObjectStreams เพียงลำพังจะไม่ทำอะไรที่มองเห็นได้เลย ต้องตั้งทั้งสอง flag ก่อน BeginDoc จึงจะเป็นการตั้งค่าที่ใช้งานได้จริง ถ้าตั้งค่าหลัง BeginDoc HotPDF จะได้ตัดสินใจใช้ layout แบบเก่าไปเรียบร้อยแล้ว
ทำไมทั้งสองอย่างจึงปิดไว้เป็นค่าเริ่มต้น
HotPDF ปล่อยให้ทั้งสอง property เป็น False ตั้งแต่แกะกล่อง และเหตุผลก็ปรากฏชัดในการเชื่อมต่อกับโค้ดปลายทางรุ่นเก่า ผู้อ่านที่เข้าใจแค่ PDF 1.4 จะไม่แจ้งเตือนว่ามันจัดการ object ที่ถูกบีบอัดไม่ได้ มันจะเจอ xref stream หาคำสำคัญของ trailer ที่คาดหวังไม่เจอสักคำ แล้วรายงานว่า cross-reference table เสียหาย หรือไม่ก็ปฏิเสธที่จะเปิดไฟล์ไปเลย ถ้า output ของคุณไหลไปยัง fax gateway รุ่นเก่า เครื่องพิมพ์ฮาร์ดแวร์ที่รัน interpreter แบบฝังตัว หรือ parser ที่ใครสักคนเขียนขึ้นตามสเปก 1.4 เมื่อสิบปีก่อน ให้ปิด flag ทั้งสองไว้สำหรับช่องทางนั้น แล้วยอมรับไฟล์ที่ใหญ่กว่า สำหรับการเก็บถาวรและการส่งมอบผ่านเว็บ ที่ viewer กระแสหลักทุกตัวอ่าน PDF 1.5 ได้มายี่สิบปีแล้ว การเปิดทั้งสองไว้คือการบีบอัดที่ได้มาแทบจะฟรี ๆ
มีผลกระทบระดับสองที่ควรบอกให้ทีมซัพพอร์ตของคุณรู้ไว้ เมื่อ dictionary ถูกอัดเข้าไปใน object stream แล้ว การเทียบไฟล์ที่สร้างขึ้นสองไฟล์แบบไบต์ต่อไบต์จะไม่มีความหมายอีกต่อไป เพราะการเปลี่ยนแค่ฟิลด์เดียวสามารถทำให้ต้อง re-Flate ทั้ง container และสับเปลี่ยนทุกอย่างหลังจากนั้นได้ ให้ diff ไฟล์แบบนี้ด้วยเนื้อหาระดับ object แทนที่จะเทียบแบบไบนารี
Incremental update และ byte offset ที่มันปกป้องไว้
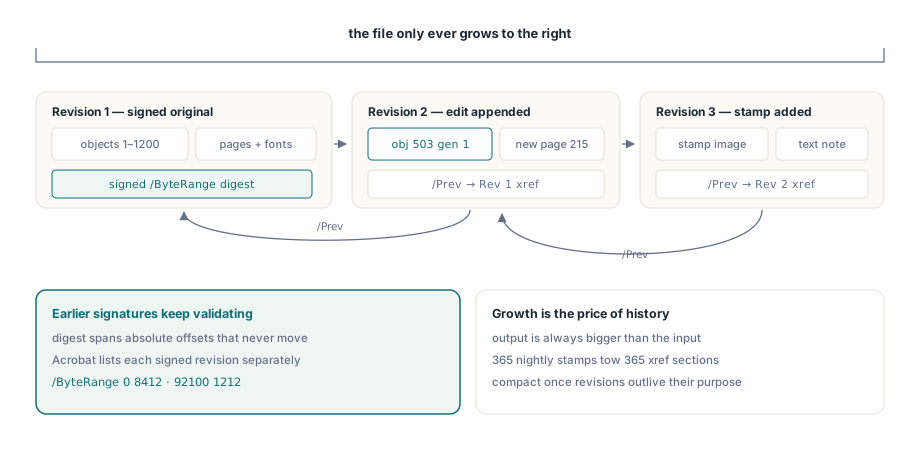
ลายเซ็นดิจิทัลครอบคลุม /ByteRange ที่ระบุไว้อย่างชัดเจน: สองช่วงของไฟล์จริง ที่ระบุเป็น byte offset แบบสัมบูรณ์ ซึ่งเป็นสิ่งที่ digest แบบ CMS ถูกคำนวณครอบคลุมไว้ หากเขียนไฟล์ใหม่ แม้จะออกมาดูเหมือนเดิมทุกประการบนหน้าจอ offset เหล่านั้นก็จะขยับทั้งหมด digest จะไม่ตรงกันอีกต่อไป และลายเซ็นจะอ่านค่าออกมาว่าเสียหาย นี่คือปัญหาที่ ISO 32000-1 §7.5.6 แก้ไขไว้อย่างตรงจุดด้วย incremental update object ใหม่และที่เปลี่ยนแปลงไปจะถูกต่อท้ายหลัง %%EOF เดิม แล้วจึงเขียนส่วน cross-reference ใหม่ที่มีรายการ /Prev ชี้กลับไปยังส่วนก่อนหน้า ไบต์เดิมจะไม่ถูกแตะต้องเลย ดังนั้น revision ที่เซ็นไว้จึงยังคงตรวจสอบได้ และ Acrobat สามารถแสดง revision ที่เซ็นไว้แต่ละอันแยกกันในแผง signature ได้
HotPDF เปิดให้ใช้งานสิ่งนี้ผ่านจุดเข้าใช้งานของตัวเอง:
Pdf.BeginIncrementalUpdate('contract-signed.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Addendum recorded 2026-06-11');
Pdf.SaveIncrementalUpdate('contract-updated.pdf');  // ต่อท้ายเฉพาะส่วนต่างเท่านั้น
มีสองสิ่งที่มักทำให้คนสะดุด BeginIncrementalUpdate ต้องได้รับชื่อไฟล์ต้นฉบับเสมอ เพราะส่วน xref ที่ต่อท้ายเข้าไปจะบันทึก offset ที่มีความหมายก็ต่อเมื่อเทียบกับไบต์ต้นฉบับตัวจริงนั้นเท่านั้น ถ้าชี้ไปที่สำเนาที่เปลี่ยนชื่อหรือบันทึกใหม่ offset เหล่านั้นก็จะอธิบายถึงไฟล์ที่ไม่มีอยู่แล้ว และการบันทึกก็ถูกออกแบบให้เป็นแบบ append-only โดยพื้นฐาน ดังนั้น output จะใหญ่กว่า input เสมอ การขยายตัวนี้ไม่ใช่ความสูญเปล่าที่ควรปรับแต่งออกไป มันเป็นคุณสมบัติเดียวกันกับที่ทำให้ revision ที่เซ็นไว้ก่อนหน้ายังคงสมบูรณ์
การแก้ไขไฟล์ที่โหลดไว้ต้องผ่าน LoadFromFile
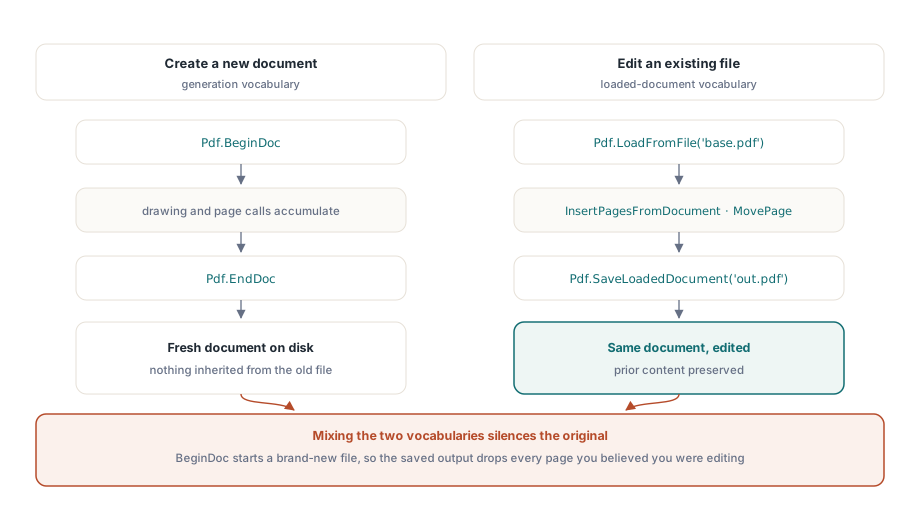
นักพัฒนาที่รู้จัก HotPDF ครั้งแรกผ่าน generation API มักจะไปชนกำแพงอันหนึ่งเข้า BeginDoc จะเปิดเอกสารใหม่เอี่ยม ซึ่งเป็นเครื่องมือที่ผิดเมื่อคุณต้องการแก้ไขเอกสารที่มีอยู่แล้ว การแก้ไขไฟล์ที่มีอยู่แล้วต้องผ่านฟังก์ชันเรียกของ loaded-document แทน:
PageCount := Pdf.LoadFromFile('base.pdf');
Pdf.InsertPagesFromDocument(OtherDoc, '1-3', 5);  // หน้า 1-3 หลังหน้า 5
Pdf.MovePage(2, 5);
Pdf.SaveLoadedDocument('modified.pdf');
ถ้าปนสองอย่างนี้เข้าด้วยกัน อาการที่ได้คือไฟล์ output ที่มีแต่เนื้อหาใหม่ของคุณและไม่มีอะไรจากต้นฉบับเลย เพราะ BeginDoc สร้างเอกสารใหม่ขึ้นมาข้าง ๆ เอกสารที่คุณเชื่อว่ากำลังแก้ไขอยู่อย่างร่าเริง ให้อ่าน LoadFromFile คู่กับ SaveLoadedDocument เป็นคำศัพท์ชุดหนึ่ง และ BeginDoc คู่กับ EndDoc เป็นอีกชุดหนึ่ง รูทีนที่เอื้อมไปใช้ทั้งสองชุดกับไฟล์เดียวกันแทบจะผิดเสมอ
เมื่อไรควรบีบอัดไฟล์ที่ถูกต่อท้ายไว้
การบันทึกแบบ append-only มีต้นทุนแฝงที่ค่อย ๆ สะสม งาน nightly ที่ประทับตราสถานะหนึ่งบรรทัดลงบน PDF เดียวกันจะผลิต revision ได้ 365 อันตลอดทั้งปี และทุก revision ก็ลากส่วน xref ใหม่ตามมาด้วย เมื่อประวัตินั้นหมดประโยชน์ไปแล้ว และไม่มีลายเซ็นใดในไฟล์ที่ต้องคงอยู่ต่อไป คุณสามารถ flatten ทั้งหมดได้ด้วยการ re-serialize ผ่านเส้นทาง loaded-document:
Pdf.LoadFromFile('stamped.pdf');
Pdf.SaveLoadedDocument('compacted.pdf');
การบันทึกซ้ำแบบนี้คือการเขียนใหม่ทั้งหมด มันทิ้ง revision ก่อนหน้าไปโดยตั้งใจ และทำลายลายเซ็นใด ๆ ที่ยังอยู่ในไฟล์ ดังนั้นให้วางมันไว้หลังด่านนโยบายเดียวกับที่คุณใช้กับขั้นตอนทำลายล้างอื่น ๆ กฎการใช้งานจริงข้อหนึ่งที่ใช้ได้ผลดี: บีบอัดเมื่อจำนวน revision ผ่านเกณฑ์ที่กำหนด หรือเมื่อ overhead ที่ต่อท้ายไว้โตเกินสัดส่วนหนึ่งของไฟล์ฐาน และห้ามบีบอัดเอกสารที่แผง signature มีอะไรอยู่ในนั้นเด็ดขาด
การตรวจสอบ output ก่อนส่งมอบ
การตรวจสอบฟีเจอร์คู่นี้เป็นเรื่องที่จับต้องได้ชัดเจนดี เปิดผลลัพธ์ใน Adobe Acrobat แล้วยืนยันสามจุด: document properties รายงานว่าเป็น PDF 1.5 หรือใหม่กว่าเมื่อเปิด object stream ไว้ แผง signature ยังคงตรวจสอบ revision ที่เซ็นไว้ก่อนหน้าทุกอันได้หลัง incremental update และจำนวนหน้ากับ bookmark ผ่านวงจร load, modify และ save มาโดยไม่บุบสลาย สำหรับ output ที่จะใช้เก็บถาวร ให้ส่งไฟล์ผ่าน veraPDF ด้วย เพราะ xref แบบบีบอัดเป็นโครงสร้างประเภทที่ validator เข้มงวดจะตรวจสอบอย่างละเอียดกว่าที่ viewer ใจดีทั่วไปจะทำ หากงานของคุณเกี่ยวข้องกับอินพุตขนาดใหญ่มากด้วย วิธีการตรวจสอบในบทความแนะนำ Direct File API สำหรับ workflow ของ PDF ขนาดใหญ่ของเราก็เข้ากันได้ดีกับการบันทึกแบบ incremental และกลไกลายเซ็นที่อยู่เบื้องหลัง byte range ข้างต้นก็อธิบายไว้อย่างละเอียดในบทความเรื่องลายเซ็นดิจิทัลและ PAdES ของ HotPDF
ทั้งสองฟีเจอร์นี้มาพร้อมกับHotPDF Delphi Componentสำหรับ Delphi และ C++Builder อยู่เคียงข้าง API ด้าน generation, form, encryption และ signing ที่กล่าวถึงในที่อื่น ๆ ของบล็อกนี้ หน้าผลิตภัณฑ์มีลิงก์ไปยังเอกสารอ้างอิง API ฉบับเต็ม หากคุณต้องการเทียบฟังก์ชันเรียกข้างต้นกับ pipeline เอกสารของคุณเอง