สร้างรายงานสักฉบับ ฝังฟอนต์ TrueType ลงไป แล้วผลลัพธ์ก็เปิดได้ถูกต้องในโปรแกรมอ่านทุกตัวที่คุณลอง กลีฟถูกต้อง ข้อความเลือกได้ ไฟล์ถูกต้องตามรูปแบบ สิ่งเดียวที่ผิดคือขนาด เอกสารที่ใช้ตัวอักษรละตินไม่กี่สิบตัวกลับแบกฟอนต์ทั้งชุดขนาด 350 KB ไปด้วย เอกสารที่พิมพ์ภาษาจีนหนึ่งย่อหน้าแบกฟอนต์ CJK ขนาด 14 MB แทนที่จะเป็นชิ้นส่วนขนาดครึ่งเมกะไบต์ตามที่ควรเป็น ไม่มี exception ถูกโยน ไม่มีคำเตือนถูกบันทึก และไฟล์ผ่านการตรวจสอบความถูกต้อง นี่คือหน้าตาของขั้นตอนปิดท้ายที่เรียงลำดับผิดเมื่อมองจากภายนอก: ไม่มีอะไรล้มเหลว และหลักฐานเดียวคือตัวเลขที่ใหญ่เกินไป
บั๊กที่ก่อเรื่องนี้อยู่ใน HotPDF หนึ่งสายรุ่นและได้รับการแก้ไขไปแล้ว มันคุ้มที่จะเขียนถึงไม่ใช่ในฐานะประกาศแจ้งข้อบกพร่อง แต่ในฐานะบทเรียน เพราะรูปทรงของความผิดพลาดนี้เป็นเรื่องทั่วไป เอนจินเอกสารทุกตัวมีขั้นตอนปิดท้ายที่แก้ไขออบเจกต์ก่อนจะเขียนออกไปเพียงเสี้ยววินาที และความถูกต้องของขั้นตอนนั้นขึ้นอยู่กับลำดับของมันเทียบกับการเขียนไฟล์ทั้งหมด วางขั้นตอนหนึ่งไว้ผิดฝั่งของการเขียน มันก็ไม่ทำอะไรเลย อย่างเงียบ ๆ
การ subset ฟอนต์ควรทำอะไร
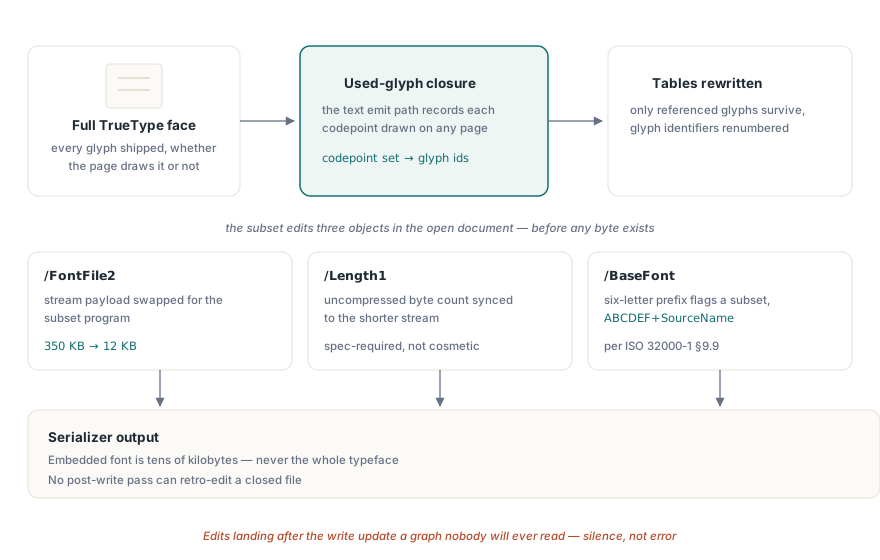
ฟอนต์แบบ subset คือส่วนของไฟล์ TrueType ที่เอกสารใช้งานจริง ISO 32000-1 §9.9 อธิบายว่าโปรแกรมฟอนต์ที่ฝังไว้เดินทางมาในสตรีมที่ตัวอธิบายฟอนต์อ้างถึงอย่างไร และสำหรับโปรแกรมแบบ TrueType สตรีมนั้นคือ /FontFile2 พร้อม /Length1 ที่บอกจำนวนไบต์แบบยังไม่บีบอัด การ subset เขียนตาราง glyf และ loca ใหม่ให้บรรจุเฉพาะกลีฟที่เอกสารอ้างถึง เปลี่ยนหมายเลขตัวระบุกลีฟใหม่ และเติมคำนำหน้าหกตัวอักษรอย่าง ABCDEF+ ให้ชื่อ /BaseFont เพื่อทำเครื่องหมายว่าฟอนต์นี้เป็น subset ตรงตามที่ข้อกำหนดเรียกร้อง ฟอนต์ละตินที่ subset เหลือสิบถึงสิบห้ากิโลไบต์คือความต่างระหว่าง PDF ที่กระชับกับ PDF ที่ขนแบบอักษรทั้งชุดไปด้วยเพื่อหัวข้อเดียว
จังหวะที่สิ่งนี้เกิดขึ้นมีความสำคัญ การ subset ไม่ใช่การแปลงที่คุณเอาไปใช้กับไบต์ที่อยู่บนดิสก์แล้ว มันแก้ไขกราฟออบเจกต์ในหน่วยความจำ: มันย่อเนื้อหาสตรีม /FontFile2 แก้ค่า /Length1 ให้ตรง และเขียนสตริง /BaseFont ใหม่ ทั้งหมดนั้นต้องอยู่ในที่ของมันแล้วเมื่อตัวเขียนเดินไล่กราฟและปล่อยไบต์ออกมา ถ้าการแก้ไขเหล่านั้นลงหลังจากไบต์ถูกเขียนไปแล้ว มันก็ไปอัปเดตออบเจกต์ที่จะไม่มีใครอ่านอีกเลย
อาการ และเหตุผลที่ไม่มีใครบ่นสักคำ
พฤติกรรมที่ถูกรายงานคือฟอนต์เต็มชุดในไฟล์ผลลัพธ์ โดยไม่มีข้อความวินิจฉัยใด ๆ ผู้ใช้ที่ลงทะเบียนฟอนต์ TrueType แบบ Unicode แล้วสร้างเอกสารตามปกติพบว่าออบเจกต์ฟอนต์ที่ฝังไว้มีความยาวเท่ากับไฟล์ .ttf ต้นทาง และชื่อ /BaseFont ไม่มีคำนำหน้า subset หกตัวอักษรติดมาเลย ขนาดไฟล์ผลลัพธ์ไม่เคยเล็กลงระหว่างการรันที่ใช้สิบกลีฟกับการรันที่ใช้หนึ่งหมื่นกลีฟ
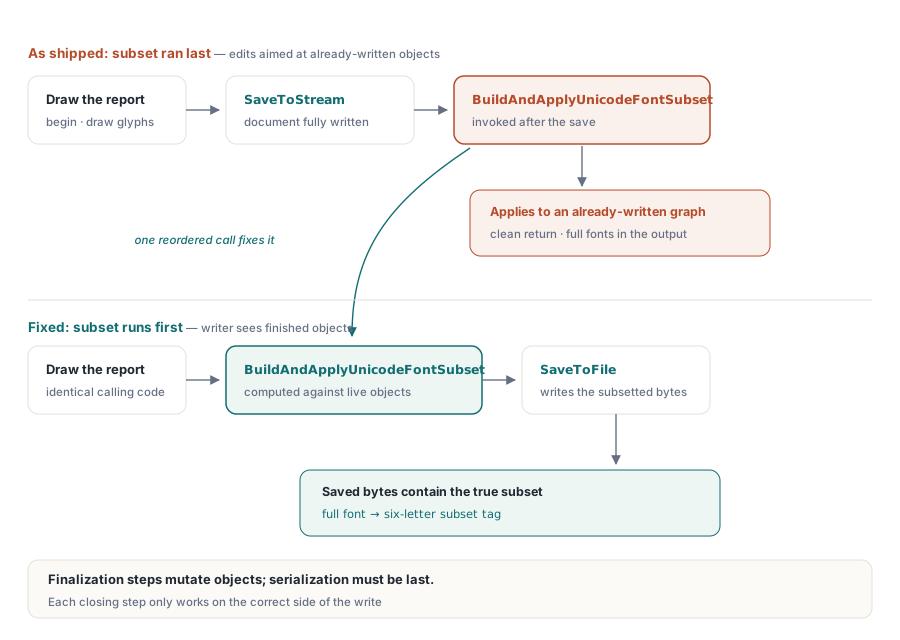
การไม่มีข้อผิดพลาดใด ๆ คือส่วนที่ทำให้บั๊กประเภทนี้แพง รูทีน subset ที่รันผิดจังหวะก็ยังรันอยู่ดี มันเดินไล่ชุดโค้ดพอยต์ที่สะสมไว้ สร้าง subset ที่ถูกต้องเป๊ะ แล้วนำไปใช้กับกราฟออบเจกต์ในหน่วยความจำ ภายในนั้นงานเสร็จเรียบร้อยและการเรียกก็คืนค่ากลับอย่างสะอาด สิ่งเดียวที่ผิดคือกราฟออบเจกต์ที่มันแก้ไขไม่ใช่สิ่งที่กำลังถูกเขียนอีกต่อไปแล้ว เพราะตัวเขียนทำงานเสร็จไปก่อนหน้า จากมุมของผู้เรียก เอกสารถูกผลิตและบันทึกไปโดยไม่มีเหตุการณ์ใด ซึ่งเป็นภาพลวงตาที่ความล้มเหลวแบบเงียบมอบให้พอดี
ต้นตอคือลำดับของการปิดท้าย
ใน HotPDF งานปิดท้ายเกิดขึ้นภายใน EndDoc ขั้นตอน subset คือรูทีนภายในชื่อ BuildAndApplyUnicodeFontSubset มันอ่านชุดโค้ดพอยต์ที่ถูกใช้ของเอกสารนั้น ซึ่งเก็บไว้ในบิตแมปที่เส้นทางปล่อยข้อความเติมค่าให้ขณะกลีฟถูกแสดง จับคู่โค้ดพอยต์ที่ถูกใช้แต่ละตัวผ่านตารางแคชโค้ดพอยต์ไปยังกลีฟเพื่อให้ได้ตัวระบุกลีฟจริง แล้วเขียนโปรแกรมฟอนต์ใหม่รอบชุดปิดนั้น เมื่อมีการลงทะเบียนฟอนต์ TrueType แบบ Unicode เส้นทางปล่อยข้อความจะตั้งบิตในชุดโค้ดพอยต์ที่ถูกใช้ทุกครั้งที่วาดอักขระ ดังนั้นเมื่อถึงเวลาปิดเอกสาร เอนจินจึงรู้แน่ชัดว่ากลีฟใดบ้างที่ subset ต้องเก็บไว้
ข้อบกพร่องคือ BuildAndApplyUnicodeFontSubset ถูกเรียกหลังจาก SaveToStream หรือ SaveToFile เขียนเอกสารออกไปเป็นไบต์เรียบร้อยแล้ว การแก้ไข /FontFile2 ของตัว subset ค่า /Length1 ที่มันแก้ให้ถูก และคำนำหน้าหกตัวอักษรของ /BaseFont ล้วนถูกคำนวณจากกราฟออบเจกต์ที่ถูกแปลงเป็นไบต์ไปแล้ว ทางแก้คือการเรียงลำดับใหม่เพียงบรรทัดเดียว: ย้ายการเรียก subset ไปไว้ก่อนการเขียนไฟล์ เพื่อให้ตัวเขียนปล่อยฟอนต์ที่ subset แล้วออกมาแทนของเดิม ลำดับที่ถูกต้องจะรัน subset ก่อน แล้วจึงเขียนไฟล์ทีหลัง
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansSC-Regular.ttf');
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Noto Sans SC', [], 12);
    Pdf.CurrentPage.TextOut(72, 760, 0, '报表标题 Report Heading');
    Pdf.EndDoc;                 // การ subset รันตรงนี้ ก่อนการเขียนไฟล์
    Pdf.SaveToFile('Report.pdf');
  finally
    Pdf.Free;
  end;
end;
เมื่อแก้ลำดับแล้ว ไม่มีอะไรในโค้ดฝั่งผู้เรียกต้องเปลี่ยน การ subset เปิดอยู่โดยค่าเริ่มต้นทันทีที่มีการลงทะเบียนฟอนต์ TrueType แบบ Unicode คุณลงทะเบียนฟอนต์ เริ่มเอกสาร วาด แล้วจบเอกสาร จากนั้น subset ก็ถูกสร้างจากกลีฟที่คุณใช้ก่อนที่ไบต์จะออกจากหน่วยความจำ
เหตุใดขั้นตอนที่วางผิดที่เพียงขั้นเดียวจึงเป็นทั้งหมวดปัญหา
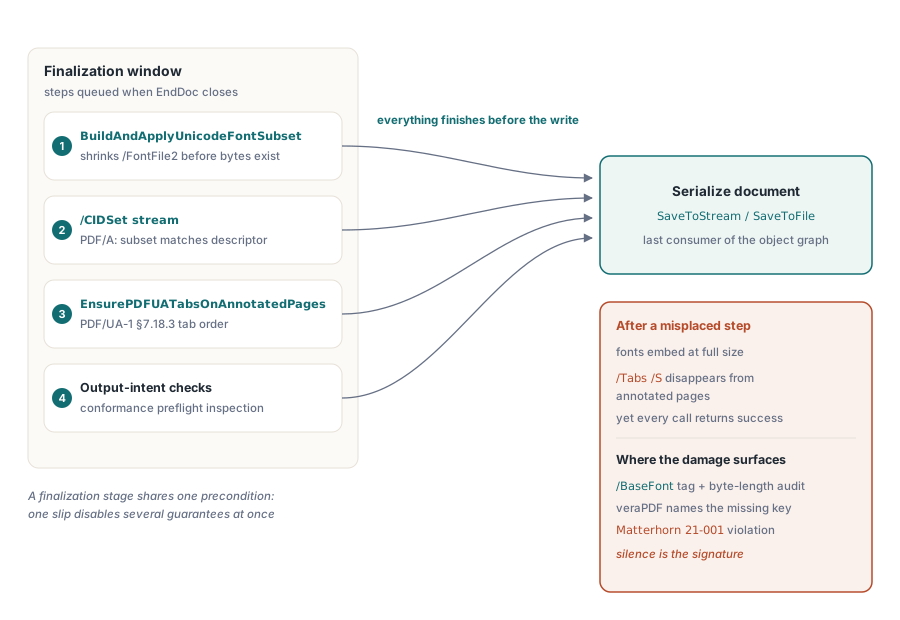
เหตุผลที่เรื่องนี้ควรเป็นบทเรียนมากกว่าเชิงอรรถ คือ EndDoc ปล่อยรายการขั้นตอนปิดท้ายออกมาชุดหนึ่ง และทุกขั้นตอนในนั้นไวต่อตำแหน่งของมันเทียบกับการเขียนไฟล์ การ subset ฟอนต์เป็นหนึ่งในนั้น ผลลัพธ์แบบ PDF/A ต้องมีสตรีม /CIDSet ที่แจกแจงตัวระบุกลีฟที่มีอยู่ใน subset อย่างครบถ้วน ซึ่งเป็นข้อบังคับที่ ISO 19005 กำหนดไว้เพื่อให้ตัวตรวจสอบยืนยันได้ว่าโปรแกรมฟอนต์ที่ฝังตรงกับที่ตัวอธิบายฟอนต์ประกาศไว้ สตรีมนั้นถูกปล่อยในหน้าต่างการปิดท้ายเดียวกันและขึ้นอยู่กับว่า subset ถูกสร้างมาก่อนแล้ว ส่วน PDF/UA-1 กำหนดไว้ตาม ISO 14289-1 §7.18.3 ว่าทุกหน้าที่มีคำอธิบายประกอบต้องประกาศ /Tabs ด้วยค่า /S และรูทีนภายในชื่อ EnsurePDFUATabsOnAnnotatedPages ประทับคีย์นั้นในระยะเดียวกัน การตรวจ output intent ก็รันอยู่ตรงนั้นด้วย
ความผิดพลาดเรื่องลำดับตัวเดียวกันที่ปิดการ subset ยังทำให้คีย์ลำดับแท็บของ PDF/UA หายไปจากหน้าที่มีคำอธิบายประกอบด้วย เพราะขั้นตอนนั้นนั่งอยู่ผิดฝั่งของการเขียนเหมือนกัน veraPDF และ PAC รายงานการขาด /Tabs /S ว่าเป็นการละเมิดจุดตรวจ 21-001 ของโปรโตคอล Matterhorn ดังนั้นการเรียกที่วางผิดที่ครั้งเดียวไม่ได้เพียงทำให้ไฟล์บวมขึ้น แต่ยังทำลายข้อกำหนดความสอดคล้องด้านการเข้าถึงไปพร้อมกันอย่างเงียบ ๆ ด้วยการไม่มีข้อผิดพลาดใด ๆ เช่นเดิม นั่นคืออันตรายของระยะปิดท้าย: ขั้นตอนต่าง ๆ ในนั้นใช้เงื่อนไขก่อนหน้าร่วมกัน และความผิดพลาดเรื่องลำดับครั้งเดียวก็ล้มหลายขั้นตอนพร้อมกันได้ ขณะที่ทุกการเรียกยังรายงานว่าสำเร็จ
จับความล้มเหลวแบบเงียบตอนปล่อยไฟล์ได้อย่างไรจริง ๆ
บั๊กที่ไม่โยน exception จับไม่ได้ด้วยการรันโปรแกรม มันถูกจับได้ด้วยการตรวจไฟล์ผลลัพธ์แล้วเทียบกับสิ่งที่อินพุตควรผลิตออกมา สำหรับการ subset ฟอนต์ การตรวจนั้นเป็นรูปธรรม เทียบขนาดไฟล์ผลลัพธ์กับความคาดหมายคร่าว ๆ: เอกสารที่แตะกลีฟไม่กี่ตัวไม่ควรมีขนาดเท่าแบบอักษรเต็มชุด เปิดออบเจกต์ฟอนต์ที่ฝังไว้แล้วอ่านความยาวเป็นไบต์ของมัน /FontFile2 ที่ subset แล้วสำหรับฟอนต์ละตินจะเป็นเพียงเศษเสี้ยวเล็ก ๆ ของไฟล์ต้นทาง อ่านชื่อ /BaseFont แล้วยืนยันว่ามีคำนำหน้าหกตัวอักษรอยู่จริง เพราะการไม่มีมันคือสัญญาณตรง ๆ ว่าไม่มีการใช้ subset เลย
var
  Pdf: THotPDF;
  Output: TMemoryStream;
begin
  Output := TMemoryStream.Create;
  try
    Pdf := THotPDF.Create(nil);
    try
      Pdf.RegisterUnicodeTTF('C:\Fonts\DejaVuSans.ttf');
      Pdf.BeginDoc;
      Pdf.CurrentPage.SetFont('DejaVu Sans', [], 11);
      Pdf.CurrentPage.TextOut(72, 760, 0, 'Subset me');
      Pdf.EndDoc;
      Pdf.SaveToStream(Output);
    finally
      Pdf.Free;
    end;
    // กลีฟไม่กี่ตัวจากแบบอักษรราว 700 KB ต้องไม่ให้สตรีมหลายร้อย KB
    if Output.Size > 100 * 1024 then
      raise Exception.Create('Font subset did not shrink the output');
  finally
    Output.Free;
  end;
end;
สำหรับผลลัพธ์แบบ PDF/A การตรวจยิ่งคมกว่า เพราะตัวตรวจสอบทำงานแทนคุณ ตั้งระดับความสอดคล้องแล้วส่งผลลัพธ์ผ่าน veraPDF: การขาด /CIDSet หรือ subset ที่ไม่ตรงกับตัวอธิบายฟอนต์ จะถูกรายงานเป็นข้อที่ไม่ผ่าน แทนที่จะปล่อยให้คุณสังเกตเอาเองด้วยตา สวิตช์ความสอดคล้องที่ขับงานปิดท้ายชุดนี้เป็นคุณสมบัติบนตัวเอกสาร PDFACompliance รับสตริงอย่าง '2B' สำหรับ PDF/A-2 ระดับ B ส่วน PDFUACompliance เป็นค่าบูลีนที่เปิดข้อกำหนดเรื่อง PDF แบบมีแท็กและลำดับแท็บ
Pdf := THotPDF.Create(nil);
try
  Pdf.PDFACompliance := '2B';     // PDF/A-2 ระดับ B ขับการปล่อย /CIDSet
  Pdf.PDFUACompliance := True;    // ประทับ /Tabs /S บนหน้าที่มีคำอธิบายประกอบ
  Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansSC-Regular.ttf');
  Pdf.BeginDoc;
  Pdf.CurrentPage.SetFont('Noto Sans SC', [], 12);
  Pdf.CurrentPage.TextOut(72, 760, 0, '合规报告');
  Pdf.EndDoc;
  Pdf.SaveToFile('Report_PDFA.pdf');
finally
  Pdf.Free;
end;
บทเรียนเชิงวิศวกรรม
มีกฎสองข้อที่หล่นออกมาจากเรื่องนี้ ข้อแรกคือขั้นตอนปิดท้ายใดก็ตามที่แก้ไขออบเจกต์ต้องรันก่อนที่ออบเจกต์เหล่านั้นจะถูกเขียนออกไป และควรอ่านระยะปิดท้ายของเอนจินเอกสารเป็นไปป์ไลน์ที่มีลำดับ ซึ่งการเขียนไฟล์คือการกระทำสุดท้าย ไม่ใช่หนึ่งในหลายการกระทำที่สลับที่กันได้ ข้อที่สองคือข้อที่แลกมาด้วยเวลามากที่สุดในกรณีนี้: สำหรับขั้นตอนที่ปล่อยผลลัพธ์ การไม่มีข้อผิดพลาดไม่ใช่หลักฐานของความสำเร็จ รูทีนที่สร้าง subset ถูกต้องแล้วนำไปใช้กับกราฟที่ผิดซึ่งเขียนไปแล้ว จะไม่รายงานว่ามีอะไรผิด เพราะจากมุมของมันเองไม่มีอะไรผิดจริง ๆ การตรวจสอบต้องมองที่ตัวชิ้นงาน ไม่ใช่ที่ค่าที่คืนกลับมา ตรวจขนาดผลลัพธ์ อ่านความยาวเป็นไบต์ของฟอนต์ที่ฝังไว้และคำนำหน้า /BaseFont ของมัน แล้วปล่อยให้ veraPDF ตัดสินผลลัพธ์ PDF/A ในที่ที่การขาด /CIDSet เปลี่ยนความบกพร่องเงียบ ๆ ให้กลายเป็นความล้มเหลวที่มีชื่อเรียก
ฝั่งผู้ผลิตของการจัดการฟอนต์ ว่าแบบอักษรถูกลงทะเบียนและฝังอย่างไรสำหรับผลลัพธ์รายงาน มีอธิบายไว้ในบทความของเราเรื่องฟอนต์และภาพในผลลัพธ์รายงาน ส่วนฝั่งการตรวจสอบ ที่ขั้นตอนปิดท้ายเหล่านี้ถูกตรวจเทียบกับมาตรฐาน มีอธิบายไว้ในคู่มือเดินผ่านการตรวจสอบ PDF/A และ PDF/UA ทั้งสองบทความจับคู่กับงาน subset และงานความสอดคล้องที่อธิบายไว้ที่นี่ ซึ่งมาพร้อมกับ HotPDF Delphi Component สำหรับ Delphi และ C++Builder เคียงข้าง API การโหลด การแก้ไข การเข้ารหัส และการลงลายเซ็นที่กล่าวถึงในที่อื่นของบล็อกนี้