HotPDF Delphi Component kan söka och ersätta text inuti en befintlig PDF från Delphi och C++Builder. SearchLoadedPageText och SearchLoadedDocumentText lokaliserar varje förekomst av en sträng med precision på glyfnivå, och ReplaceLoadedPageText och ReplaceLoadedDocumentText skriver om de matchade byten på plats — förutsatt att varje ersättningstecken kan kodas om genom originaltypsnittet, en fysisk begränsning som den här artikeln behandlar ärligt istället för att gömma i en fotnot
Önskemålet bakom den här funktionen är alltid vardagligt. Ett företag byter namn och tre tusen arkiverade fakturor bär fortfarande det gamla namnet. En avtalsmall levererades med förra årets utgångsdatum. En produktkod pensionerades och varje datablad som nämner den behöver efterföljarkoden istället. I en ordbehandlare är vart och ett av de här ett trettiosekundersjobb. I en PDF är det ett genuint svårt problem, och att förstå varför är skillnaden mellan att använda API:et väl och att skicka in en buggrapport som egentligen är ett citat ur specifikationen
Varför är det så svårt att ersätta text i en PDF?
Att ersätta text i en PDF är svårt eftersom en PDF-sida inte innehåller redigerbar text — den innehåller placerade glyfer. Under textvisningsmodellen i ISO 32000-1 §9.4 driver en innehållsström operatorer som Tj och TJ vilka målar sekvenser av teckenkoder vid koordinater som textmatrisen fastställt. De koderna är inte Unicode; de är index in i vilken kodning sidans typsnitt än deklarerar, och mappningen tillbaka till läsbara tecken kan bo i en /ToUnicode-CMap, en array med kodningsskillnader, eller en kedja av CID-mappningar. Det finns inget styckeobjekt, inget textflöde, och ingen garanti för att ett visuellt ord ens lagras som en enda sträng
Ersättning lägger ett andra lager av svårighet ovanpå avkodningen: du måste veta exakt vilka byte i originalströmmen som gav varje glyf, så att du kan skarva in nya byte i precis det spannet och inget annat. En textextraherare har råd att kasta bort bytepositionerna när den väl fått ut sin Unicode. En ersättare har inte det. Det är varför HotPDF delade upp arbetet över två utgåvor — v2.251.0 byggde lagret för offsetspårning och sökning, och v2.252.0 byggde omskrivningslagret ovanpå det
Att hitta text: sökning på glyfnivå med spårning av byteoffset
HotPDF:s SearchLoadedDocumentText hittar varje förekomst av en söksträng genom att matcha mot varje sidas avkodade Unicode-glyfsekvens, inte mot råa strömbyte, så en träff är en träff oavsett hur typsnittet kodade den. Infrastrukturen under introducerades i v2.251.0: tokeniseraren för innehållsströmmar registrerar ett bytespann StartOfs/EndOfs för varje strängoperand — inklusive dess avgränsare ( ) eller < > — och varje avkodad glyf bär en trippel TokenIndex/ItemIndex/ByteOffset som pekar tillbaka på exakt den operand, det TJ-array-element och den kodenhet som gav den. Samma glyftolk driver extraktions-API:et som beskrivs i extrahera text från en inläst PDF i Delphi; sökningen behåller helt enkelt det ursprung som extraktionen kastar
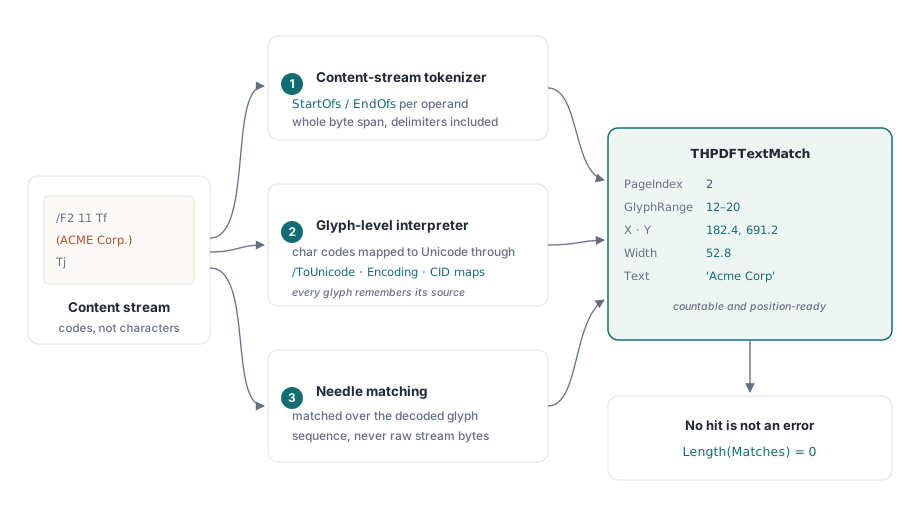
Varje träff kommer tillbaka som en THPDFTextMatch-post som bär sidindexet, det inklusiva glyfintervallet, träffens origo i X/Y i användarrymd och dess bredd, källtoken- och elementindex, samt själva den matchade texten. Det räcker för att driva ett överstrykningslager, ett granskningsgränssnitt eller ersättningssteget. En sökning som inte hittar något returnerar en tom array istället för att misslyckas, så anropsmönstret förblir enkelt
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
    begin
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to Length(Matches) - 1 do
          WriteLn(Format('page %d at (%.1f, %.1f): "%s"',
            [Matches[I].PageIndex, Matches[I].X, Matches[I].Y,
             Matches[I].Text]));
    end;
  finally
    Pdf.Free;
  end;
end;
Ett medvetet designval förtjänar en anmärkning. När CaseSensitive är False jämför funktionen med skiftlägesvikning enbart för ASCII-tecken, med flit: fullständig Unicode-skiftlägesvikning beter sig olika över de verktygskedjor från Delphi 5 till XE som HotPDF stöder, och ett sök-API som hittar olika träffar beroende på vilken kompilator som byggt din applikation är sämre än ett med en dokumenterad, förutsägbar gräns. För latinsk affärstext — namn, koder, datum — täcker ASCII-vikning de praktiska fallen
Att ersätta text: omvänd kodning och kirurgisk skarvning
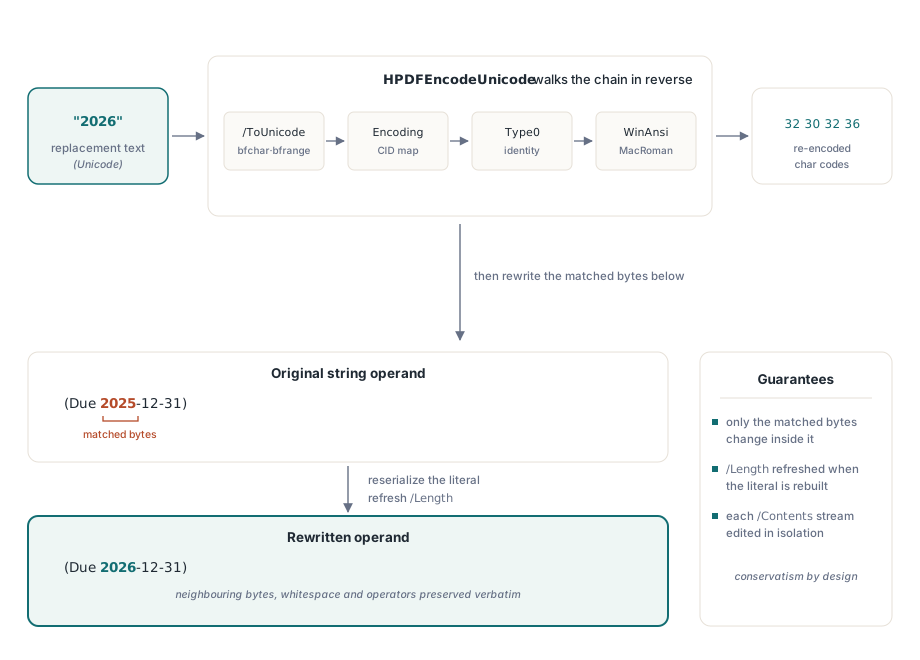
ReplaceLoadedDocumentText, tillagd i HotPDF v2.252.0, skriver om varje förekomst av en söksträng genom att köra avkodningsmaskineriet baklänges. Funktionen HPDFEncodeUnicode är inversen av teckenkodsavkodaren: den går igenom samma strategikedja omvänt — uppslagning i /ToUnicode med bfchar och bfrange, CID-mappning via kodningsström, Type0-identitetsmappningar, och de fördefinierade WinAnsi- och MacRoman-tabellerna — för att förvandla varje ersättningstecken tillbaka till de teckenkodsbyte som originaltypsnittet väntar sig. De omkodade byten serialiseras sedan till en välformad strängliteral eller hexsträng, och speglar tokeniserarens egna escaping-regler så att en rundtur av tolkning och omserialisering är stabil
Själva skarvningen är kirurgisk snarare än total. Endast det kodbyteintervall som träffen täcker ersätts inuti strängoperanden; byte i samma operand som inte matchat, blanktecknen mellan token, och varje omgivande operator bevaras ordagrant, byte för byte. Att ersätta bca inuti abcabc ger a + ersättningen + bc, inte en sönderskriven operand. Ersättningar får vara kortare eller längre än söksträngen — literalen serialiseras om och strömmens /Length uppdateras — och varje /Contents-ström på en sida med flera strömmar bearbetas isolerat så att sidan förblir välformad
var
  Pdf: THotPDF;
  ReplaceCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, ReplaceCount) then
        WriteLn(Format('%d operand rewrites performed', [ReplaceCount]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Lägg märke till vad API:et inte gör: det sätter inte om sidan. PDF har ingen ombrytning, så en ersättning som är visuellt bredare än originalet tar helt enkelt mer vågrätt utrymme och kan tränga ihop vad som än målats till höger om den. Ersättningar av samma eller nästan samma längd — datum, versionssträngar, artikelnummer, namnrättelser — är den söta punkten. Omformulering i stor skala hör hemma i källdokumentet, inte i PDF:en
Varför går det inte att ersätta text med tecken som typsnittsdelmängden aldrig innehöll?
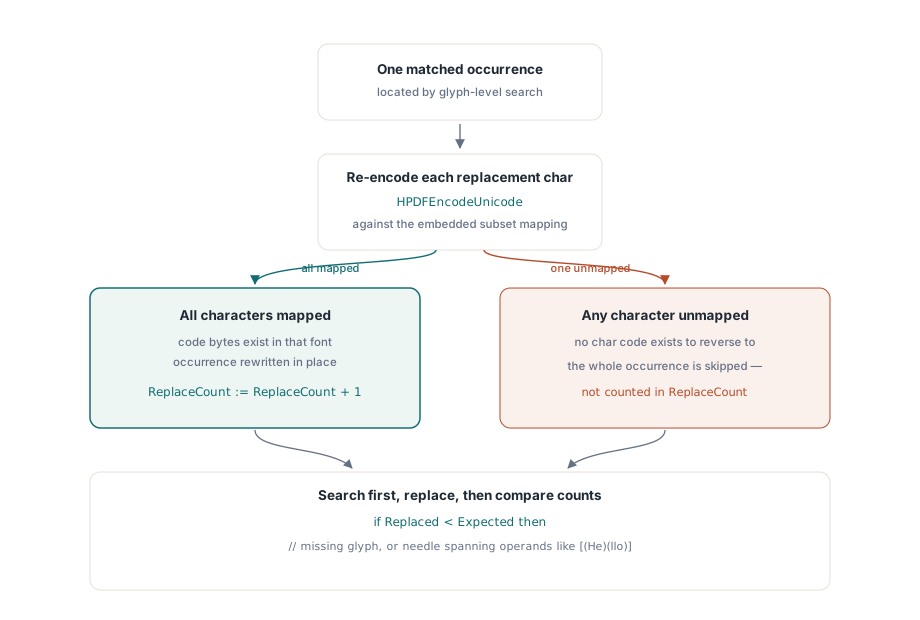
Du kan inte ersätta text med ett tecken som den inbäddade typsnittsdelmängden aldrig innehöll, eftersom den bytesekvens som skulle välja det tecknet helt enkelt inte finns i typsnittets mappningstabeller. När en PDF-producent bäddar in ett delmängdstypsnitt täcker dess /ToUnicode-CMap och kodningsstrukturer bara de glyfer originaldokumentet faktiskt använde. HPDFEncodeUnicode kan bara vända på en mappning som finns: om dokumentet aldrig innehöll bokstaven E i det typsnittet finns det ingen teckenkod för E att vända tillbaka till. Det är en fysisk egenskap hos filen, inte en begränsning i något särskilt bibliotek — inget verktyg kan trolla fram en glyfmappning som aldrig bäddats in
HotPDF hanterar misslyckandet försiktigt. Om ett enda tecken i ersättningen inte kan kodas om hoppas hela den förekomsten av söksträngen över — inget undantag, ingen delvis skräptext, och förekomsten räknas helt enkelt inte i ReplaceCount. Den praktiska följden: kontrollera ReplaceCount mot antalet träffar från en föregående sökning, och behandla ett underskott som en signal. I datumexemplet ovan måste siffran 6 förekomma någonstans i dokumentets text i samma typsnitt för att omskrivningen ska lyckas — sannolikt i en faktura, aldrig garanterat i allmänhet. När tecknen du behöver helt enkelt inte finns tillgängliga och målet är att ta bort känslig text snarare än att formulera om den, är riktig innehållsborttagning ändå det bättre verktyget; se att maskera och strukturera om inlästa PDF-filer i Delphi för den vägen
var
  Matches: THPDFTextMatchArray;
  Expected, Replaced: Integer;
begin
  Pdf.SearchLoadedDocumentText('Acme Corp', True, Matches);
  Expected := Length(Matches);
  Pdf.ReplaceLoadedDocumentText('Acme Corp', 'Apex Corp', True, Replaced);
  if Replaced < Expected then
    WriteLn(Format('%d occurrence(s) skipped: characters missing ' +
      'from the font subset, or match spans multiple operands',
      [Expected - Replaced]));
end;
Det andra villkoret för överhoppning i det meddelandet är den andra dokumenterade gränsen: en söksträng som spänner över flera strängoperander — Hello uppdelat över elementen i [(He)(llo)] TJ, till exempel — hittas av sökningen, eftersom sökningen matchar den avkodade glyfsekvensen, men hoppas över av ersättningen, eftersom en omskrivning över operandgränser skulle kräva sammanslagning av intilliggande bytespann. Att söka och sedan verifiera gör båda gränserna synliga istället för tysta
Vad ändras i filen när du sparar?
En ersatt /Contents-ström sparas okomprimerad. FlateDecode-komprimerade strömmar packas upp för redigering, och när HotPDF skriver de återuppbyggda byten släpper den strömmens /Filter-post och uppdaterar /Length istället för att komprimera om. Den resulterande PDF:en är fullt giltig och renderas normalt i etablerade visare; avvägningen är en större fil för varje redigerad ström. För en batchpipeline som bearbetar tusentals dokument, budgetera för den tillväxten eller kör en separat komprimeringsomgång nedströms. Hur omskrivna objekt samspelar med dokumentets korsreferensstruktur vid sparande är ett ämne för sig, som täcks i objektströmmar och inkrementella uppdateringar i HotPDF
Allt annat i filen lämnas i fred. Orörda strömmar behåller sin komprimering, typsnitt och bilder skrivs inte om, och skarvningen på operandnivå betyder att även de redigerade strömmarna skiljer sig från originalet bara där en träff landade. Den försiktigheten är avsiktlig: ju mer av ett inläst dokument ett bibliotek skriver om, desto fler tillfällen får det att bryta en producentegenhet det inte förutsett
Textsökning och -ersättning sällar sig till extraktion, maskering och sidrendering i HotPDF:s verktygslåda för inlästa dokument, alla drivna av samma tolk för innehållsströmmar och tillgängliga från Delphi 5 till och med de aktuella RAD Studio-utgåvorna utan externa beroenden. Den fullständiga API-referensen och testnedladdningen finns på produktsidan för HotPDF Delphi Component