En Reed-Solomon-encoderare som lagrar sitt generatorpolynom med konstanttermen först och sedan dividerar med ledande term först beräknar ingen felkorrigering över huvud taget. HotPDF släppte exakt det i fyra 2D-streckkodsencoderare, QR, Data Matrix, PDF417 och Aztec, och varje symbol de producerade bar ett checkblock som ingen konform skanner kunde använda
Det intressanta är inte det aritmetiska misstaget. Det är spridningen. En encoderare skrevs först, dess divisionsloop kopierades in i de tre nästa, och varje nytt format ärvde ett fel som aldrig validerats mot en enda publicerad testvektor. Symbolerna renderades fortfarande, finder-mönstren satt rätt, storlekarna stämde. Bara de byte som låter en 2D-streckkod överleva en fläck var skräp
Ett omvänt polynom, kopierat in i fyra encoderare
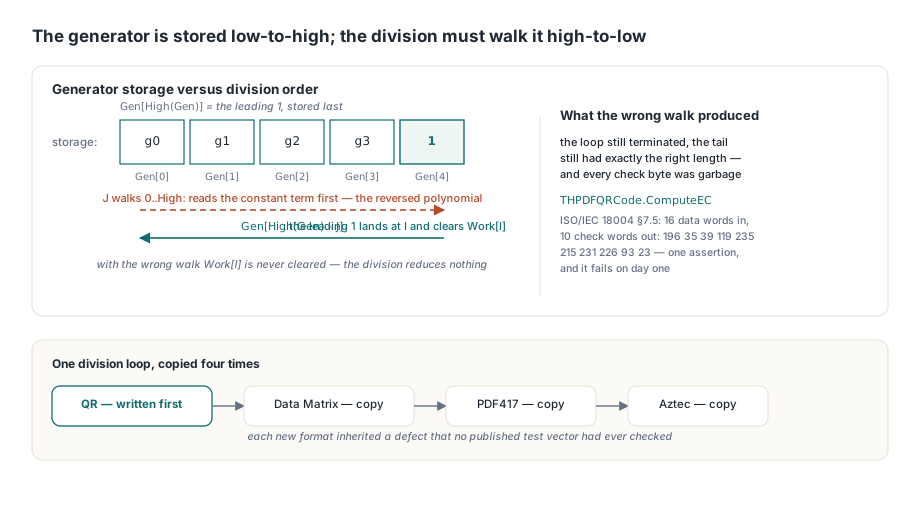
Grundorsaken är en missmatch i lagringsordningen inuti den syntetiska divisionsloopen. Alla fyra HotPDF-encoderarna bygger generatorpolynomet med koefficienter från låg till hög, så Gen[0] håller konstanttermen och Gen[High(Gen)] håller den moniska ledande koefficienten. Divisionsloopen indexerade Gen[J] framåt medan den gick igenom meddelandet, vilket aritmetiskt är identiskt med att dividera med det omvända polynomet. Det fanns en andra konsekvens som gömde den första: eftersom den ledande koefficienten aldrig hamnade på position I, nollställdes Work[I] aldrig, så divisionen reducerade aldrig något. Loopen terminerade ändå och fyllde fortfarande svansen med en array av exakt rätt längd
// THPDFQRCode.ComputeEC i HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] är konstanttermen
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] är den ledande 1:an som nollställer Work[I]; att gå igenom Gen
  // framåt dividerar med det omvända polynomet i stället
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Fixen är det enda indexuttrycket Gen[High(Gen) - J]. Efter det återger THPDFQRCode.ComputeEC det genomräknade exemplet i ISO/IEC 18004 §7.5: version 1-M byte-mode-blocket 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 ger de tio checkorden 196 35 39 119 235 215 231 226 93 23. Det är en enda assertion, och den hade misslyckats på dag ett
Varför tappade Aztec-symbolen också sitt innehåll?
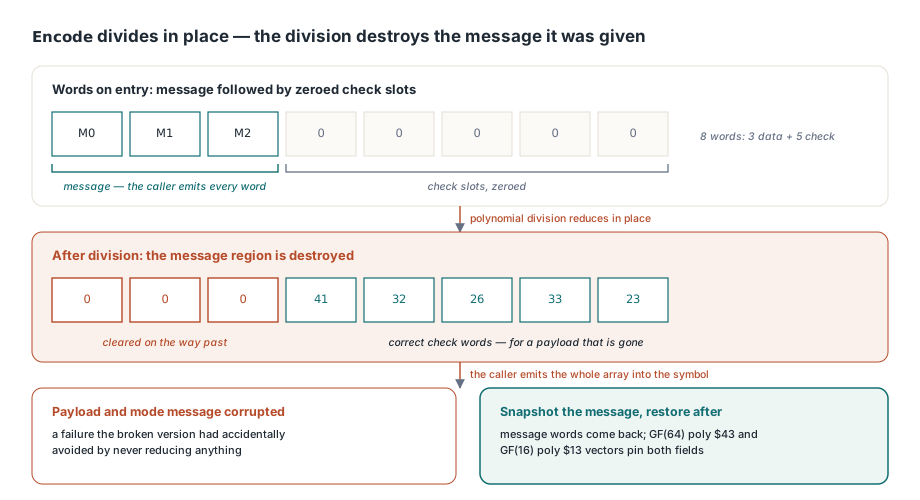
Aztec bar en tyngre version av samma bugg eftersom TAztecGF.Encode dividerar på plats. Rutinen tar emot Words som håller meddelandet följt av nollställda checkordslottar, och den anropande parten sänder hela den arrayen in i symbolen. Polynomdivision förstör dividenden medan den reducerar, så när loopen väl fixats till att faktiskt reducera skrevs meddelandeorden över på vägen. Både innehåll och mode message kom ut korrupta, ett fel som den trasiga versionen råkat undvika genom att aldrig reducera något
// TAztecGF.Encode i HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// Divisionen nollställer meddelanderegionen, men den anropande parten sänder
// hela arrayen in i symbolen, så dataorden måste tillbaka
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec använder två olika fält, och regressionsfixturen övar båda. I GF(64), fältet för en sexbitars symbol byggd från primitivt polynom $43, ger orden 12 45 3 med fem checkord 41 32 26 33 23 medan de tre första förblir orörda. I GF(16), fältet för mode message med primitivt polynom $13, ger orden 5 9 resultatet 11 15 6 8. Båda körs genom HPDFAztecTestEncode-kroken mot ISO/IEC 24778
Vad gör att Data Matrix behöver två fixar i stället för en?
THPDFDataMatrix.ComputeEC staplade ett andra, oberoende fel ovanpå det delade: det byggde generatorpolynomet med rötter som börjar vid α^0, medan ISO/IEC 16022 Annex E anger rötter från α^1. Fixar du bara divisionsindexet får du checkorden 146 107 90 179 128 för standardexemplet, som ser precis lika trovärdiga ut som de korrekta och ändå är oläsbara. Båda felen måste bort innan siffrorna stämde
// THPDFDataMatrix.ComputeEC i HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: rötterna går alpha^1..alpha^ECCount, inte från alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Referenspunkten är liten nog att hålla i en kommentar. Strängen '123456' kodas till ASCII-codeorden 142 164 186, en 10x10-symbol bär fem checkord, och det korrekta blocket är 114 25 5 88 102. HPDFDataMatrixTestComputeEC exponerar klassfunktionen bakom {$IFDEF HPDF_TESTING}-grinden, så fixturen asserterar de fem värdena utan att instansiera en encoderare eller rendera en sida. Galoisfältet i sig, byggt av InitDMTables över primitivt polynom $12D in i DMExp- och DMLog-tabellerna, var korrekt hela tiden, vilket är precis varför buggen gömde sig så väl
PDF417 dividerar över ett primfält, där tecken spelar roll
PDF417 behövde fyra ändringar i stället för en, för GF(929) är ett primfält och inte ett binärt extension-fält: addition är inte xor, subtraktion är inte addition, och tecknet på varje generatorfaktor är riktig aritmetik snarare än notation. Varje faktor måste vara (x - 3^i), vilket i kod betyder att multiplicera med 929 - GF929Pow(3, I); reduceringssteget måste subtrahera; rötterna går från 3^1 enligt ISO/IEC 15438 §5.5; och Factor måste läsas in i en lokal variabel innan den inre loopen kör, för J = 0-passet skriver Work[I] och skulle annars ändra multiplikatorn under sig själv. HPDFPDF417TestComputeEC spikar det korrigerade resultatet: codeorden 5 453 178 121 239 med fyra felkorrigeringsord ger 452 327 657 619
// THPDFPDF417.ComputeEC i HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // faktorn är (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // läs in: J = 0 skriver om Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Data Matrix-findern installerades ut och in
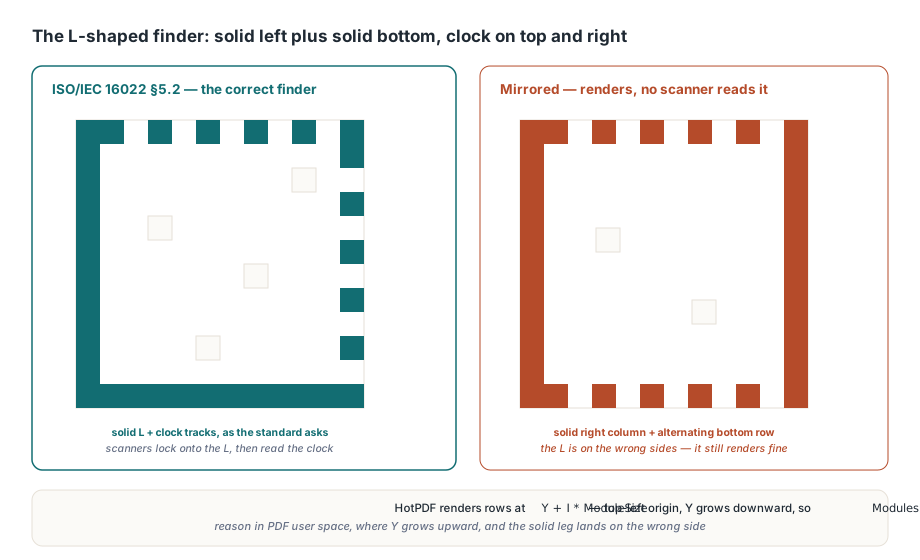
Korrekta checkord räddar inte en symbol vars finder-mönster är spegelvänt, och samma utgåva fick fixa även det. Placeringskoden ritade en hel vänsterkolumn, en hel högerkolumn och alternerande moduler längs över- och nedersta raden, medan ISO/IEC 16022 §5.2 kräver en hel vänsterkolumn plus en hel nedersta rad, den L-formade findern, med det alternerande klockspåret längs översta raden och högerkolumnen. Det som gör det lätt att få bakvänt är koordinatkonventionen: HotPDF renderar modulrader vid Y + I * ModuleSize, vilket är top-left-originsemantik, så Modules[Size - 1, *] är den tryckta symbolens nedersta rad. Den som resonerar i PDF-user space, där Y växer uppåt, sätter det heldragna benet på fel sida och ser ingenting misstänkt på skärmen
Varför klarade fyra trasiga encoderare testerna i åratal?
För att testerna asserterade struktur och felen satt i aritmetiken. De befintliga QR-, Data Matrix- och Aztec-fallen kontrollerade finder-moduler, timing-mönster och symboldimensioner, som alla verkligen var korrekta; inget test hade någonsin jämfört ett checkord mot en publicerad vektor. Den andra anledningen generaliserar längre. HotPDF levererar en inbyggd QR-avkodare, och att använda den för att validera encoderaren känns som en uppenbar round trip, förutom att den här avkodaren läser data-codeord och utför ingen Reed-Solomon-korrigering, så den läste tillbaka exakt vad encoderaren skrev och rapporterade framgång. När en encoderare och en avkodare delar ett antagande bevisar ett round-trip-test att de håller med varandra, inte att någon av dem har rätt. En felkorrigerande kod måste valideras mot vektorer tryckta i standarden, aldrig mot din egen avkodare. Fixturen THPDFBarcodeECCTests har nu ett test per format, varje namngivet efter vad det spikar, och varje når aritmetiken genom en krok som bara kompileras under {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleasserterar de tio checkorden i version 1-M byte-mode-exempletDataMatrixCheckWordsMatchISO16022Exampleasserterar 114 25 5 88 102 för codeorden 142 164 186PDF417CheckWordsMatchGF929Referenceasserterar 452 327 657 619 över GF(929) med rötter 3^1 till 3^4AztecCheckWordsKeepMessageAndMatchReferenceasserterar checkorden och att meddelandeorden överlever divisionen på plats
Fyra frågor fångar det mesta av den här familjen i vilken encoderare du än underhåller. Matchar din generators lagringsordning din divisionsindexordning, och kan du peka på raden som bevisar det? Börjar rötterna där standarden säger, α^1 för Data Matrix och 3^1 för PDF417? Återställer en division på plats meddelanderegionen efteråt? Jämför minst ett test checkord, snarare än modulantal, mot ett nummer tryckt i en specifikation? Omfattningen spelar också roll när du bestämmer vad du ska göra med befintliga artefakter. Symboler genererade före v2.748.0 renderas och scannar ofta under ideala förhållanden, för en ren bild behöver ingen korrigering för att läsas; det de förlorat är skadetoleransen som är hela anledningen att välja dessa format. Långlivade etiketter och arkiverade dokument som bär påverkade symboler är värda att regenerera snarare än att stickprovskontrollera med en telefonkamera. Encoderarna finns i streckkodsstödet i HotPDF, tillsammans med QR-avkodningsvägen och dess orienteringshantering och rapportutmatningslagret som placerar symboler på en sida; den fullständiga barcode-API-referensen följer med HotPDF Delphi Component för Delphi och C++Builder