En parser hänger sig på en felaktig PDF när någon gren läser en byte, vägrar hantera den och återvänder utan att flytta markören. Den anropande loopen ser varken framsteg eller något skäl att sluta, så den snurrar i all evighet. HotPDF släppte exakt det felet i tre oberoende parsrar, alla nåbara från indata på under femtio byte
Det här är en denial-of-service-klass värd att namnge separat, för den ser inte ut som den alla redan skyddar sig mot. Ingen dekomprimering, ingen växande allokering, inget minnestryck som kan utlösa en watchdog. Processen bara sitter på hundra procents CPU på en kärna med en handfull byte i en buffert. Lägger du till en avkodningsbudget efter att ha läst om kapslad filteramplifiering och PDF-bomber kommer budgeten inte att lösa ut här: ingenting avkodas och ingenting allokeras. Olika fel, olika fixar
Varför kostar en fyrtiabytefil mer än en dekompressionsbomb?
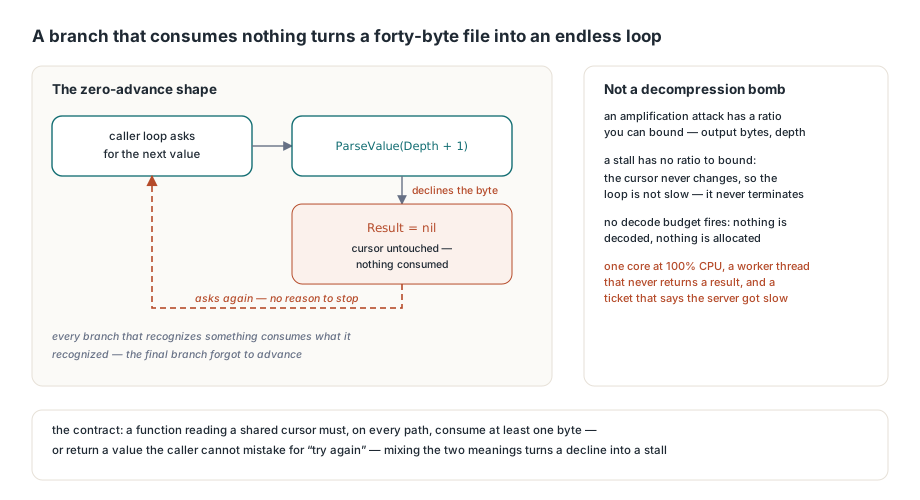
För kostnaden har över huvud taget inget med indatastorleken att göra. En amplifieringsattack har ett förhållande du kan begränsa: sätt ett tak på utbytena, sätt ett tak på rekursionsdjupet, och värsta fallet blir ändligt. En zero-advance-loop har inget förhållande att begränsa. Loopvillkoret är en funktion av en markör som aldrig ändras, så den är inte långsam, den terminerar inte, och ingen storleksbaserad gräns längre upp kommer att fånga den. Det gör den också unikt besvärlig operativt. En krasch ger dig en stack, ett slut på minnet ger dig en loggrad, och en fastnad parser ger dig en worker-tråd som aldrig returnerar ett resultat, en request som aldrig time-outar för att ingenting nedströms vet att den startade, och en biljett som säger att servern blev långsam i tisdags. Den strukturella orsaken har alltid samma form. En tokenizer eller värdeparser har en kedja av grenar som nycklas på aktuell byte. Varje gren som känner igen något förbrukar det den kände igen. Sedan finns en sista gren, eller en guard före kedjan, som returnerar för de byte ingen gjorde anspråk på, och författaren resonerar om den som en felväg snarare än ett skanningssteg. Felvägar returnerar. Skanningssteg avancerar. När en funktion måste vara båda är det avanceringen som glöms bort
Objektparsern: två avgränsare ingen förbrukade
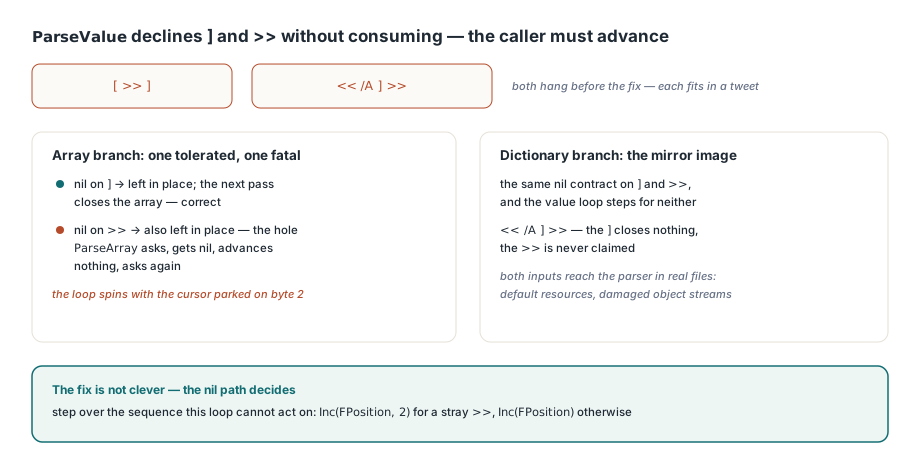
I HPDFParser börjar metoden THPDFSpanObjectParser.ParseValue med att rakt av avböja två bytessekvenser. Enligt ISO 32000-1, avsnitt 7.3, kan ett värde inte börja med ] eller >>, eftersom de stänger en behållare snarare än öppnar ett värde, så ParseValue returnerar nil för båda utan att förbruka dem. Det är det korrekta kontraktet, och det lägger hela bördan av att avancera på den anropande parten. Arraygrenen hedrade hälften av det: vid ett nil-resultat kontrollerade den ], lämnade den på plats för nästa varv att stänga arrayen, och klev över allt annat — förutom att kontrollen råkat vara skriven så att ett förryckt >> också lämnades på plats. Så [ >> ] hänger, för ParseArray ber om ett värde, får nil, avancerar ingenting och frågar igen. Ordbokgrenen hade hålet i spegelvänd form, och << /A ] >> hänger på samma sätt. Båda indata är giltiga nog att nå parsern och korta nog att få plats i en tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Innan fixen returnerade inget av anropen nedan
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Fixen är inte genial, och det är poängen: nil-vägen måste uttryckligen avgöra vilken av de två oförbrukade sekvenserna den aktuella loopen kan agera på, och kliva över den andra
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue returnerar nil för både ']' och '>>' utan att förbruka
  // dem. ']' avslutar arrayen nästa varv, men ett förryckt '>>'
  // inuti en array måste klivas över annars avancerar parsningen aldrig
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
En sak till förtjänar uppmärksamhet här. THPDFSpanObjectParser.RecordError ökar bara ErrorCount i THPDFParserViewStatistics; det sätter inget tak. Parsern sätter HPDFParserMaximumDepth till 64 för att begränsa nästlandet, men har ingen motsvarande gräns på antalet fel, och en räknare ingen någonsin läser är en missad circuit breaker. Även med avanceringen återställd kommer en indata som producerar ett fel per byte att tugga sig igenom ett stort objekt i en takt som förtjänar en tidig exit snarare än en fullständig genomgång. Kontrollera Valid på statistikposten efter varje parsning och behandla ett stort ErrorCount som ett skäl att sluta lita på objektet, inte bara som en diagnostik
Samma form i CMap-tokenizern och XFDF-läsaren
HPDFCMapReader.NextToken bar samma fel i sin fallback-gren. Funktionen returnerar en TCMapTok och hanterar <, ( och / i dedikerade grenar; allt annat ramlar igenom till "läs tills blanktecken eller avgränsare". När startbyten själv är en avgränsare från mängden i ISO 32000-1, avsnitt 7.2.2, körs den loopen noll gånger, token kommer tillbaka tom, och den anropande parten ber om samma token igen. Av de sex tecken som kan hamna där fångades bara [ upp tidigare av bfrange-hanteringen, så ett förryckt ), >, ], { eller } någonstans i en ToUnicode-CMap räckte för att stoppa textextraheringen
// nyckelord eller tal: läs tills blanktecken eller avgränsare
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// En avgränsare ingen av grenarna ovan gör anspråk på (ett förryckt ')', '>',
// '[', ']', '{' eller '}') skulle lämna P där den var och returnera en
// tom nyckelord, så den anropande parten skulle be om samma token i all evighet
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
XFDF-sidan hade en variant med annat ursprung och samma effekt. HPDFXFDFXml.ParseElement sätter Result := P överst, medan P fortfarande pekar på den öppnande <, och ökar först därefter sin lokala markör, så varje tidig exit som följer returnerar ingångspositionen om den inte skriver över Result först. En doctype-deklaration enligt XML 1.0, avsnitt 2.8, eller vad som helst annat utan ett parsningsbart taggnamn som <1a>, tog en exit som aldrig uppdaterade Result, och barnelementloopen fick tillbaka den position den själv hade skickat in. Attributloopen hade ytterligare tre sådana, eftersom ReadName, blankteckenhoppet och =-hanteringen alla avböjer en byte som varken är ett namntecken, blanktecken eller något av =, >, /, och ingen av dem förbrukade den. Den närliggande CDATA-reparationen flyttade ett ansvar snarare än lade till en guard: en CDATA-sektion enligt XML 1.0, avsnitt 2.7, börjar med <, så barnloopen brukade lämna den till ParseElement, som sedan läste ett taggnamn ur sektionens innehåll. Att känna igen den i barnloopen med IsCDATAStart och kopiera byte till textbufferten tills IsCDATAEnd är rätt arbetsfördelning, och det gamla hoppet var också en byte för kort, eftersom markören är åtta byte räknat från !
Deklarerade antal som överlever datan
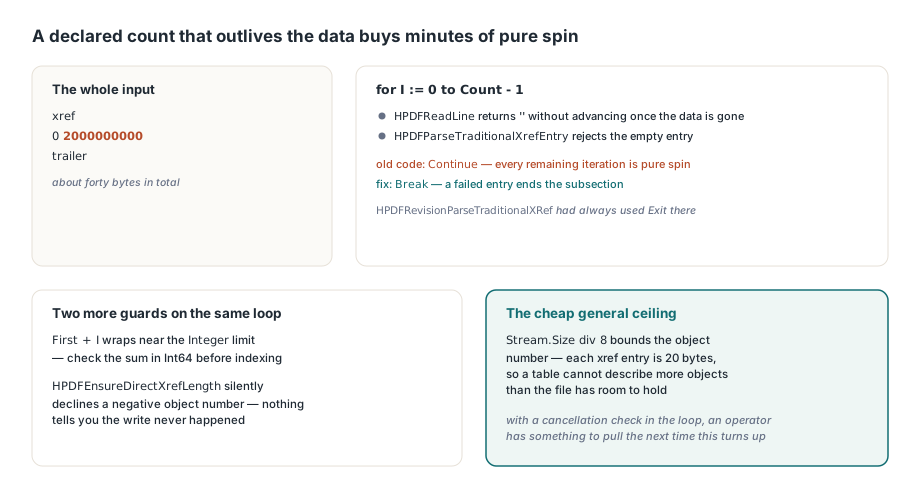
En senare utgåva blottade samma mönster från motsatt håll, och det är varianten som mest sannolikt finns i din egen kod. En rubrik för en cross-reference-subsektion enligt ISO 32000-1, avsnitt 7.5.4, är ett first count-par, och båda HotPDF:s traditional-xref-parsrar loopade for I := 0 to Count - 1 över den, med Continue i stället för Break när en post misslyckades att parsas. Det låter som tolerans för en trasig rad. Det är det inte: HPDFReadLine returnerar en tom sträng utan att avancera när datan är slut, och HPDFParseTraditionalXrefEntry avvisar en tom post omedelbart, så varje återstående iteration av det deklarerade antalet är ren spin. Aritmetiken är obarmhärtig — rubriken xref\n0 2000000000\ntrailer plus ett minimalt hölje är ungefär fyrtio byte, och det köper tiotals sekunder av en upptagen kärna utan någon avbrytningskontroll någonstans i loopen. Spåret satt i samma enhet, för HPDFRevisionParseTraditionalXRef hade alltid använt Exit i den positionen. När två funktioner parsar samma grammatik och inte håller med varandra om huruvida en misslyckad post avslutar subsektionen, är en av dem en fork som slutade få fixarna, samma signatur som dyker upp i hybridhanteringen av cross-reference där en traditionell tabell och en ström beskriver samma objekt
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Ett deklarerat antal större än tabellen skulle annars snurra
  // här utan data kvar att läsa
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First kommer från subsektionsrubriken, så summan slår runt för en
  // deklarerad start nära Integer-gränsen, och tillväxthjälparen
  // vägrar tyst ett negativt index
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... registrera posten ...
end;
De två gränserna efter Break hör till samma reparation. HPDFEnsureDirectXrefLength vägrar växa arrayen för ett negativt objektnummer utan att säga något, och First + I slår runt för en deklarerad start nära Integer-gränsen, så ett negativt index når skrivningarna nedanför. Taket på objektnummer med Stream.Size div 8 är det billiga generella svaret, för ingen traditionell cross-reference-tabell kan beskriva fler objekt än filen har plats för, och varje rubrik som påstår något annat beskriver en fil som inte existerar. Reparerar du en skadad tabell för hand gäller samma resonemang från andra hållet, vilket är det område som täcks i noterna om att diagnostisera och reparera handredigerade PDF:er
Hur bevisar du att en hang-fix faktiskt fungerar?
Genom att köra den gamla koden, inte genom att läsa om den. En stall är en av de få felklasser där en fix kan verifieras med en binär signal utan instrumentering, för processen returnerar antingen eller så gör den inte det, och att resonera om kontrollflöde är precis den färdighet som skapade buggen från början. Mekaniken är värd att kopiera. Extrahera pre-fix-revisionen av de ändrade enheterna till en scratch-katalog, kompilera sedan en liten probe med enhetssökvägen som lägger den katalogen före det riktiga biblioteket: dcc32 -U<scratchdir>;<Lib> probe.dpr. Kompilatorn tar de gamla källorna för det den hittar först och de aktuella källorna för allt annat, så en enda probe-binary kör den gamla parsern mot resten av biblioteket. Kör den under en timeout — fyrtio sekunder är generöst — och behandla exit-kod 124 som assertionen. Dra sedan tillbaka enheterna ur scratch-katalogen en i taget och bygg om. Alla tre stallarna reproducerades på det här sättet, var och en hänförbar till en specifik enhet, och alla tre returnerade så snart den fixade källan var tillbaka i sökvägen, till en kostnad av en kompilering per enhet
Två fällor är värda att känna till innan du provar. Enhetssökvägen är tyst tillåtande: ger du -U en Unix-stilad sökväg från ett skal, som $PWD, ignorerar kompilatorn den katalogen utan ett ord, vilket betyder att din probe kompilerades mot de aktuella källorna och klarade sig av fel anledning. Konvertera sökvägen till nativ Windows-form först. Den andra är att scratch-katalogen inte bär med sig include-filerna, så du behöver också -I<Lib> för HotPDF.inc, annars misslyckas bygget på ett sätt som ser ut som ett källproblem snarare än ett sökvägsproblem. Och var ärlig med vad metoden inte ger dig: den bekräftar att en specifik indata slutade hänga på en specifik byggversion, och säger ingenting om de indata du inte tänkte på. Zero-advance-fel hittas genom fuzzing eller genom att läsa varje gren i varje tokenizer, inte genom regressionstester skrivna i efterhand
Vad du ska granska i dina egna parsrar
Den återanvändbara regeln är ett kontrakt, inte en checklistepunkt. Varje funktion som läser från en delad markör måste, på varje väg inklusive sina felvägar, antingen förbruka minst en byte eller returnera ett värde den anropande parten inte kan missta för "försök igen". Att blanda de två betydelserna i ett enda nil eller en enda tom token är det som gör en avböjning till en stall. Granska alltså formen snarare än symptomet. Hitta varje loop vars terminering beror på en markör en annan funktion äger, och fråga vad som händer när den funktionen vägrar den aktuella byten. Hitta varje fallback-gren skriven som "läs tills X" och fråga vad den gör när markören redan sitter på X. Hitta varje loop som begränsas av ett antal som kom ur filen snarare än ur datan, och låt ett misslyckat element avsluta loopen i stället för att hoppa över en iteration. Där samma grammatik parsas på två ställen, diffa dem, för en av dem kommer ha fått en fix den andra inte fick. Och lägg en avbrytningskontroll i varje loop som kan köra ett anropsspecificerat antal iterationer, så att en operatör har något att dra i när nästa sådan dyker upp i produktion
Parsrarna som beskrivs här finns i den aktuella HotPDF Delphi Component för Delphi och C++Builder, med statistikposterna och djupgränserna exponerade så att din egen härdning kan bygga på dem