HotPDF kan spara ett inläst dokument i en diagnostisk form avsedd att läsas och redigeras av en människa, och sedan reparera filen efter att du har redigerat den. SaveLoadedDocumentDiagnostic skriver dokumentet med deterministisk ordlisteordning, varje objekt som ett vanligt indirekt objekt, inga objektströmmar, ingen korsreferensström och ingen linjärisering. RepairDiagnosticDocument återuppbygger sedan byteoffseten, strömlängderna, korsreferenstabellen och trailern som din redigering ogiltigförklarade
Detta par existerar för ett arbetsflöde: att förstå eller fixa vad som faktiskt finns inuti en PDF. Varje utvecklare som har felsökt ett renderingsproblem har velat öppna filen, ändra en siffra i en ordlista, och titta på resultatet. I en normal PDF är det omöjligt, eftersom innehållet är komprimerat till objektströmmar och varje byte du infogar förskjuter offset som en korsreferenstabell registrerar exakt
Vad skiljer en diagnostisk sparning?
Sex inställningar ändras tillsammans. Ordlistenycklar skrivs i deterministisk ordning, så två sparningar av samma dokument ger jämförbara filer. Diagnostiskt utdataläge annoterar strukturen. Fullständig omskrivning tvingas fram, så ingenting förs över som en orörd inkrementell revision. Linjärisering är avstängd, eftersom en linjäriserad fil är organiserad för en webbvisare snarare än för en läsare. Korsreferensströmmar är avstängda, så tabellen är ren text. Och objektströmmar är avstängda, så inget objekt döljs inuti en komprimerad behållare
Resultatet är en fil vars sidhuvud bär en diagnostisk markör vid sidan av den vanliga %PDF--signaturen, och vars kropp du kan bläddra genom i valfri redigerare. Objekt visas ett efter ett, ordlistor är läsbara, och innehållsströmmar ligger där du kan hitta dem. Reparationsverktyget kontrollerar efter den markören och avvisar filer som saknar den, eftersom en normal PDF-fils kompakta struktur inte är något en byteintervallreparatör bör försöka tolka

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Läsbar, ett objekt per block, ingenting dolt i objektströmmar
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Varför förstör redigering filen, och vad måste återuppbyggas?
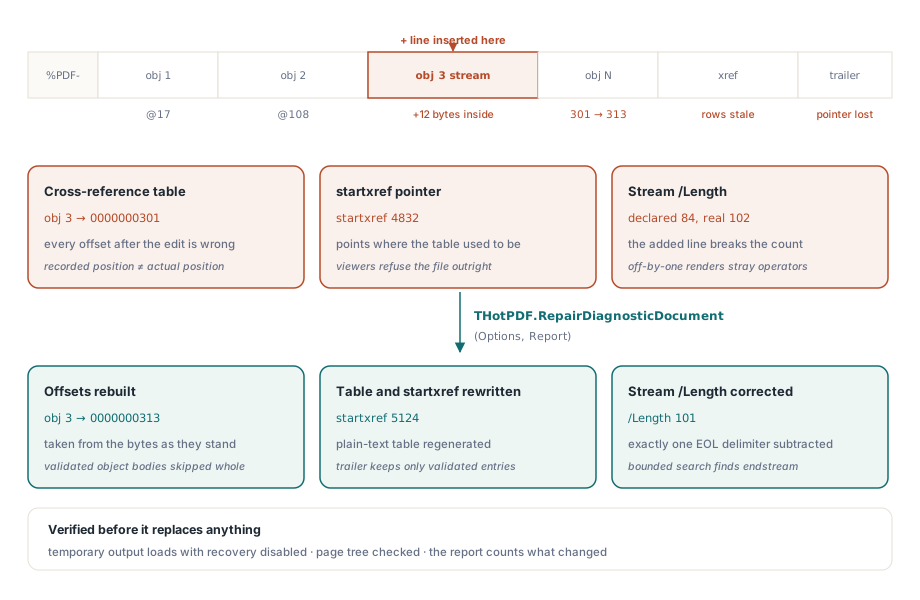
Tre saker i en PDF kodar byteplaceringar eller byteantal. Korsreferenstabellen mappar varje objektnummer till ett byteoffset. Värdet startxref i slutet av filen pekar mot tabellen. Och varje strömordlista bär en /Length som anger hur många byte strömkroppen upptar
Ändra ett tecken var som helst före filens slut och offseten efter det blir fel. Lägg till en rad i en innehållsström och dess /Length blir också fel. De flesta visare kommer att vägra filen, och de som återställer den gör det genom skanning, vilket döljer misstaget snarare än att åtgärda det. Reparation återuppbygger alla tre utifrån vad byten faktiskt nu säger
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // ladda resultatet innan det ersätts

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Kopiera byte, omserialisera inte
Designbeslutet som gör detta verktyg pålitligt är att det aldrig laddar dokumentet och skriver ut det på nytt. Det kopierar byteintervallen för objekt det har validerat, ändrar bara de /Length-värden som är fel, och återuppbygger tabellen, trailern och startxref runt dem
Att ladda och omserialisera skulle vara betydligt enklare att implementera och skulle tyst ändra saker. Okänd objektsyntax skulle normaliseras, strängundantag skulle skrivas om i skrivarens föredragna form, och redan kodade strömdata skulle kunna kodas om. För ett felsökningsverktyg är det oacceptabelt: du redigerade en siffra, och diffen bör visa en siffra, inte tusen tillfälliga formateringsändringar. Om du vill veta exakt vad som ändrats mellan två filer är det ett jämförelseproblem, som täcks i att jämföra två PDF-filer efter struktur och pixlar

De två parsningsreglerna som förhindrar falska objekt
En byteintervallskanner möter en uppenbar fälla: text som ser ut som ett objektsidhuvud kan förekomma inuti en strömlast eller inuti en sträng. En naiv skanning skulle avge en korsreferensrad som pekar in i mitten av en innehållsström, och den resulterande filen skulle vara trasig på ett nytt och mer förvirrande sätt
HotPDF undviker detta genom att hoppa över hela byteintervallet för varje validerat objekt, med hjälp av dess registrerade slutoffset, så att ingenting inuti en objektkropp någonsin betraktas som en kandidat. Mellan objekt tillåts bara PDF-blanktecken och kommentarer; allt annat betyder att regionen inte är förstådd och dess byte får inte dras in i utdata
Strömlängder kräver lika stor omsorg. Den verkliga lastlängden exkluderar radslutsavgränsaren som en skrivare infogar före endstream. När den deklarerade längden landar exakt på markören accepteras den deklarationen. När den inte gör det utför reparatören en begränsad sökning efter paret endstream och endobj och subtraherar exakt en avgränsare, ett CR, ett LF eller ett CRLF. Att göra detta fel med en byte ger en fil som öppnas och renderar en sida med en vilsen operator i slutet av sin innehållsström
Vad trailern får behålla
Den återuppbyggda trailern är inte en kopia av den gamla. /Size, /Prev och /XRefStm beskriver alla den tidigare fillayouten och beräknas om eller släpps. Endast poster vars mål har validerats överlever: /Info, /ID och /Encrypt. Och /Root måste lösas till exakt ett Catalog-objekt — inte noll, och inte flera, vilket är vad en fil sammansatt genom att klippa ihop objektblock brukar producera
Utdatasäkerhet hanteras på det sätt det bör för ett verktyg som körs mot filer folk bryr sig om. Resultatet skrivs till en temporär fil i målkatalogen, verifieras sedan genom att laddas via den normala vägen med korsreferensåterställning avstängd, så att en fil som bara öppnas tack vare återställning räknas som ett misslyckande. Först efter att sidträdet verifierats ersätter den temporära filen atomärt målet. En misslyckad reparation skriver aldrig över en befintlig utdatafil
Budgetar och ärliga felkoder
Tre gränser begränsar arbetet: indatabyte, kandidatobjektantal och maximalt objektnummer, som standard 8 GiB, två miljoner respektive två miljoner. Objektnummertaket spelar större roll än det verkar, eftersom en gles tabell med några få objekt numrerade i miljarder annars skulle blåsa upp den återuppbyggda korsreferenstabellen enormt. Klassiska korsreferenstabeller avvisar också offset som skulle behöva mer än tio decimalsiffror, vilket är en formatbegränsning snarare än ett implementationsval
Misslyckanden rapporterar en specifik status snarare än ett booleskt värde: ogiltiga argument, källan för stor, ingen diagnostisk fil, objektgräns överskriden, ogiltigt objekt, dubblerat objekt, saknad katalog, ogiltig trailer, utdatafel, eller validering misslyckades. Var och en motsvarar en annan åtgärd. Ett dubblerat objekt betyder att du klistrade in ett objektblock två gånger. En saknad katalog betyder vanligtvis att objektet som håller /Type /Catalog skadades. Validering misslyckades betyder att strukturen nu är konsekvent men att sidträdet inte laddas, vilket vanligtvis är en /Kids-array redigerad utan att matcha sin /Count
Två praktiska anmärkningar sluter cirkeln. Behåll den diagnostiska filen, inte bara den reparerade, så att nästa redigering startar från en läsbar bas. Och skicka inte diagnostisk utdata till slutanvändare: den är större än en normal sparning eftersom ingenting komprimeras till objektströmmar, och produktionsvägen för en kompakt fil är den vanliga sparvägen som beskrivs i objektströmmar och inkrementella uppdateringar. När målet är att hitta vad som är fel snarare än att ändra det, svarar den automatiserade vägen i automatisering av preflight-rapporter snabbare än att läsa byte
Diagnostisk sparning, reparation, preflight och jämförelse arbetar alla på samma inlästa dokumentmodell i Delphi och C++Builder; den fullständiga funktionslistan finns på HotPDF Delphi PDF-komponentsidan