PDFlibPas, losLabs PDF Library for Delphi, vandrar genom PDF name trees och number trees med en explicit stack och en besökmängd sedan v3.539.45, så cykliska /Kids, delade barn och träd tusentals nivåer djupa tömmer inte längre anropsstacken eller duplicerar poster. Sedan v3.539.51 gömmer ett saknat, felformat eller omvänt /Limits-par aldrig en gren som håller nyckeln. Namngivna destinationer, sidetiketter, bilagor och dokumentnivå-JavaScript läser alla genom de här två kodvägarna, vilket gör dem till en del av attackytan hos varje PDF du inte framställt själv
Utlösaren är sällan exotisk. En fuzzer, en fientlig uppladdning eller en buggig inkrementell sparning skriver en /Kids-post som pekar tillbaka på en förfader, och en rekursiv vandrare dör med ett stack overflow på en tvåkilobytefil. Det tystare felet är en uppslagning som litar på en trasig /Limits-array och rapporterar "not found" för en destination som tydligt finns där
Var dyker name trees och number trees upp i en PDF?
Name trees och number trees dyker upp varhelst en PDF mappar en stor mängd nycklar till objekt, och PDFlibPas läser minst fyra av dem via publika API:er. ISO 32000-1 §7.9.6 definierar name tree (strängnycklar, Table 36) och §7.9.7 number tree (heltalsnycklar, Table 37). Båda är någorlunda balanserade träd vars rot- och mellanliggande noder bär /Kids, vars löv bär de sorterade nyckel/värde-paren i /Names eller /Nums, och vars icke-rotnoder bär en tvåelement-/Limits-array med den minsta och största nyckeln under dem
| Träd | Var den bor | Specifikation | PDFlibPas läs-API |
|---|---|---|---|
| Namngivna destinationer | /Dests i name dictionary | §12.3.2.3 | GetNamedDestination, sedan GetDestPage / GetDestType |
| Sidetiketter | /PageLabels i katalogen (number tree) | §12.4.2 | GetPageLabel |
| Bilagor | /EmbeddedFiles i name dictionary | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| Dokumentnivå-JavaScript | /JavaScript i name dictionary | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Två detaljer i den tabellen är lätta att missa. Namngivna destinationer har också en äldre PDF 1.1-form, en vanlig /Dests-ordbok i katalogen nycklad med name-objekt, och GetNamedDestination kontrollerar den ordboken först innan den stiger ner i PDF 1.2 name tree. Och GetDocJavaScript är inte alls en name tree-läsare: den returnerar skripten fästade vid dokumentutlösare i katalogens /AA-ordbok (WS, DS, WP, DP, DC), medan de namngivna skriptpaketen som körs när ett dokument öppnas bor i /JavaScript name tree
Varje byte av de strukturerna kommer från filen. Specifikationen säger vad en skrivare ska framställa; den kan inte hindra en läsare från att få något annat, vilket är samma lärdom bakom att härda en Pascal PDF-parser mot fientliga filer, tillämpad här på trädform i stället för buffertstorlekar
Varför kraschar en cyklisk /Kids-array en rekursiv trädvandrare?
En cyklisk /Kids-array kraschar en rekursiv vandrare för att inget i rekursionen noterar att den sett noden förut, så ett barn som refererar sin egen förfader gör en ändlig fil till en oändlig nedstigning. Före v3.539.45 anropade NameTreeLookup, NumTreeLookup, EnumNumTree och interna TPDFNameTree.ProcessNode alla sig själva en gång per barn. En enda självreferens räckte för att avsluta processen, och ett legitimt men mycket djupt träd kunde göra samma sak utan någon cykel alls
En mildare variant förstör resultat i stället för att krascha. När två /Kids-poster refererar samma löv besöker en naiv uppräkning det två gånger, och ett bilageantal eller en lista av skriptpaket rapporterar poster som inte finns
Fixen byter rekursionen mot en explicit sist-in, först-ut-stack på heapen och en besökmängd nycklad efter ordboksidentitet. En nod markeras när den poppas, inte när den pushas, så en cyklisk referens kan sitta på stacken en kort stund men kastas i ögonblicket den kommer upp igen. Varje distinkt nod expanderar sina barn exakt en gång, vilket begränsar det totala arbetet med antalet distinkta ordböcker plus den totala längden av deras /Kids-arrayer. Djupet slutar spela roll: en kedja på 4 096 nivåer är bara 4 096 iterationer av en loop och 4 096 poster i en hashmängd
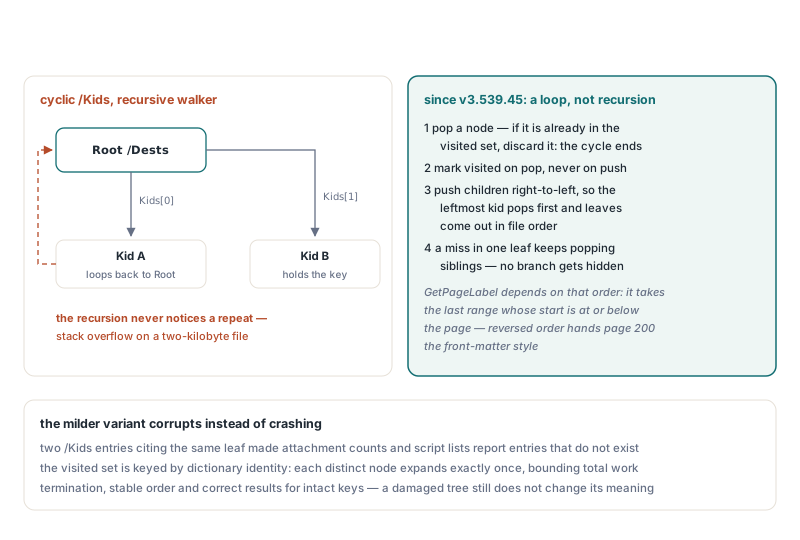
Ordningen spelar fortfarande roll dock, och stacken måste matas baklänges för att bevara den. Barnen pushas från sista index ner till första, så vänsterbarnet poppas först och löven kommer ut i samma vänster-till-höger-ordning som producenten skrev. GetPageLabel beror på det: den går igenom varje uppräknat intervall och tillämpar det sista vars startindex ligger på eller under sidan, så att vända uppräkningen tyst skulle ge sida 200 delmateriestilen. Skelettet nedan visar mönstret på en abstrakt nodtyp, oberoende av varje PDF-objektmodell
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // tomt på ett löv
    Keys: TArray<string>;      // lövnycklar, sorterade av en välskött producent
    Values: TArray<Integer>;   // parallellt med Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits är en ledtråd: bara ett välbildat, ordnat par får beskära en gren
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // cykel eller delat barn: sett det
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Pusha höger till vänster så vänsterbarnet poppas först
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // En miss i detta löv är inte en dom: fortsätt poppa syskon
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Varför kan en uppslagning inte stanna vid första matchande gren?
En uppslagning kan inte stanna vid första gren vars intervall matchar, för /Limits-intervall i en riktig fil kan överlappa eller ljuga, och grenen som utger sig ha nyckeln är inte nödvändigtvis grenen som håller den. Uppslagningarna före v3.539.45 satte en Found-flagga på första barn vars /Limits täckte nyckeln, steg ner i det, och tittade aldrig på ett annat syskon. Viste sig det barnet vara tomt, inaktuellt eller en loop tillbaka till roten var svaret nil, även när alldeles nästa syskon höll nyckeln
Den omskrivna FindTreeValue, som nu bär upp både NameTreeLookup och NumTreeLookup, pushar varje barn vars intervall inte utesluter nyckeln och fortsätter poppa tills den hittar en träff eller tömmer stacken. En miss inuti ett löv är bara en miss inuti ett löv. I ett välbildat träd kostar det inget extra; i ett skadat kostar det några fler nodbesök och returnerar rätt svar
Lövsökningen följer samma filosofi. ISO 32000-1 kräver att nycklarna i en /Names-array är sorterade efter bytevärde, så lövet söks först med en binärsökning. Misslyckas den faller PDFlibPas tillbaka till en linjär genomsökning av paren, för ett löv i fel ordning skulle annars göra en befintlig nyckel osynlig. Sortering är en snabbväg, inte ett filter
Uppslagningen vägrar också gissa vid en strukturell motsägelse. Table 36 låter en nod bära antingen /Kids eller /Names, aldrig båda, och uppslagningsvägen behandlar en nod som bär båda som felformad och hoppar över den i stället för att välja en tolkning. Uppräkningsvägar som EnumNumTree är mer tillmötesgående och följer /Kids när båda finns
Vad får en läsare lita på /Limits för?
En läsare får lita på /Limits bara för att hoppa över arbete, aldrig för att avgöra att en nyckel saknas, och bara när paret är välbildat. Table 36 säger att mellanliggande noder och löv ska bära /Limits som en tvåelement-array av den minsta och största nyckeln, men i praktiken försvinner posten efter handredigeringar, håller tal i en name tree, eller anländer med sina gränser ombytta. PDFlibPas v3.539.45 och v3.539.51 avgör vart fall på samma sätt: kan inte intervallet läsas som ett ordnat par av rätt typ förblir barnet sökbart
- Saknad
/Limits: den gamla intervallkontrollen returnerade False och barnet hoppades över rakt av, så en producent som glömde posten gjorde sitt hela subträd onåbart. Sedan v3.539.45 söks barnet - Fel typ eller fel längd, som tal i en name tree eller en array med ett element: behandlas exakt som en saknad post sedan v3.539.45
- Omvända gränser som
[(Z) (A)]eller[9 0]: v3.539.45 använde dem fortfarande, och ingen nyckel kan uppfyllaLo <= Key <= HinärLo > Hi, så grenen uteslöts för varje uppslagning. Sedan v3.539.51 används ett intervall för beskärning bara när dess undre gräns inte överstiger dess övre - Välbildat, ordnat och korrekt: används för att hoppa över grenen, vilket är hela poängen med posten
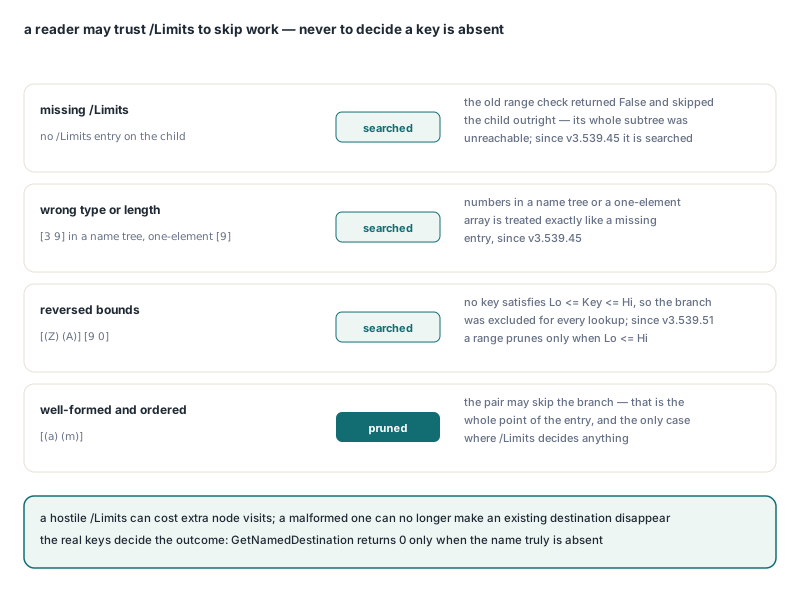
De riktiga nycklarna avgör utgången i varje fall. En fientlig /Limits kan få PDFlibPas att besöka fler noder än nödvändigt, men en felformad kan inte längre få en befintlig destination att försvinna. Från anroparens sida ändras inget: GetNamedDestination returnerar 0 när namnet verkligen saknas och ett destinations-ID annars, och destinationsfunktionerna tar det därifrån
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Katalogens /Dests (PDF 1.1) först, sedan /Dests name tree
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Körs mot en handbyggd fil vars /Dests-rot har ett barn som loopar tillbaka till roten under ett intervall [(a) (z)] och ett andra barn som håller den riktiga posten under omvända [(z) (a)]-limits löser den här proceduren destinationen till sida 2 med vytyp 2 (Fit). Före v3.539.45 returnerade samma uppslagning 0, för det loopande barnet utgav sig ha nyckeln först och sökningen nådde aldrig sitt syskon; enbart v3.539.45 returnerade fortfarande 0, för det omvända intervallet uteslöt det riktiga lövet. Läser du sedan dispositionen som pekar på de här destinationerna täcker följartikeln om att läsa PDF-bokmärkes- och annoteringsåtgärder i Delphi åtgärdssidan
Hur slog ett löv med 32 769 namn sönder TPDFNameTree?
Ett löv med 32 769 namn/värde-par slogo sönder TPDFNameTree för att dess interna FindIndex packade två tal i en 32-bitars Integer: lövets position i den interna arraylistan i de höga 16 bitarna och postoffseten inom det lövets /Names-array i de låga 16 bitarna. Varje par upptar två arrayplatser, så par nummer 32 769, parindex 32 768, börjar på offset 65 536, vilket är $10000. Det värdet släpper över i den höga halvan, och avkodaren läste tillbaka det som offset 0 i nästa löv
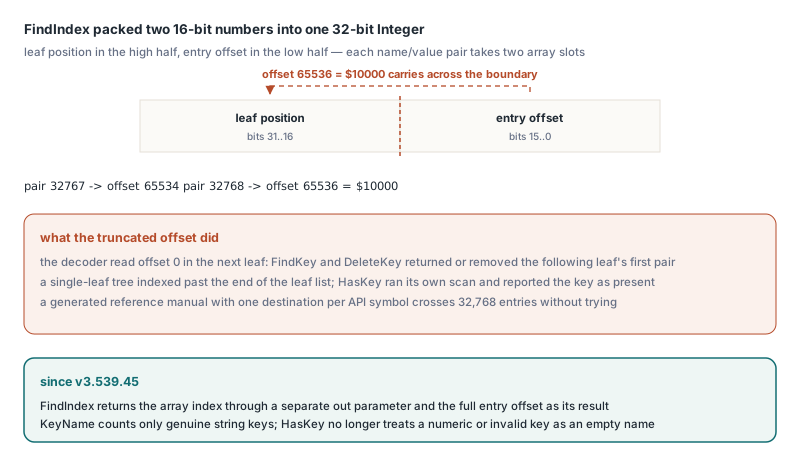
TPDFNameTree är klassen bakom bilagor, globala JavaScript-paket och skrivningar av namngivna destinationer, vilket gör konsekvenserna konkreta. I ett träd med ett enda löv finns inget nästa löv, så FindKey och DeleteKey indexerade förbi slutet av lövlistan; i ett träd med flera löv returnerade eller raderade de första paret i följande löv i stället för det begärda. Under tiden körde HasKey sin egen genomsökning och rapporterade nyckeln som befintlig, så klassen motsade sig själv. En genererad referensmanual med en namngiven destination per API-symbol passerar 32 768 poster utan ansträngning, och vissa producenter skriver alla in i ett enda platt löv
Sedan v3.539.45 returnerar FindIndex arrayindexet via en separat out-parameter och hela postoffseten som sitt resultat, så inget av värdena avkortas. Samma release åtstramade två grannar. KeyName räknar nu och returnerar bara äkta strängnycklar och returnerar en tom sträng för ett index på 0 eller under, där den tidigare castade vilket objekt som helst efter en ogiltig nyckel. HasKey behandlar inte längre en numerisk eller annars ogiltig nyckel som ett tomt namn. För ett löv som [(Valid) 42 123 456] är HasKey('') nu False och KeyName(2) returnerar en tom sträng
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // /PageLabels number tree; filer utan en returnerar vanliga sidnummer
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // /EmbeddedFiles name tree; index är 1-baserade, icke-strängnycklar hoppas
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // namn, MIME-typ
    // /JavaScript name tree: lista paketnamn, exekvera inget
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
På samma handbyggda fil, vars /PageLabels-rot listar ett löv två gånger och refererar sig själv, skriver den här granskningen ut i och A-1 för de två sidorna, varje intervall en gång, och det enskilda skriptpaketet från ett /JavaScript-träd som också pekar tillbaka på sin egen rot. Skrivsidan av sidetiketter har sin egen historia med /Kids-rötter, tagen upp i att fixa PDF-sidetiketter lagrade i /Kids number trees; AddPageLabels plattar ut en sådan rot innan infogning, och den förlitar sig på samma EnumNumTree-uppräkning som beskrivs här
Vad garanterar den här härdningen fortfarande inte?
Härdningen garanterar terminering, stabil ordning och korrekta resultat för träd vars riktiga nycklar är intakta; den gör inte att ett skadat träd betyder vad dess upphovsman avsåg. Flera begränsningar är värda att känna innan du bygger vidare på den
- Besökmängden arbetar efter objektidentitet. Två distinkta ordböcker med identiskt innehåll är två noder, så en producent som kopierar ett löv i stället för att referera det ger fortfarande dubblettposter
- Ett välbildat, ordnat men felaktigt
/Limitsbeskär fortfarande. En läsare som använder intervall som en optimering kan inte också vara immun mot ett intervall som ljuger övertygande; det enda alternativet är att ignorera/Limitshelt och genomsöka varje löv - Uppräkningen bevarar filordning men sorterar inte.
GetPageLabeltillämpar det sista uppräknade intervallet på eller under sidan, så en producent som skriver intervall i fel ordning får filordningssemantik - Minnet växer med antalet distinkta noder och poster. Traverseringen lägger till en lista och en hashmängd, inget mer, men ett name tree på 100 MB är fortfarande ett name tree på 100 MB efter tolkning
- Dubblettnycklar inuti ett löv rapporteras inte. Binärsökningen returnerar det matchande par den träffar först; den linjära fallbacken behåller sista träffen den skannar
Snabbreferens: läsa PDF-träd från opålitliga filer
- Uppgradera till v3.539.45 eller senare för cykelsäker, stacksäker traversering av name trees och number trees, och till v3.539.51 eller senare så att omvända
/Limitsinte längre gömmer nycklar - Behandla
GetNamedDestinationsom returnerar 0 som "frånvarande", ochGetDestPagesom returnerar 0 som "befintlig men oanvändbar" - Använd
GlobalJavaScriptCountochGlobalJavaScriptPackageNameför/JavaScriptname tree;GetDocJavaScriptläser katalogens/AA-utlösare i stället - Indexera bilagor och skriptpaket från 1 till antalet biblioteket rapporterar; ogiltiga nycklar räknas inte
- I din egen trädkod, markera noder besökta vid pop, pusha barn omvänt, och låt
/Limitsbeskära bara när det är ett korrekt typat, ordnat par
Förhandsverktyg, arkiverare och visare läser de här träden innan någon sida renderas, så de måste överleva vadhelst anländer i en uppladdningskö. Trädläsarna ovan medföljer PDFlibPas, PDF Library for Delphi, som byggs med både Delphi och Free Pascal