PDF Library for Delphi skriver sidetikettintervall med AddPageLabels, och sedan v3.539.10 fungerar anropet också på inlästa filer vars /PageLabels-numerträd är uppdelat i /Kids-noder: roten plattas ut till ett enda /Nums-blad innan det nya intervallet läggs in, så att etiketten faktiskt syns i viewern i stället för att tyst ignoreras. Det typiska offret är en bokliknande PDF från ett layoutverktyg, med romerska siffror i inledningen, arabiska nummer i huvudtexten och ett appendix etiketterat A-1, A-2, där du bara ville etikettera om appendixet och ingenting ändrades
Vad är PDF-sidetiketter och hur lagras de?
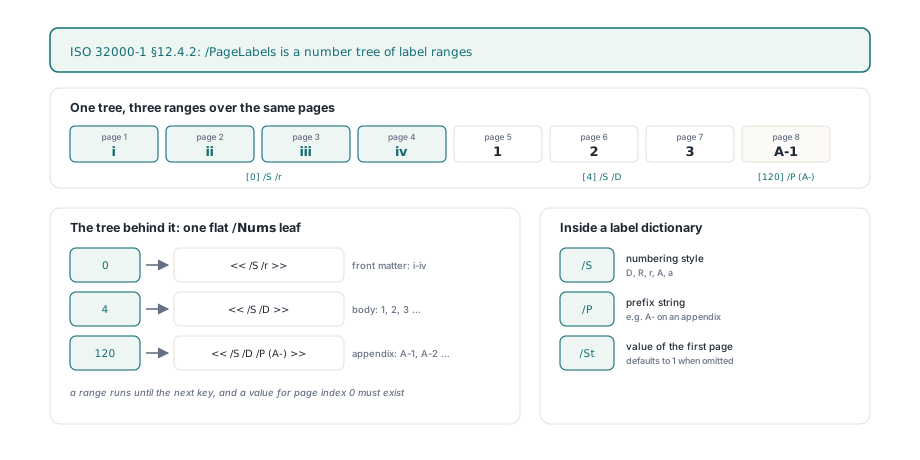
Sidetiketter är de strängar en viewer visar i sin sidruta i stället för det fysiska sidindexet, och ISO 32000-1 §12.4.2 lagrar dem som ett numerträd under katalognyckeln /PageLabels. Varje nyckel är ett 0-baserat sidindex som startar ett etikettintervall, och varje värde är en sidetikettordbok med högst tre poster: /S för numreringsstilen (D, R, r, A eller a), /P för en prefixsträng och /St för det numeriska värdet av första sidan i intervallet, som är 1 som standard. Ett intervall löper till nästa nyckel, och specifikationen kräver att trädet innehåller ett värde för sidindex 0, så varje sida täcks av något intervall
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Sidorna 1-4: i, ii, iii, iv (romerska gemener)
    Lib.AddPageLabels(1, 3, 1, '');
    // Sidorna 5-120: 1, 2, 3 ... (decimaler)
    Lib.AddPageLabels(5, 1, 1, '');
    // Sidorna 121 och framåt: A-1, A-2 ... (decimaler med prefix)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) avbildar sina argument på den ordboken utan överraskningar när du väl känner till tre regler. Start är 1-baserat som alla andra sidargument i biblioteket och skrivs in i trädet som Start - 1. Style löper från 0 till 5, där 0 betyder enbart prefix och 1 till 5 blir /S-värdena D, R, r, A och a; allt utanför det intervallet returnerar 0 och rör ingenting. Offset blir /St bara när det är större än noll, så att skicka 0 utelämnar helt enkelt nyckeln och viewern faller tillbaka på standardvärdet 1. Eftersom sidetiketter kom i PDF 1.3 kör anropet också EnsureMinVersion('1.3', '/PageLabels'), som höjer utdataversionen av en äldre fil om du inte uttryckligen låst sparversionen
Varför försvinner nya sidetiketter när trädet har /Kids?
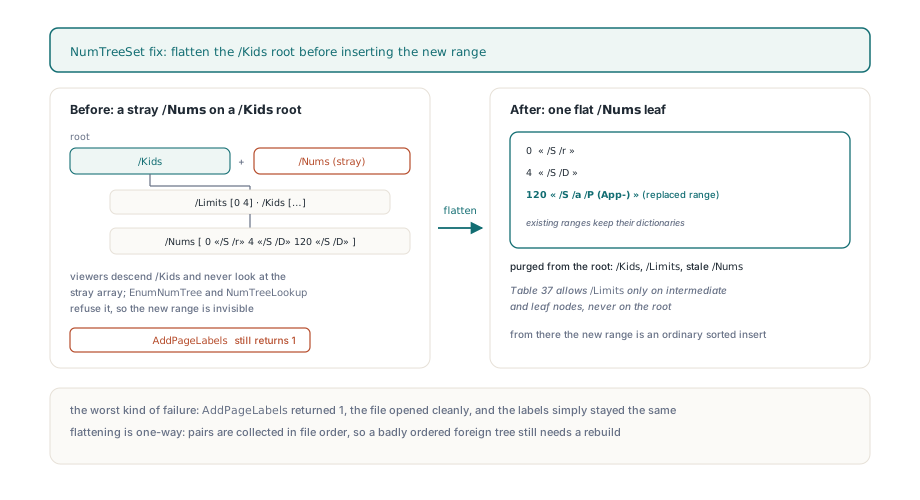
Nya etiketter försvinner för att ISO 32000-1 §7.9.7 (tabell 37) kräver att roten av ett numerträd bär antingen /Kids eller /Nums, aldrig båda, och den tidigare hjälpfunktionen NumTreeSet kunde bara leta efter /Nums. Producenter som skriver ut långa dokument delar ofta upp trädet i intermediära noder, var och en med ett /Limits-par, och hänger dem på en rot som bara har /Kids. Den gamla koden fann ingen /Nums på den roten, skapade en färsk bredvid de befintliga /Kids och lade in det nya intervallet där. Resultatet blev en rot med två ömsesidigt uteslutande ingångar. Viewers går ned genom /Kids och tittar aldrig på den vilsekomna arrayen, bibliotekets egen EnumNumTree kontrollerar också /Kids först, och NumTreeLookup vägrar en nod där HasKids xor HasNums är falskt. AddPageLabels returnerade fortfarande 1 och den sparade filen öppnades fortfarande rent, vilket är den sämsta typen av fel: ingenting klagar, etiketterna blir bara desamma
Fixen i NumTreeSet omvandlar roten till ett blad innan något läggs in. När roten bär /Kids går EnumNumTree igenom varje blad i ordning och samlar in varje nyckel- och värdepar, en ny platt /Nums-array byggs ur den listan, och /Kids, /Limits och eventuella inaktuella /Nums rensas från roten innan den platta arrayen fästs. Att tappa /Limits är inte kosmetiskt, eftersom tabell 37 tillåter den posten bara på intermediära noder och blad, aldrig på roten. Från den punkten är insättningen en vanlig sorterad insättning i en array, och befintliga intervall överlever med sina ursprungliga etikettordböcker. Avvägningen är medveten: trädet byggs inte om i balanserade /Kids-noder efteråt. För sidetiketter kostar det ingenting, för att även en stor referensmanual sällan har fler än några dussin intervall, och ett enda blad är vad de flesta producenter skriver ändå
// Etikettera om appendix i en fil vars /PageLabels-rot använder /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // t.ex. A-1
  // Ersätt intervallet som börjar på sida 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Befintliga romerska och decimala intervall finns kvar i det utplattade bladet
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, oförändrat
end;
Hur kan en /Nums-array feltolkas som nycklar?
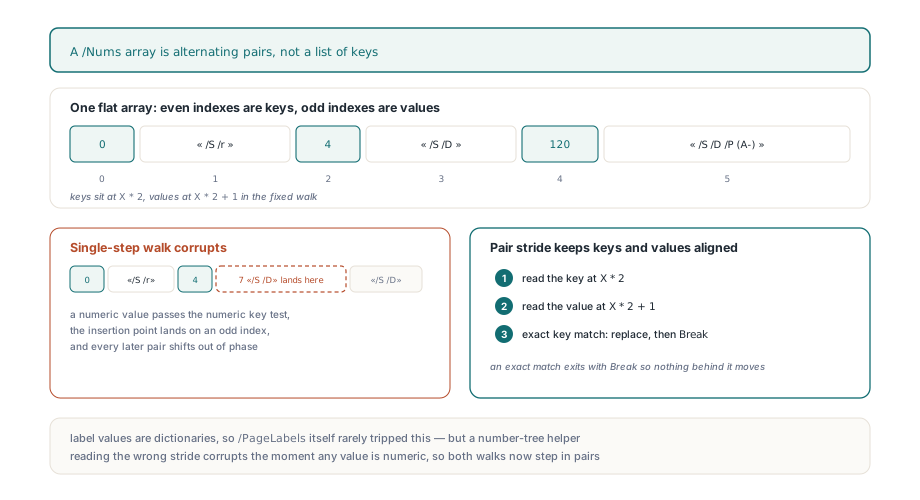
En /Nums-array feltolkas när kod går igenom den ett element i taget, för att arrayen är ett platt lopp av alternerande par, [key0 value0 key1 value1 ...], och bara de jämna positionerna är nycklar. Den gamla NumTreeSet-loopen testade varje element för numerisk typ, så ett värde som råkade vara ett tal jämfördes som om det vore en nyckel; en mindre-än-träff kunde sätta insättningspunkten till ett udda index och tappa det nya paret mitt i ett befintligt, vilket skiftade varje senare par ur fas. EnumNumTree hade samma enstegsgenomgång. Båda itererar nu par med steg två, och läser nyckeln vid X * 2 och värdet vid X * 2 + 1, och en exakt nyckelmatchning ersätter värdet och avslutar med Break. Ärligt talat är sidetikettvärden ordlistor, så den andra buggen utlöstes sällan på /PageLabels självt, men en numerträdshjälpfunktion som läser fel steg är korrupt i samma stund ett värde är numeriskt, och den fixades i samma omgång
Läsa tillbaka etiketter och skicka dem på rundtur
TPDFlib.GetPageLabel(Page) returnerar etiketten för en 1-baserad sida och har två reservvägar värda att känna till. Utan någon /PageLabels-post alls returnerar den det decimala sidnumret, så en anropare kan använda den villkorslöst. Med ett träd på plats men inget intervall som täcker sidan returnerar den en tom sträng, vilket är exakt vad som händer när en fil hoppar över den obligatoriska index 0-posten; referensdokumentationen säger att ett intervall som börjar på sida 1 måste finnas för att etiketter ska visas korrekt, och koden gör det kravet synligt. Bokstavsstilarna följer specifikationen i stället för kalkylbladskolumner: efter Z kommer AA, sedan BB, som upprepar bokstaven i stället för att stega vidare
var
  P: Integer;
  Data: WideString;
begin
  // Snabb koll på vad en viewer visar i sin sidruta
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Alternativvärde 4 exporterar bara etikettintervall som PageLabelBegin-poster
  Data := Lib.ExportDocumentData(4);
  // Importen spelar upp dem genom ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
För bulkredigeringar skriver ExportDocumentData med alternativvärde 4 varje intervall som ett PageLabelBegin-block med PageLabelNewIndex-, PageLabelStart-, PageLabelPrefix- och PageLabelNumStyle-rader, och ImportDocumentData behandlar den första etikettposten den ser som en full ersättning: den anropar ClearPageLabels en gång och matar sedan varje post till AddPageLabels. Det gör en textbaserad rundtur deterministisk även när originalfilen använde ett /Kids-träd, för att rensningen tar bort hela katalogposten och det återbyggda trädet är ett enda blad från början
Vad garanterar fixen fortfarande inte?
Utplattningen är enkelriktad och litar på den ordning den finner. EnumNumTree samlar in par i filordning, och GetPageLabel tillämpar sista intervallet vars nyckel är mindre än eller lika med sidindexet, så en främmande fil vars blad är i fel ordning, vilket §7.9.7 förbjuder men som ändå cirkulerar, kan fortfarande ge fel etiketter tills du bygger om intervallen med ClearPageLabels och färska AddPageLabels-anrop. Etiketter binds också till sidindex, inte sidobjekt, så varje operation som ändrar sidantal eller ordning lämnar intervallen där de var. Ett byte på plats som att ersätta sidor med bevarade objektnummer behåller antalet och därmed etiketterna i linje, medan en sammanslagning som att sortera ihopflätade duplexskanningar ger en ny sidsekvens som förtjänar ett nyskrivet set av intervall
Sidetikettansropen, numerträdshanteringen och dokumentdataexporten och -importen som beskrivs här kommer alla i PDF Library for Delphi för Delphi, C++Builder och Lazarus, med referensposten för AddPageLabels som dokumenterar stilvärdena och returkoderna