HotXLS Delphi Component porovnáva dve textové hodnoty tak, ako to robí Excel 16 od v2.384.67: bez ohľadu na veľkosť písmen, v poradí „word sort“ windows locale používateľa, čo je to, čo vracia CompareStringW s príznakom NORM_IGNORECASE. Spojovníky a apostrofy sa v prvom priechode preskočia a len rozhodujú remízy, takže ="a-b">"ab" je TRUE, zatiaľ čo ostatná interpunkcia sa radí pred číslice a písmená, takže ="a~b"<"ab" je tiež TRUE. Toto isté poradie teraz poháňa porovnávacie operátory, kritériá > / <, radenie rozsahov aj VLOOKUP
Nikto nenahlási bug s názvom „nezhoda collation“. Reporty hovoria, že COUNTIF(A:A,">M") spočíta na serveri dva riadky viac ako v Exceli, že cenník zoradený reportingovou službou dá X-100 niekam, kam by ho Excel nedal, alebo že VLOOKUP("ABC",...) vráti #N/A, hoci stĺpec jasne obsahuje abc. Všetky tri vyplývajú z tej istej otázky: keď sú oba operandy text, ktorý je menší? Excel má presnú odpoveď, nie je to tá, ktorú dáva väčšina Delphi kódu, a pred v2.384.67 dával HotXLS tri rôzne odpovede podľa toho, ktorá cesta kódu sa pýtala
Aké pravidlo používa Excel na porovnanie dvoch textových reťazcov?
Excel porovnáva text word sortom user locale používateľa a ignoruje veľkosť písmen. Word sort je predvolená collation porovnávacích funkcií Windows NLS: písmená sa porovnávajú podľa jazykového poradia, nie podľa kódových bodov, písmená s diakritikou sedia vedľa svojho základného písmena a dva znaky dostávajú špeciálne zaobchádzanie. Spojovník - a apostrof ' sa v prvom priechode ignorujú, takže co-op a coop pristanú vedľa seba, a len keď zvyšok reťazcov dá remízu, rozhodne o poradí ich prítomnosť. Každý ďalší interpunkčný znak sa počíta a radí sa pred číslice a číslice sa radia pred písmená
Tabuľka ukazuje, čo to znamená v praxi, vedľa dvoch porovnaní, po ktorých siahne vývojár v Delphi najskôr. Stĺpec Excel drží verdikty, ktoré vrátil Excel 16 pre IF(A<B,...), a HotXLS ich reprodukuje od v2.384.67
| A vs B | Excel 16 / HotXLS | CompareStr (ordinálne) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | väčšie | menšie | menšie |
"a'b" vs "ab" | väčšie | menšie | menšie |
"a~b" vs "ab" | menšie | väčšie | väčšie |
"a_b" vs "ab" | menšie | menšie | väčšie |
"ab" vs "AB" | rovnaké | väčšie | rovnaké |
"é" vs "f" | menšie | väčšie | väčšie |
"Z" vs "f" | väčšie | menšie | väčšie |
Dva dôsledky sa dajú ľahko prehliadnúť. Po prvé, rozhodujúca úloha spojovníka pri remízach znamená, že ="a-b"="ab" je FALSE: reťazce sú v poradí blízki susedia, ale nie rovnaké. Po druhé, rovnosť ignoruje veľkosť písmen úplne, takže ab, AB a Ab sú z hľadiska akéhokoľvek porovnania ten istý kľúč. Zoradenie 20 testovacích slov cez Range.Sort v Exceli dáva a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z; v rámci skupiny ab rozhoduje pozícia ignorovaného znaku
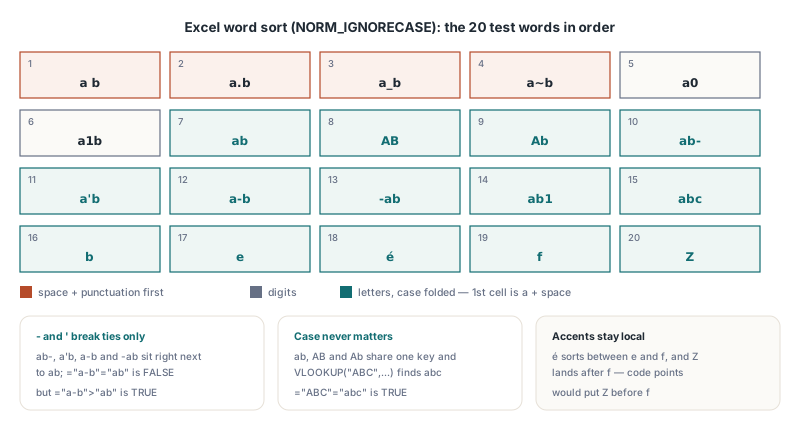
Ako sa zistilo poradie textu v Exceli?
Poradie textu v Exceli sa zistilo meraním, nie dokumentáciou, lebo Excelova dokumentácia collation nijako nepomenúva. Test vygeneroval 4 000 náhodných párov reťazcov z ASCII interpunkcie, číslic, oboch veľkostí písmen, medzier, é, ß, ä, čínskych znakov, full-width foriem a nezlomiteľnej medzery, s dĺžkami od 0 do 4 a polovica párov bola postavená ako vzájomné takmer-zásahy. Excel 16 vyhodnotil IF(A<B,-1,IF(A=B,0,1)) pre každý pár a verdikty sa porovnali s Windows porovnávacím API s rôznymi sadami príznakov
- Samotný
NORM_IGNORECASE(predvolený word sort, user locale): žiadna skutočná nezhoda. Jediných 7 rozdielov boli bunky, ktorých celý obsah bol', ktoré Excel konzumuje ako textový prefixový znak, takže to boli artefakty vzorkovania, nie rozdiely collation NORM_IGNORECASEsSORT_STRINGSORT: 41 nezhôd. String sort berie spojovník a apostrof ako obyčajné symboly, čo je presne to správanie, ktoré Excel nemá- Pridaný
NORM_IGNOREWIDTH: zle iným spôsobom, lebo robí full-width a half-width formy toho istého písmena rovnakými a Excel ich drží oddelené
Druhá, ručne vybraná kontrola porovnala všetkých 190 párov zložených z 20 záludných slov a výsledok Range.Sort v Exceli nad tým istým stĺpcom. Obe sa zhodli s čistým word sortom NORM_IGNORECASE a tých 190 verdiktov plus zoradené poradie je teraz súčasťou regresnej sady HotXLS, pustenej cez klasický engine TXLSWorkbook aj XLSX natívny engine TXLSXWorkbook
Prečo sa CompareText a ordinálne porovnanie mýlia?
CompareText a ordinálne porovnanie trafujú Excelovo poradie vedľa, lebo porovnávajú UTF-16 kódové jednotky a kódové poradie dáva interpunkcii ľubovoľné miesta voči písmenám. Spojovník je U+002D a apostrof U+0027, oba pod každým písmenom, takže ordinálne porovnanie vyhlási "a-b" za menšie ako "ab" namiesto toho, aby bralo spojovník ako riešiteľa remíz. Vlnka U+007E sedí nad každým písmenom, takže "a~b" vychádza väčšia, opak Excelu. CompareText v Delphi RTL mení na veľké len a..z a potom porovnáva kódové jednotky, čo pridáva druhé skreslenie: podčiarknik U+005F leží medzi veľkými a malými písmenami, takže prepnutie na veľké presunie "a_b" z pozície pod "ab" nad neho. Ani jedna funkcia nevie, že é patrí medzi e a f
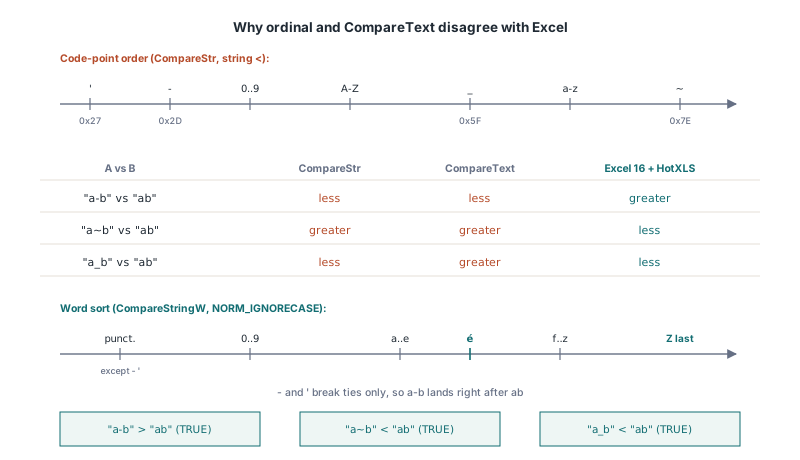
Bežné Delphi nástroje padajú na obe strany hranice:
CompareStr, operátor<nad stringmi aTComparer<string>.Default(ktorý voláCompareStr) sú ordinálne a citlivé na veľkosť písmen, takžeTArray.Sort<string>bez comparera dáZpredfCompareTextaSameTextsú ordinálne po preklade veľkosti písmen len v ASCIIAnsiCompareTextaWideCompareTextv Delphi RTL na Windowse volajúCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), to isté volanie, ktoré sedí s Excelom. ZoradenáTStringLists predvolenými nastaveniami (UseLocaleTrue,CaseSensitiveFalse) ide cezAnsiCompareTexta preto s Excelom tiež súhlasí- Na POSIX cieľoch smeruje Delphi RTL
AnsiCompareTextcez ICU collator, čo je iný algoritmus s inými interpunkčnými pravidlami, aAnsiCompareTextvo Free Pascale na Windowse voláCompareStringApo prevode na ANSI kódovú stránku, čím príde o každý znak, ktorý tá stránka nevie reprezentovať
Funkcie RTL zohľadňujúce locale sú teda na Windowse správne implementáciou, nie kontraktom, a kód, ktorý potrebuje Excelovo poradie, robí lepšie, keď zavolá API explicitne. HotXLS mal vnútri ten istý mix. Porovnávacie operátory preklápeli oba reťazce na veľké písmená a porovnávali kódové body, vetvy > / < kritériových funkcií používali Delphi Variant porovnanie citlivé na veľkosť písmen a VLOOKUP / HLOOKUP párovali text tým istým Variant porovnaním citlivým na veľkosť písmen, preto VLOOKUP("ABC",A1:A20,1,FALSE) nemohol nájsť abc. Radenie rozsahov už používalo WideCompareText. Tri cesty, tri poradia
Čo sa zmenilo v HotXLS vo v2.384.67?
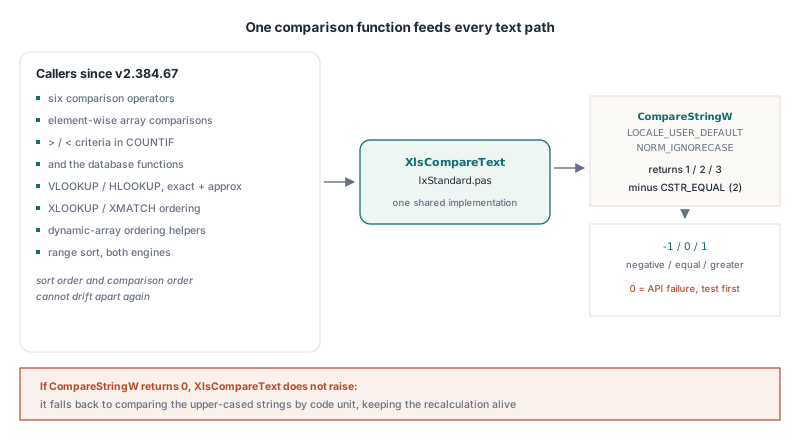
Od v2.384.67 idú porovnania text–text vo výpočtových a zoraďovacích cestách HotXLS cez jedinú funkciu, XlsCompareText v lxStandard.pas, ktorá volá CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...) a odpočíta CSTR_EQUAL. Volajúcimi je šesť porovnávacích operátorov, prvkové porovnania v maticových vzorcoch, vetvy >, <, >= a <= kritérií vo štýle COUNTIF a databázových funkcií, VLOOKUP a HLOOKUP (presný aj približný), pomocníci na radenie za dynamic-array funkciami a XLOOKUP / XMATCH a radenie rozsahov oboch engine. Prevedenie radenia rozsahov touto istou funkciou garantuje, že poradie zoraďovania a poradie porovnávania sa už znova nerozídu, čo je dôležité, lebo približný VLOOKUP na texte dáva zmysel, len keď bol stĺpec zoradený v poradí, v akom lookup porovnáva
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Calculate vyhodnocuje proti aktívnemu hárku
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: spojovník len rozhoduje remízy
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: remíza rozhodnutá, nie rovnaké
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: interpunkcia najprv
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: veľkosť písmen ignorovaná
  finally
    Book.Free;
  end;
end;
Porovnania medzi typmi sú samostatné pravidlo a nezmenili sa: každé číslo je pod každou textovou hodnotou a každá textová hodnota pod každým booleanom, ako popisuje článok o porovnávacích reťazcoch, prázdnych operandoch a SUMIF. Word sort sa aplikuje, až keď sú oba operandy text. Porovnávanie wildcardov je tiež osobitné: kritérium ako "a*" alebo "=ab" je test vzorky alebo rovnosti, pokryté v príručke Excel wildcardov v COUNTIF, MATCH a DSUM a collation diskutovaná tu rozhoduje len o zoraďovacích operátoroch
Ďalší príklad načíta 20 testovacích slov do stĺpca, zoradí ho cez TXLSXWorksheet.SortRange a skontroluje počet cez kritérium a jeden lookup. Počty sú tie, ktoré vrátil Excel 16 pre ten istý stĺpec
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // Excel 16 nad tým istým stĺpcom: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // Pred v2.384.67 #N/A: lookup porovnával citlivo na veľkosť písmen
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // Jeden kľúčový stĺpec, vzostupne: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;
TXLSXWorksheet.SortRange používa stabilné merge sort, takže ab, AB a Ab, ktoré porovnávajú ako rovnaké, držia relatívne poradie z čias pred zoraďovaním. Prázdne bunky idú na koniec v oboch smeroch, ako v Exceli
Ako dosiahnem Excelovo poradie vo vlastnom Delphi kóde?
Ak chcete vo vlastnom Delphi kóde dosiahnuť Excelovo poradie textu, volajte CompareStringW s LOCALE_USER_DEFAULT a NORM_IGNORECASE a nepridávajte SORT_STRINGSORT ani NORM_IGNOREWIDTH. Návratová hodnota nie je znamienkové porovnanie: API vracia CSTR_LESS_THAN (1), CSTR_EQUAL (2) alebo CSTR_GREATER_THAN (3) a 0 pri zlyhaní volania. Odpočítajte 2, aby ste dostali obvyklú konvenciu záporné / nula / kladné, a najprv testujte 0, lebo zlyhanie pomýlené za výsledok sa stane -2, tiché „menšie“
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Excelovo poradie textu: word sort user locale, bez ohľadu na veľkosť písmen
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // 0 je zlyhanie, nie výsledok porovnania
  Result := R - CSTR_EQUAL;    // 1/2/3 sa stanú -1/0/1
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (rovnaké, ľubovoľné poradie), a-b, -ab, abc
end;
TArray.Sort nie je stabilný, takže kľúče, ktoré porovnávajú ako rovnaké, ako ab a AB, môžu vyjsť v ľubovoľnom poradí; ak záleží na pôvodnom poradí rovnakých kľúčov, zoraďte indexové pole s pôvodnou pozíciou ako sekundárnym kľúčom. Opak sa tiež stáva: niekedy stĺpec nesmie nasledovať Excelovo poradie, napríklad dielové čísla, kde X-100 a X100 sú odlišné kódy a majú sa radiť po kódových bodoch. TXLSXWorksheet.SortRange má overload, ktorý berie TXLSSortCompareEvent, metódu so signatúrou function(const Left, Right: Variant): Integer of object, a používa ju namiesto zabudovaného porovnania
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // Vlastný comparer dostane aj prázdne bunky (ako Null): umiestnite ich sami
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ordinálne, citlivé na veľkosť písmen
end;

var
  Sheet: TXLSXWorksheet;   // vyplnený hárok, riadky 2..501, stĺpce A..D
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // kľúč na stĺpci A, vzostupne
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
Keď je dodaný vlastný comparer, HotXLS preskočí vlastnú obsluhu prázdnych buniek a podá surové kľúčové hodnoty, takže comparer si musí poradiť s Null. Pre zostupný kľúč HotXLS neguje, čokoľvek comparer vráti, čo presunie aj prázdne bunky hore, pokiaľ to comparer nezohľadní. Majte na pamäti, že stĺpec zoradený takto už nie je v poradí, ktoré očakáva približný VLOOKUP v Exceli alebo binary-search XLOOKUP; pasce týchto režimov na dátach zoradených inak pokrýva príručka binary search režimov XLOOKUP a XMATCH
Prečo môže ten istý zošit radiť inak na inom stroji?
Ten istý zošit môže radiť inak na inom stroji, pretože Excelovo poradie textu závisí od windows locale používateľa a HotXLS za touto závislosťou ide zámerne. Word sort je viazaný na jazyk: švédska collation napríklad dáva ä za z, kde angličtina a nemčina držia ä pri a. Excel to dedí od locale, pod ktorým beží, takže zošit prepočítaný kolegom vo Štokholme môže vrátiť iný COUNTIF(...,">y") ako ten istý súbor na desktope v Chicagu. HotXLS podáva LOCALE_USER_DEFAULT, aby jeho výsledky na tom istom stroji sedeli s Excelom; akékoľvek fixné locale by robilo HotXLS nezhodným s Excelom na každom stroji s iným nastavením
Pre generovanie na strane servera z toho vyplývajú tri praktické dôsledky:
- Locale, ktoré sa počíta, je locale účtu, pod ktorým proces beží. Windows služba alebo IIS application pool môže používať iný regionálny formát ako desktop vývojára, takže výsledky pozorované v IDE nie sú automaticky to, čo spočíta produkcia
- Cached výsledky vzorcov zapísané do súboru odrážajú locale generujúceho stroja. Excel prepočítava so svojím vlastným locale, takže hodnota sa môže zmeniť, keď sa súbor otvorí inde a prepočíta; to je správanie Excelu, nie artefakt HotXLS
- Locale sa nezhodujú najmä na písmenách s diakritikou, na kombináciách písmen, ktoré niektoré jazyky berú ako jediné písmeno, a na ne-latinských písmach, takže testové dáta obmedzené na obyčajné anglické slová problém neodhalia
Platformová hranica je jednoduchá. HotXLS je Windows knižnica, stavaná pre Win32 a Win64 s Delphi a C++Builder a pre win32 / win64 cieľe s Lazarus a Free Pascal, a všetky tieto zostavenia volajú to isté CompareStringW. Žiadna osobitná ne-Windows collation cesta neexistuje. Jediný fallback je pre zlyhané volanie API: keď CompareStringW vráti 0, XlsCompareText porovná reťazce preložené na veľké písmená po kódových jednotkách namiesto vyhodenia výnimky uprostred prepočtu, čo výpočet udrží v chode, ale už negarantuje Excelovo poradie
Rýchly prehľad: porovnávanie textu v Exceli v HotXLS
- Pravidlo: word sort user locale s
NORM_IGNORECASE, žiadnySORT_STRINGSORT, žiadnyNORM_IGNOREWIDTH, v HotXLS od v2.384.67 -a'len rozhodujú remízy:="a-b">"ab"je TRUE a="a-b"="ab"je FALSE- Ostatná interpunkcia sa radí pred číslice, číslice pred písmená:
="a~b"<"ab"a="a0"<"ab"sú TRUE - Veľkosť písmen nikdy nerozhoduje:
="ABC"="abc"je TRUE aVLOOKUP("ABC",...)nájdeabc - Pokryté cesty: porovnávacie operátory, porovnania polí, kritériá
>/<,VLOOKUP/HLOOKUP, radenie dynamic array,SortRangev oboch engine - Toto pravidlo nepokrýva: zmiešané typy (number < text < boolean) a wildcard kritériá, ktoré majú vlastné pravidlá
- V Delphi kóde:
CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), test na 0, odpočítaťCSTR_EQUAL; vyhnite saCompareText,CompareStraTComparer<string>.Default, keď musí výsledok sedieť s Excelom - Výsledky závisia od locale účtu, pod ktorým kód beží, v Exceli aj v HotXLS
Obyčajné slová sa radia pod každým pravidlom rovnako, takže zlú collation odhalia len kódy so spojovníkmi, interpunkcia a mená s diakritikou. HotXLS teraz dáva Excelovu odpoveď na všetky z nich v engine XLS aj XLSX. Detaily o licencovaní, podporovaných verziách Delphi a C++Builder a skúšobná verzia na stiahnutie sú na stránke Excel komponentu HotXLS pre Delphi