HotXLS Delphi Component číta ten istý vzorový reťazec štyrmi rôznymi spôsobmi, pretože Excel 16 tiež. V COUNTIF a SUMIF je text a~b literál, pokiaľ kritérium neobsahuje aj * alebo ?; v režime wildcardov MATCH a XLOOKUP je vlnka vždy escape, takže a~b nájde ab; v DSUM a ostatných databázových funkciách znamená čistý text „začína na“; a celobunkový Find sa musí vrátiť k poslednej *. HotXLS nasleduje tieto odmerkané pravidlá od v2.384.52, v2.384.60 a v2.384.64
Bug reporty z tejto oblasti nikdy nespomínajú wildcards. Hovoria, že report generovaný na serveri spočíta o pár riadkov menej ako ten istý súbor prepočítaný v Exceli, alebo že dielové číslo obsahujúce vlnku nájde jedna formula a druhá ho ignoruje. Príčinou je matcher, ktorý predpokladá, že vzor znamená všade to isté. Excel tak nefunguje, takže engine, ktorého cached výsledky sa musia zhodovať s Excelom, tiež nemôže. Pred v2.384.52 púšťal HotXLS každé kritérium cez DOS file mask, ktorá bežné vzory trafila a okrajové prípady potichu minula
Prečo znamená jeden vzorový reťazec v Exceli štyri rôzne veci?
Jeden vzorový reťazec znamená štyri rôzne veci, pretože Excel zdedil štyri pravidlá párovania zo štyroch funkcií a nikdy ich nezjednotil. Kritériové funkcie (COUNTIF, SUMIF, AVERAGEIF a rodina *IFS) rozhodujú pre každé kritérium, či sa wildcards vôbec aplikujú. Lookup funkcie (MATCH s match typom 0, XLOOKUP s match_mode 2) ich aplikujú vždy. Databázové funkcie (DSUM, DCOUNTA a spoločnosť) nasledujú Advanced Filter, kde holé slovo je prefix. Find dialóg má vlastné režimy whole-cell a partial. Tabuľka nižšie uvádza, ktoré bunky jednotlivé vzory zachytia nad jedným stĺpcom držiacim a~b, ab, AB, abc, abcb, a*b a axb, s každou funkciou v jej predvolenom režime bez ohľadu na veľkosť písmen
| Vzor | COUNTIF / SUMIF | MATCH(…,0) / XLOOKUP režim 2 | Kritérium DSUM | Find, whole cell, wildcards zapnuté |
|---|---|---|---|---|
ab | ab, AB | ab, AB | ab, AB, abc, abcb | ab, AB |
a*b | a~b, ab, AB, abcb, a*b, axb | rovnako ako COUNTIF | každá položka, abc vrátane | rovnako ako COUNTIF |
a~b | len a~b | ab, AB | ab, AB, abc, abcb | ab, AB |
a~*b | len a*b | len a*b | len a*b | len a*b |
=ab | ab, AB | netýka sa | ab, AB | netýka sa |
Riadok a~b je ten, kde sa COUNTIF a MATCH rozchádzajú, a dielové čísla a ručne písané kódy obsahujú vlnky častejšie, než ktokoľvek čaká. Riadok a*b ukazuje druhú pascu: abc sedí pre DSUM, ale nie pre COUNTIF, lebo databázová funkcia poticho prilepí *. Položky DSUM pre ab, a*b a =ab idú priamo z behov v Exceli 16; položka DSUM pre a~b vyplýva z toho istého prefixového pravidla, keďže prilepená * mení kritérium na wildcard vzor, v ktorom ~b je escapované b
Kedy prejde COUNTIF do režimu wildcardov?
COUNTIF prejde do režimu wildcardov len vtedy, keď text kritéria obsahuje * alebo ?, escapované či nie. Bez ani jedného z týchto znakov porovnáva Excel kritérium s každou bunkou ako celý reťazec, bez ohľadu na veľkosť písmen, a vlnka je len vlnka, takže COUNTIF(A1:A7,"a~b") spočíta bunku, ktorá doslova drží a~b. Pridajte jednu hviezdičku a význam sa prevráti: v "a~b*" teraz vlnka escapeuje b, vzor sa číta ako „ab nasledované čímkoľvek“ a bunka a~b sa už nepočíta. HotXLS aplikuje toto pravidlo v oboch engine od v2.384.52, cez jeden criteria matcher v lxCalc zdieľaný COUNTIF, SUMIF, AVERAGEIF, COUNTIFS, SUMIFS, AVERAGEIFS a databázovými funkciami
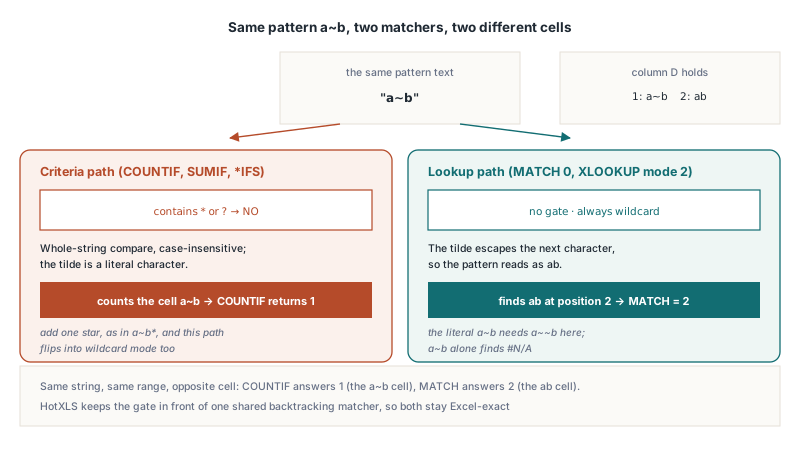
Vnútri režimu wildcardov sú escape pravidlá rovnaké ako všadeinde v Exceli: ~ spraví z ďalšieho znaku literál, akýkoľvek že by bol, takže ~b znamená b a ~~ znamená jednu vlnku a vlnka na samom konci vzoru sa zahodí, takže "a*~" sa správa ako "a*". Hranaté zátvorky nie sú nikdy špeciálne. Kritérium "[x]" spočíta bunky držiace tri znaky [x] a "[a-z]" na obyčajných dátach nezpočíta nič. TXLSXWorkbook.Calculate vyhodnotí reťazec vzorca proti aktívnemu hárku a vráti Variant, najrýchlejší spôsob, ako si tieto pravidlá overiť na vlastných dátach
uses
  System.Variants, lxHandleX;

const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;

  procedure Show(const Formula: string);
  begin
    Writeln(Formula, ' = ', VarToStr(Book.Calculate(Formula)));
  end;

begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Data');
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i, 1].Value := Names[i];
      Sheet.Cells[i, 2].Value := 1 shl (i - 1);  // 1, 2, 4 ... aby suma zo SUMIF povedala, ktoré riadky
    end;
    Sheet.Cells[8, 1].Value := 5;                // číslo; A9 ostáva prázdne

    Show('=COUNTIF(A1:A7,"a~b")');      // 1    žiadne * ani ?: čistý text, bunka a~b
    Show('=COUNTIF(A1:A7,"a~b*")');     // 4    režim wildcardov: ab, AB, abc, abcb
    Show('=COUNTIF(A1:A7,"a*b")');      // 6    wildcard celého reťazca, abc vylúčené
    Show('=SUMIF(A1:A7,"a*b",B1:B7)');  // 119  každý riadok okrem abc (8)
    Show('=COUNTIF(A1:A7,"a~*b")');     // 1    literál a*b
    Show('=COUNTIF(A1:A9,"<>ab")');     // 7    počítajú sa číslo 5 aj prázdne A9
    Show('=COUNTIF(A1:A9,"<>")');       // 8    neprázdne bunky
  finally
    Book.Free;
  end;
end.
Čo počíta "<>text"?
Kritérium "<>text" spočíta každú bunku, ktorá nie je tým textom, a v Exceli 16 to zahŕňa čísla, booleany, chybové hodnoty a prázdne bunky. Holé "<>" je úplne iná otázka: znamená „nie prázdna bunka“, takže prázdne bunky preskočí, ale spočíta každú hodnotu, vrátane prázdneho textu, ktorý vráti formula ako ="". Starý kód HotXLS mal textové bunky správne, ale nie čísla: Variant nerovnosť prinútila Delphi previesť 'ab' na číslo, konverzia vyhodila výnimku, handler ju prehltol ako „žiadna zhoda“ a číselné bunky poticho vypadli z počtu. Stranu prázdnych buniek v tomto príbehu, vrátane toho, čemu sa rovná prázdny operand v obyčajnom porovnaní, pokrýva ako HotXLS hospodári s porovnávacími reťazcami, prázdnymi bunkami a SUMIF
Prečo MATCH nájde ab, keď hľadáte a~b?
MATCH nájde ab, keď hľadáte a~b, lebo MATCH s match typom 0 a XLOOKUP s match_mode 2 sú vždy v režime wildcardov, takže vlnka je escape aj vtedy, keď vzor neobsahuje žiadne * ani ?. Excel 16 to potvrdí na dvojbunkovom rozsahu držiacom a~b a ab: MATCH("a~b",D1:D2,0) vráti 2 a na rozsahu, ktorý drží len a~b, vráti to isté volanie #N/A. Ak chcete vyhľadať literálny text a~b, musíte napísať "a~~b". Medzitým COUNTIF(D1:D2,"a~b") nad tými istými dvoma bunkami vráti 1 a spočíta druhú bunku. Ten istý reťazec, ten istý rozsah, opačná bunka
Preto si HotXLS drží tie dve rozhodnutia oddelené, a nie za jedným vstupným bodom „porovnaj vzor“. Samotný matcher je zdieľaný: od v2.384.52 púšťajú MATCH, XLOOKUP aj kritériové funkcie ten istý backtracking matcher, s rovnakou obsluhou escape a rovnakým pravidlom koncovej vlnky. Odlišná je brána pred ním. Cesta kritérií sa najprv spýta „obsahuje tento text * alebo ??“; cesta lookupov sa nikdy nepýta. Zlúčenie oboch by opravilo jednu rodinu a rozbilo druhú a oba smery sa kontrolujú proti hodnotám Excelu 16 v oboch engine. Wildcard lookupy majú aj vlastnú podmienku: XLOOKUP odmieta wildcard párovanie skombinované s režimom binary search, pravidlo popísané v príručke HotXLS k režimom hľadania XLOOKUP a XMATCH
Ako čítajú DSUM a databázové funkcie čisté textové kritérium?
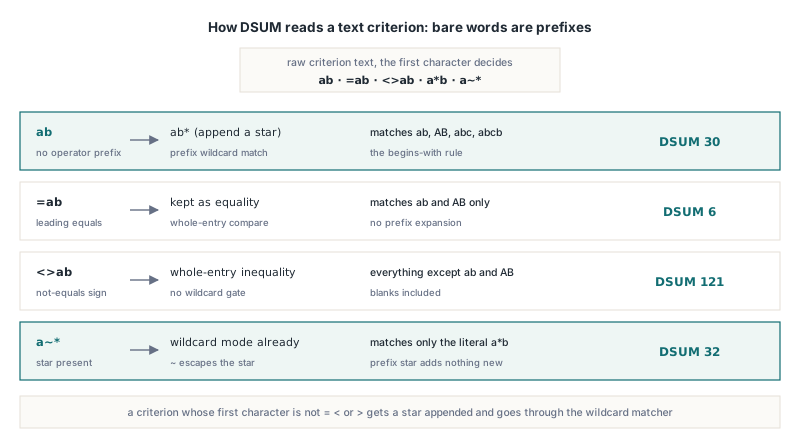
DSUM a ostatné databázové funkcie čítajú textové kritérium bez úvodného =, < alebo > ako „začína na“, s wildcards stále aktívnymi. To je pravidlo Advanced Filter a zámerne sa líši od COUNTIF. Namerané v Exceli 16 nad stĺpcom Name držiacim abc, ab, xab, AB, a~b a a*b: kritérium ab sedí na abc, ab a AB; =ab sedí len na ab a AB; <>ab je nerovnosť celej položky; a*b a a? sú tiež prefixové vzory; >ab je obyčajné porovnanie. Pred v2.384.64 porovnával HotXLS ab presne, takže DSUM nad týmito testovacími dátami vrátil 10, kde Excel vracia 11
Oprava si musela poradiť s condition parserom, ktorý zliepa ab aj =ab do tej istej podmienky rovnosti. HotXLS preto skontroluje surový text kritéria, než zverí rozparsovanú podmienku: textové kritérium, ktorého prvý znak nie je =, < ani >, dostane prilepenú * a ide cez wildcard matcher a všetko ostatné si drží porovnanie celej položky. Jedna praktická poznámka, keď stavite kritériové rozsahy v kóde: v engine XLSX uloží priradenie reťazca '=ab' do TXLSXCell.Value text, zatiaľ čo klasický engine TXLSWorkbook kompiluje hodnotu začínajúcu = ako formulu, pokiaľ ju neprefixujete apostrofom
const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
  Criteria: array [0..4] of string = ('ab', '=ab', '<>ab', 'a*b', 'a~*');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Db');
    Sheet.Cells[1, 1].Value := 'Name';
    Sheet.Cells[1, 2].Value := 'Val';
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i + 1, 1].Value := Names[i];
      Sheet.Cells[i + 1, 2].Value := 1 shl (i - 1);
    end;
    Sheet.Cells[1, 4].Value := 'Name';            // hlavička kritérií v D1
    for i := 0 to High(Criteria) do
    begin
      Sheet.Cells[2, 4].Value := Criteria[i];     // v engine XLSX zostáva textom
      Writeln(Criteria[i], ' -> ',
        VarToStr(Book.Calculate('=DSUM(A1:B8,"Val",D1:D2)')));
    end;
    // ab   -> 30   ab, AB, abc, abcb (začína na)
    // =ab  -> 6    ab, AB (celá položka)
    // <>ab -> 121  všetko okrem ab a AB
    // a*b  -> 127  a*b* sedí na všetkých siedmich, abc vrátane
    // a~*  -> 32   len literál a*b
  finally
    Book.Free;
  end;
end;
Jeden súvisiaci rozdiel prežil prefixovú opravu a na starších zostaveniach sa prejavuje. Textové porovnania ako >ab používali kódové poradie, zatiaľ čo Excel dáva interpunkciu pred písmená, takže "a~b">"ab" je v Exceli FALSE a v HotXLS to bolo TRUE. Od v2.384.67 používajú kritériá > a <, spolu s obyčajným porovnávaním textu a zoraďovaním, Excelovu word-sort collation pod aktuálnym user locale a oboje sa znova zhodujú
Prečo celobunkový Find minul abcb?
Celobunkový Find minul abcb, pretože matcher sa zastavil v prvom bode, kde sa vzor minul, namiesto toho, aby sa vrátil k poslednej *. Matcher čiastočnej zhody za Replace sa vráti hneď, ako sa vzor vyčerpá; celobunkový Find ho znovu použil a potom žiadal, aby zhoda pokryla celú bunku: a*b proti abcb sa zastavil po ab, skonzumoval 2 znaky zo 4 a bol odmietnutý. Od v2.384.60 je celobunkový matcher osobitná implementácia, ktorá berie „vzor skončil, text nie“ ako ďalšiu nezhodu a skúša znova od poslednej hviezdičky, takže a*b sedí na abcb a a?b*b na axbyb, ako to robí Find v Exceli 16 so zaškrtnutým „Match entire cell contents“
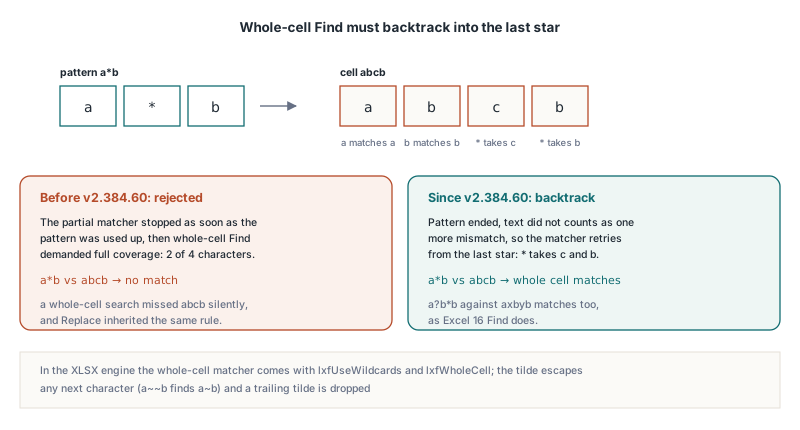
To isté vydanie zmenilo vlnku. Find v Exceli 16, v celobunkovom aj čiastočnom režime, berie ~ ako escape pre ľubovoľný nasledujúci znak: a~b nájde ab, a~~b nájde a~b a koncová vlnka sa ignoruje, takže q~ sa správa ako q. Starší matcher HotXLS uznával ako escape len ~*, ~? a ~~, takže a~b našlo text a~b. Find vzor z jedinej ~ je nestabilný už v samotnom Exceli, sedí na ľubovoľnej bunke ako prázdny vzor, a HotXLS to nenapodobňuje
V engine XLSX je hľadanie TXLSXWorksheet.FindText so sadou TXLSXFindOptions: lxfUseWildcards zapne *, ? a ~, lxfWholeCell vyžaduje, aby sedela celá bunka, a lxfMatchCase robí porovnanie citlivým na veľkosť písmen. Bez lxfUseWildcards je každý znak, hviezdičku vrátane, literál. Find sa pozerá len na textové hodnoty; číselné bunky preskočí a formulové bunky tiež, pokiaľ nie je nastavené lxfSearchFormulas, v ktorom prípade sa hľadá v texte formuly. Kotva daná StartRow a StartCol je vrátane, takže slučka Find All kráča o stĺpec za každý zásah
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row, Col, NextRow, NextCol, Changed: Integer;
  Opts: TXLSXFindOptions;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Parts');
    Sheet.Cells[1, 1].Value := WideString('abc');
    Sheet.Cells[2, 1].Value := WideString('abcb');
    Sheet.Cells[3, 1].Value := WideString('a~b');
    Sheet.Cells[4, 1].Value := WideString('ab');

    Opts := [lxfUseWildcards, lxfWholeCell];
    if Sheet.FindText('a*b', Row, Col, Opts, 1, 1) then
      Writeln('a*b  whole cell -> row ', Row);   // 2: abc odmietnuté, abcb backtracking
    if Sheet.FindText('a~b', Row, Col, Opts, 1, 1) then
      Writeln('a~b  whole cell -> row ', Row);   // 4: ~b je escapované b
    if Sheet.FindText('a~~b', Row, Col, Opts, 1, 1) then
      Writeln('a~~b whole cell -> row ', Row);   // 3: ~~ je jedna literálna vlnka

    // Čiastočná zhoda, Find All: kotviaca bunka je vrátane, takže krok za každý zásah
    NextRow := 1;
    NextCol := 1;
    while Sheet.FindText('a*b', Row, Col, [lxfUseWildcards], NextRow, NextCol) do
    begin
      Writeln('a*b  contained in row ', Row);     // riadky 1, 2, 3 a 4
      NextRow := Row;
      NextCol := Col + 1;
    end;

    // Celobunková wildcard náhrada prepíše len literál a~b
    Changed := Sheet.ReplaceText('a~~b', 'a-b', Opts);
    Writeln(Changed, ' cell(s) replaced');         // 1
  finally
    Book.Free;
  end;
end;
Čiastočná slučka nájde všetky štyri riadky, abc vrátane, lebo v čiastočnom režime musí a*b len niekde vnútri bunky nastať. FindTextIn a ReplaceTextIn berú tie isté voľby plus okno FirstRow, FirstCol, LastRow, LastCol, programový ekvivalent hľadania vo výbere. Klasický engine vystavuje tie isté pravidlá cez overload s tromi booleanmi, TXLSWorksheet.FindText(SearchText, Row, Col, MatchCase, UseWildcards, WholeCell), plus zodpovedajúci overload ReplaceText, s výsledkami riadku a stĺpca od jednej:
var
  Classic: IXLSWorkbook;
  Sheet: TXLSWorksheet;
  Row, Col: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Sheet := Classic.Sheets.Add;
  Sheet.Range['A1', 'A1'].Value := 'abcb';
  // MatchCase = False, UseWildcards = True, WholeCell = True
  if Sheet.FindText('a*b', Row, Col, False, True, True) then
    Writeln('found at ', Row, ',', Col);           // 1,1
  if not Sheet.FindText('a*c', Row, Col, False, True, True) then
    Writeln('a*c does not cover abcb');
end;
Čo mal starý matcher s DOS maskou zle?
Starý matcher mal zle špeciálne znaky, lebo DOS file mask je od Excel wildcardu odlišný jazyk. Pred v2.384.52 podávali kritériové funkcie aj databázové funkcie každý vzor MatchesMask, matcheru file masiek v jednotke lxMasks. Jeho syntax sa s Excelovou pre bežné prípady prekrýva, preto zostal problém skrytý, ale rozchádza sa tam, kde sa reálne dáta stávajú zaujímavými:
[x]sa čítalo ako znaková sada, takžeCOUNTIF(A1:A10,"[x]")spočítal bunky držiacexnamiesto textu v zátvorkách a"[a-z]"sedel na ľubovoľnej jednopísmenovej bunke- Escape vlnkou neexistoval, takže
"a~*b"nemohol sedieť na literálnu hviezdičku - Pokazená maska, ako neuzavretá zátvorka, vyhodila výnimku, ktorú volajúci prehltol ako „žiadna zhoda“ a preklep v kritériu zmenil na poticho zlý súčet
- Na strane lookupov uznávali
MATCHaXLOOKUPako escape len~*,~?a~~, takžeMATCH("a~b",…,0)našiel literála~bnamiestoab
Ak vaše zošity používali len * a ? nad čistými alfanumerickými dátami, výsledky už boli správne a nezmenia sa. Ak obsahujú zátvorky, vlnky, stĺpce zmiešaných typov pod "<>text" alebo kritériá DSUM písané ako holé slová, ich prepočet s v2.384.64 a novšou môže zmeniť súčty a nové súčty sú tie, ktoré ukazuje Excel. To isté rozlíšenie medzi tým, ako Excel kritérium uchováva a ako ho porovnáva, sa týka uložených filtrov, popísané v článku HotXLS o kritériách BIFF8 AutoFilter DOPER
Rýchly prehľad: pravidlá Excel wildcardov v HotXLS
COUNTIF,SUMIF,AVERAGEIFa rodina*IFSpoužívajú wildcards len vtedy, keď kritérium obsahuje*alebo?; inak porovnávajú celé reťazce bez ohľadu na veľkosť písmen a~je literál (od v2.384.52)MATCHs match typom 0 aXLOOKUPs match_mode 2 používajú wildcards vždy, takžea~bnájdeaba literál potrebujea~~b(od v2.384.52)- V režime wildcardov
~escapeuje ľubovoľný ďalší znak a koncová~sa zahodí;[a]sú obyčajné znaky "<>text"počíta čísla, booleany, chyby a prázdne bunky; holé"<>"počíta neprázdne bunky, výsledky=""vrátaneDSUMa ostatné databázové funkcie berú čistý text ako „začína na“;=texta<>textporovnávajú celú položku (od v2.384.64)- Celobunkový Find s
lxfUseWildcardsalxfWholeCellsa vracia k hviezdičke, takžea*bsedí naabcb; Find a Replace berú~ako escape pre ľubovoľný znak (od v2.384.60) - Poradie textu v kritériách
>a<nasleduje Excelovu word-sort collation, interpunkcia pred písmenami (od v2.384.67)
Excel kompatibilita vo formulovom engine je väčšinou okrajové prípady ako tieto, merané proti Excelu, nie hádané z dokumentácie. HotXLS vyhodnocuje COUNTIF, MATCH, XLOOKUP, DSUM a zvyšok svojej knižnice funkcií natívne v Delphi a C++Builder, v klasickom engine aj engine XLSX, bez nainštalovaného Excelu. Detaily, edície a skúšobnú verziu na stiahnutie nájdete na stránke tabuľkového komponentu HotXLS pre Delphi