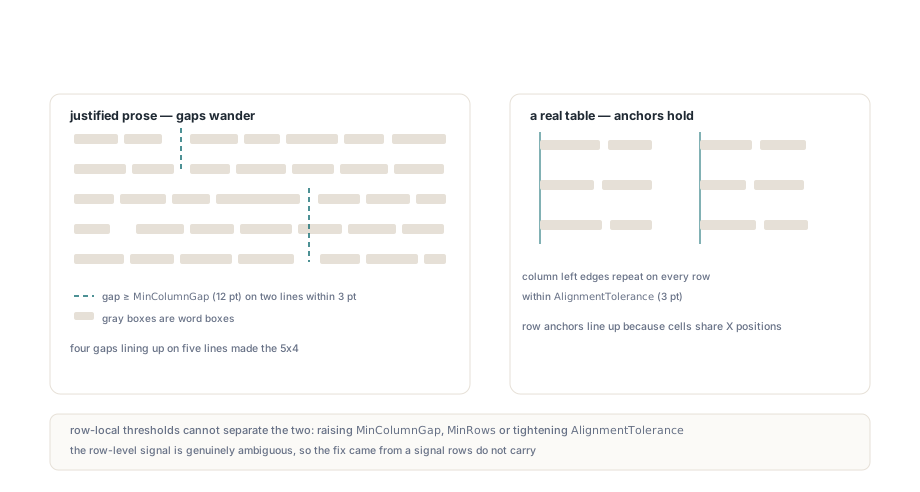
Страница выключенной основной прозы может вернуться из детектора таблиц по пробелам сеткой в несколько столбцов, где каждая ячейка держит обрывок полуфразы, а уверенность заметно выше любого порога, который вы подумали бы выставить. Никакой таблицы на этой странице нет. Детектор нашёл словные промежутки, достаточно широкие, чтобы сойти за разделители столбцов, и несколько подряд идущих строк, где эти промежутки легли почти на одну позицию X, — и по одному выравниванию это в точности то, как выглядит таблица. Ответ — перестать судить о границе столбца по одной строке за раз и спросить, бежит ли по странице между столбцами полоса чистой бумаги
Почему выключенный по формату текст выглядит как таблица?
Выключенный текст проходит проверку, потому что выключенная строка — это ряд слов, разделённых промежутками, которые растянул движок вёрстки, и как только растянутый промежуток пересекает порог столбца, ничто в этой отдельной строке не отличает его от межстолбья. Стратегия по пробелам в PDFium Component работает как большинство детекторов по пробелам. TPdf.ExtractTables группирует рамки слов в визуальные строки, расщепляет каждую строку всюду, где горизонтальное расстояние от одного слова до следующего не меньше MinColumnGap (12 пунктов в TPdfTableExtractionOptions.Default), и кластеризует левые края получившихся групп слов в якоря столбцов в пределах AlignmentTolerance, по умолчанию 3 пункта. Якорь выживает, только если повторяется минимум на MinRows строках, и каждая строка кандидата обязана попасть минимум в MinColumns различных якорей. Для настоящей выровненной таблицы это правило корректно, и именно оно описано в обзоре обнаружения таблиц
Арифметика на стороне прозы менее снисходительна, чем кажется. Пусть строка кеглем 10 пунктов в колонке шириной 180 пунктов недобирает 30 пунктов до правого поля, потому что следующее слово не влезло, и держит всего три межсловных пробела из-за длинных слов. Выключающий движок размазывает эти 30 пунктов по трём пробелам, так что каждый вырастает примерно с 2,5 до 12,5 пункта и переходит дефолтный MinColumnGap. Второй строке нужен лишь один растянутый промежуток, чьё следующее слово стартует в пределах 3 пунктов от первой строки, — и у детектора есть кандидат из двух строк и двух столбцов
Как закодировано растяжение — неважно. ISO 32000-1 §9.3.3 применяет word spacing (Tw) только к однобайтовому коду символа 32, поэтому продюсеры с многобайтовыми шрифтами обычно позиционируют слова числовыми корректировками в массиве TJ (§9.4.3); в обоих случаях рамки слов выходят идентичными. Последняя строка каждого абзаца набирается рваной и несёт обычные пробелы, — вот почему ложные срабатывания покрывают тело абзаца и останавливаются за строку до его конца
Быстрый способ проверить собственный корпус — прогнать детектор по документам, где заведомо одна проза, например письмам или пресс-релизам, и напечатать каждую таблицу режима по пробелам, которую он отчитает. Ожидаемый вывод на них — ничего
uses
  SysUtils, PDFium;

// Перечисляет каждую таблицу по пробелам в загруженном документе, чтобы
// страницы, где заведомо одна проза, можно быстро проверить
procedure ReportWhitespaceTables(Pdf: TPdf; MinRows: Integer = 2);
var
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Options := TPdfTableExtractionOptions.Default;  // MinColumnGap 12, AlignmentTolerance 3
  Options.MinRows := MinRows;
  Tables := Pdf.ExtractDocumentTables(Options);   // восстанавливает активную страницу
  for I := 0 to High(Tables) do
    if Tables[I].DetectionMode = ptdmWhitespace then
      Writeln(Format('page %d: %dx%d whitespace table, confidence %.2f, ' +
        'first cell "%s"',
        [Tables[I].PageNumber, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Tables[I].Cells[0].Text]));
end;
Чем каждый порог платит
Каждый порог уровня строки обменивает один класс документов на другой, поэтому их и стоит не трогать для этой проблемы. Подъём MinColumnGap до 20 пунктов теряет компактные столбцы плотных финансовых отчётов, где межстолбье между колонкой меток и её значениями часто едва шире дефолта. Подъём MinRows до 3 выбрасывает настоящие двухстрочные таблицы и лишь понижает шансы для длинных абзацев, ведь страница прозы даёт много шансов трём строкам выстроиться. Затягивание AlignmentTolerance ниже 3 пунктов начинает расщеплять настоящие столбцы с чуть гуляющими левыми краями, как бывает на сканах с OCR-слоем
MinConfidence выглядит естественным фильтром и оказывается слабейшим из четырёх. Таблица по пробелам в PDFium Component набирает 0,58 плюс 0,30 на долю непустых ячеек с потолком 0,88, то есть оценка измеряет, насколько заполнена сетка. Фрагмент абзаца заполняет каждую ячейку, значит прозаический ложный кандидат набирает у верхней границы диапазона, а настоящая таблица с пустыми ячейками — ниже
Две строки выключенной прозы и две строки двухколоночной таблицы могут дать идентичные группы слов на идентичных якорях. Свидетельство, их разделяющее, лежит между строк
Настоящая граница столбца — вертикальный коридор
Настоящая граница столбца — это вертикальная полоса страницы, свободная от текста на всех строках, которые она разделяет. У таблицы такая есть между каждой парой столбцов по построению, потому что ячейки раскладывались по общим позициям X. Выключенный абзац растягивает свои пробелы на разных горизонтальных позициях в каждой строке, так что никакая полоса не переживает больше одной-двух строк. PDFium Component проверяет ровно это после того, как группы слов кандидата назначены якорным столбцам. Для каждой пары соседних столбцов каждая строка с содержимым в обеих ячейках отдаёт интервал от самого правого края слов левой ячейки до самого левого края слов правой ячейки; интервалы пересекаются по строкам, и весь кандидат отвергается, когда пересечение уже половины MinColumnGap — 6 пунктов при дефолте
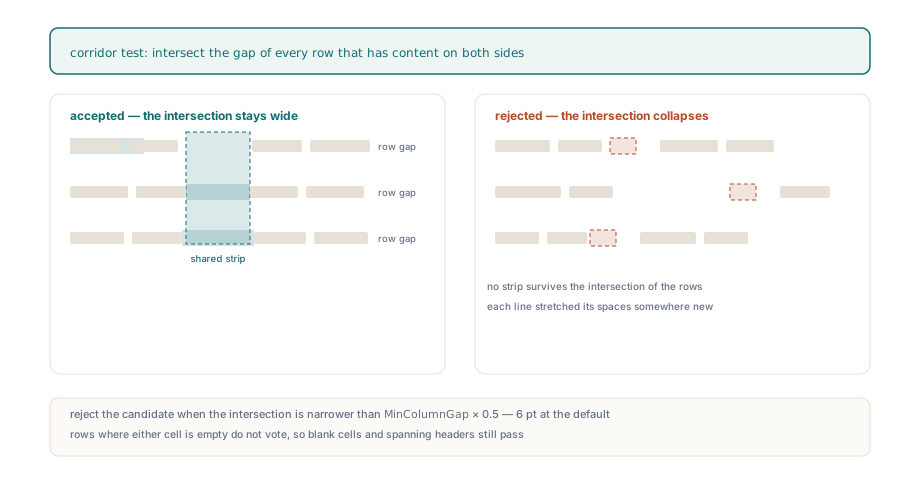
На неудобных настоящих таблицах важны две детали. Строки, где пуста хотя бы одна ячейка, не голосуют, так что таблица с пустыми ячейками или строка заголовка, охватывающая меньше столбцов, чем тело, всё равно проходят. И ширина коридора выводится из MinColumnGap, а не задаётся отдельной опцией, потому что оба значения описывают одну физическую вещь: зазор, который дизайнер оставляет между столбцами. Половина оставляет запас на строку, где длинная запись левого столбца подбирается к соседнему
Проверка достаточно мала, чтобы воспроизвести её в собственном коде раскладки; списки ячеек ниже — ваша собственная структура, по одному массиву индексов слов на ячейку в порядке «строка за строкой»
uses
  Math, PDFium;

type
  TIndexList = array of Integer;
  TCellIndexes = array of TIndexList;   // ваша собственная структура: Row * ColumnCount + Column

// Возвращает False, когда какой-то паре соседних столбцов не хватает
// свободного от текста коридора шириной хотя бы MinColumnGap / 2
function HasTextFreeCorridors(const Words: TPdfWordBoxes;
  const Cells: TCellIndexes; RowCount, ColumnCount: Integer;
  MinColumnGap: Double): Boolean;
var
  Col, Row, I, LeftCell, RightCell, Supported: Integer;
  CorridorLeft, CorridorRight, RowLeft, RowRight: Double;
begin
  for Col := 0 to ColumnCount - 2 do
  begin
    CorridorLeft := -MaxDouble;
    CorridorRight := MaxDouble;
    Supported := 0;
    for Row := 0 to RowCount - 1 do
    begin
      LeftCell := Row * ColumnCount + Col;
      RightCell := LeftCell + 1;
      if (Length(Cells[LeftCell]) = 0) or (Length(Cells[RightCell]) = 0) then
        Continue;                             // пустые ячейки не голосуют
      RowLeft := -MaxDouble;
      RowRight := MaxDouble;
      for I in Cells[LeftCell] do
        RowLeft := Max(RowLeft, Words[I].Rect.Right);
      for I in Cells[RightCell] do
        RowRight := Min(RowRight, Words[I].Rect.Left);
      CorridorLeft := Max(CorridorLeft, RowLeft);
      CorridorRight := Min(CorridorRight, RowRight);
      Inc(Supported);
    end;
    if (Supported > 0) and
       (CorridorRight - CorridorLeft < MinColumnGap * 0.5) then
      Exit(False);
  end;
  Result := True;
end;
Держим таблицы по линейкам вне прохода по пробелам
Таблица по линейкам нашлась бы дважды, если бы проход по пробелам видел каждое слово страницы, потому что чистая таблица по линейкам по построению является ещё и идеально выровненной таблицей по пробелам. Само по себе правило перекрытия больше половины позволило бы кандидату, соединившему нижние строки таблицы по линейкам с несколькими выровненными строками текста под ней, остаться под долей и выйти второй, более крупной таблицей, налезающей на соседа
Когда включены и DetectRuledTables, и DetectWhitespaceTables — то есть по умолчанию — ExtractTables поэтому сначала гонит проход по линейкам и удаляет каждое слово, чья центральная точка лежит внутри границ таблицы по линейкам, прежде чем стартует проход по пробелам. Берётся центр, а не полное вхождение, чтобы слово, перевалившее за рамку на долю пункта, последовало за таблицей, к которой визуально принадлежит. Стратегия по пробелам тогда видит только свободные слова, и маленькая таблица без линеек прямо под сеткой судится по собственным строкам
Почему «Purpose of Request:» выходило как «of Purpose Request:»?
Слова внутри ячейки выходят в неверном порядке, когда код, решающий «та же строка», сравнивает вертикальные центры, потому что рамки слов, построенные из боксов глифов, не делят центр, даже деля базовую линию. FPDFText_GetCharBox возвращает плотный бокс чернил каждого глифа в пространстве страницы, а не бокс, добитый до ascent и descent шрифта, и рамка слова — объединение боксов её символов. В метке формы вроде «Purpose of Request:» у слов «Purpose» и «Request:» есть нижние выносные элементы, у «of» — нет, поэтому бокс «of» короче, а его центр сидит на пару пунктов выше. Процедура, сортирующая по центру Y с допуском 1 пункт на «ту же строку» и затем по левому краю, выносит «of» на отдельную строку над остальными двумя и выдаёт её первой
PDF не даёт shortcut. ISO 32000-1 §9.4.4 размещает глифы смещением вдоль базовой линии, а единственные вертикальные метрики в файле заданы по шрифту: Ascent, Descent и FontBBox в дескрипторе шрифта (§9.8.1). Ничто не говорит, что два глифа делят строку. Плотные боксы, из-за которых подсветка выделения выглядит правильно, как разобрано в материале про выделение строк текста по char-боксам PDFium, — плохой вход для сравнения расстояний между центрами
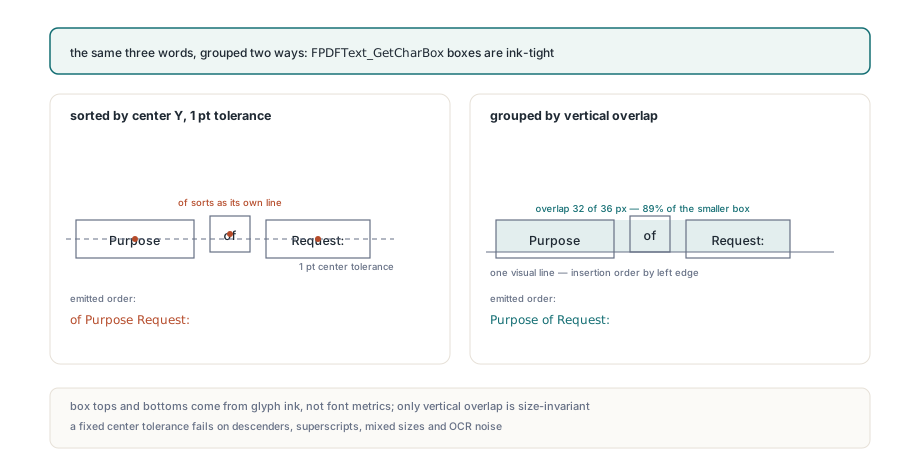
PDFium Component вместо этого собирает текст ячейки по перекрытию. Слово присоединяется к визуальной строке, когда его вертикальное перекрытие с текущими границами строки составляет не меньше 25 процентов меньшей из двух высот, или когда центры в пределах пункта друг от друга; затем каждая строка сортируется по левому краю, а строки соединяются парой CR LF. «Purpose» и «of» перекрываются на всей высоте строчных — куда больше четверти меньшего бокса, — поэтому они попадают на одну строку и читаются по порядку
Группируйте строки текста по перекрытию в собственном коде
Та же ловушка ждёт в любом коде раскладки PDF, решающем «та же строка» сравнением центров с фиксированным допуском. Нижние выносные элементы — самый мягкий триггер. Жирные метки рядом с меньшими значениями, надстрочные маркеры сносок и шумные OCR-боксы двигают центры сильнее, чем любой допуск, который ещё разделяет соседние строки текста кегля 10 при интерлиньяже 12. Доля перекрытия размера не боится: два бокса на одной базовой линии перекрываются по общей высоте строчных, а два бокса на соседних строках не перекрываются ничем
TPdf.PageWordBoxes возвращает каждое слово активной страницы с его прямоугольником в пространстве страницы в Rect, поэтому группировка страницы в визуальные строки — один предикат и короткий цикл
uses
  Math, PDFium;

function SameVisualLine(const A, B: TPdfRectangle): Boolean;
var
  Overlap, MinHeight: Double;
begin
  Overlap := Min(A.Top, B.Top) - Max(A.Bottom, B.Bottom);
  MinHeight := Min(A.Top - A.Bottom, B.Top - B.Bottom);
  Result := (MinHeight > 0) and (Overlap >= MinHeight * 0.25);
end;

procedure GroupPageIntoLines(Pdf: TPdf; out Lines: TArray<TPdfWordBoxes>);
var
  Words: TPdfWordBoxes;
  Bounds: TArray<TPdfRectangle>;   // текущее объединение по строке
  I, J, Found: Integer;
begin
  Words := Pdf.PageWordBoxes;            // нужна активная страница (Pdf.PageNumber)
  Lines := nil;
  Bounds := nil;
  for I := 0 to High(Words) do
  begin
    Found := -1;
    for J := High(Lines) downto 0 do
      if SameVisualLine(Bounds[J], Words[I].Rect) then
      begin
        Found := J;
        Break;
      end;
    if Found < 0 then
    begin
      SetLength(Lines, Length(Lines) + 1);
      SetLength(Bounds, Length(Bounds) + 1);
      Found := High(Lines);
      Bounds[Found] := Words[I].Rect;
    end;
    SetLength(Lines[Found], Length(Lines[Found]) + 1);
    Lines[Found][High(Lines[Found])] := Words[I];
    Bounds[Found].Left := Min(Bounds[Found].Left, Words[I].Rect.Left);
    Bounds[Found].Right := Max(Bounds[Found].Right, Words[I].Rect.Right);
    Bounds[Found].Top := Max(Bounds[Found].Top, Words[I].Rect.Top);
    Bounds[Found].Bottom := Min(Bounds[Found].Bottom, Words[I].Rect.Bottom);
  end;
  // перед чтением сортируйте каждую строку по Rect.Left: PageWordBoxes возвращает
  // слова в порядке потока содержимого, не обязанном совпадать с визуальным
end;
Предикат — та часть, которую стоит скопировать. Для всего, что серьёзнее быстрого дампа, стартуйте со структурной модели текста, уже несущей блоки, строки и источник порядка чтения, — как описано в материале про структурированное извлечение текста PDF с порядком чтения
Что вызывающие таблиц всё ещё контролируют
Вызывающие таблиц получают проверку коридора, фильтр слов «сначала линейки» и текст ячеек по перекрытию, не трогая своих опций. Порог коридора зафиксирован на половине MinColumnGap, так что единственное значение, которое вы крутите для ширины межстолбья, управляет обоими. Стратегия по пробелам держит пол в две строки, даже когда MinRows выставлен в 1; однострочные сетки принимает только стратегия по линейкам, которую ExtractDocumentTables использует для фрагментов таблиц, продолжающихся с верха страницы. Тот же рекорд опций уезжает в TPdfReflowOptions.TableOptions, поэтому вывод reflow наследует те же решения при включённом DetectTables
Проверка коридора судит по строкам с содержимым по обе стороны границы, поэтому кандидат из двух строк судится всего по двум таким строкам. Для архивов, сплошь состоящих из прозы и редко держащих настоящие двухстрочные таблицы — договоры, переписка, эссе — выставьте MinRows в 3 и примите потерю двухстрочных таблиц. Для финансовых и формных документов держите дефолт 2, потому что короткие настоящие таблицы там обычное дело. Текст с рваным правым краем держит обычные одиночные пробелы и редко даёт промежуток, хоть близкий к 12 пунктам
В PDF нет общего объекта таблицы. ISO 32000-1 §14.8.4.3.4 определяет структурный элемент Table, но его несёт только Tagged PDF, поэтому для всего остального сетка — вывод из геометрии, а Confidence таблицы по пробелам никогда не поднимается выше 0,88
Опции обнаружения, сериализация TPdfTable.ToCsv и ToJson и демо TableExtractionLab для Delphi, C++Builder и Lazarus описаны на странице продукта PDFium Component для Delphi