Пакет сканов может быть ни чем иным, как одним JPEG на страницу — без шрифтов, без аннотаций и без закладок — и всё равно провалиться как PDF/raster. ISO 23504-1 требует от файла большего, чем страницы из одного растра: он обязан идентифицировать себя комментарием %PDF-raster-1.0 в области trailer, нести XMP-метаданные и trailer /ID и держать свой каталог и словарь Info в пределах коротких разрешённых списков. Проверка пакета захвата поэтому требует двух разных прочтений — одно по сырым байтам, другое по тому, что каждая страница реально рисует
Два прочтения одного файла
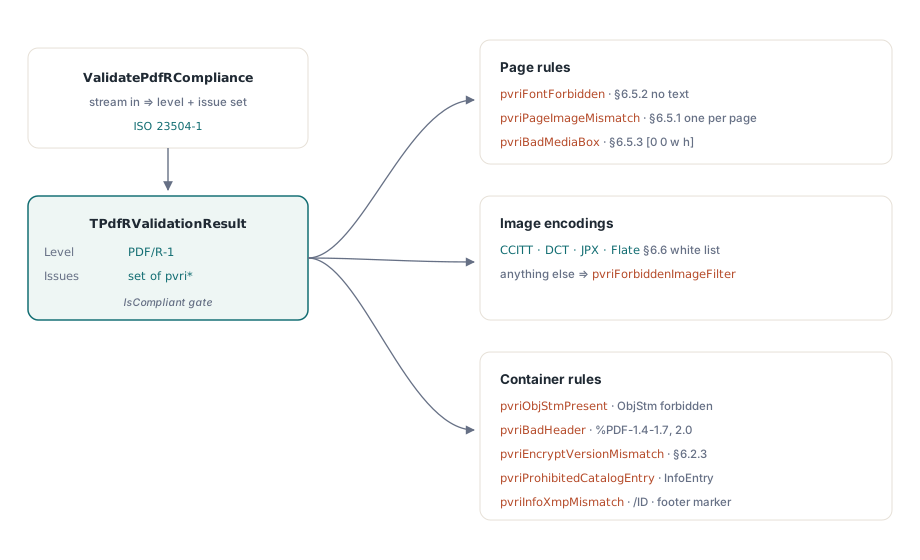
Валидация PDF/R и SaveAsPdfR поставляются с редакциями Small Business и Enterprise PDFium Component, который делит валидацию ровно по этой линии. ValidatePdfRCompliance в модуле FPdfPdfr читает поток и проверяет правила уровня байтов: версию заголовка, маркер растра, object-потоки, записи каталога и Info, XMP, trailer /ID, начала координат MediaBox, шрифтовые ресурсы, запрещённые имена фильтров и совпадает ли число объектов-изображений с числом страниц. ValidatePdfRPageFacts проверяет по одной странице за раз из записи TPdfRPageFacts: сколько объектов текста, путей, форм и затенений рисует страница, где сидит единственное ленточное изображение, его пиксельный размер, глубина цвета, цветовое пространство и цепочка фильтров
Оба прочтения отчитываются через одно перечисление, TPdfRValidationIssue, а комбинированные точки входа сливают их в единый TPdfRValidationResult. Его поле Conformance становится prc1, только когда найден маркер растра, а IsCompliant возвращает True, только когда уровень равен prc1, а набор проблем пуст. Файл, идеальный во всех прочих отношениях, но без маркера, сообщает prcNone — этим удивляются в первый раз, прогоняя через проверку чистый скан
Вопрос в том, откуда берутся факты страниц. TPdf.ValidatePdfR собирает их из загруженного документа, но сперва сериализует этот документ во временное хранилище и прогоняет байтовые проверки по пересохранённой копии, поэтому вердикты о маркере и каталоге описывают свежее сохранение, которое может отличаться от файла на диске. ValidatePdfRasterSource в FPdfBusinessWorkflows берёт один снимок входного потока и прогоняет оба прочтения по нему. Для файла, который вот-вот уйдёт в архив, вызывать нужно именно его: вердикт тогда относится к байтам, подлежащим архивации
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // бюджет по умолчанию 64 МиБ
  Options.Validation.MinimumResolutionDpi := 200; // наш контракт захвата
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues держит байтовые проблемы плюс каждую проблему страниц
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues говорит, какие страницы пересканировать
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Держите машиночитаемый вердикт рядом с архивируемым файлом
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Два значения по умолчанию в TPdfRasterSourceValidationOptions важны для пакетов сканов. MaxInputBytes — 64 МиБ, MaxPages — 1000; длинный пакет цветных сканов может превысить байтовый бюджет, и проверка тогда завершается со статусом prssBudgetExceeded и Complete равным False. MemoryLimitBytes — 8 МиБ, сверх которых снимок проливается в TemporaryDirectory, а отчёт выставляет SnapshotSpilled. Report.IsCompliant также требует Complete, поэтому проверка, остановившаяся на полпути, никогда не читается как зачёт
Почему текстовый слой OCR проваливает PDF/R?
Потому что растровая страница рисует отсканированное изображение и ничего больше. Невидимый OCR-слой — обычное дополнение в PDF/A-конвейере, и он кладёт в файл две вещи, которые PDF/R исключает: шрифтовой ресурс, о котором сообщает байтовое прочтение как pvriFontForbidden, и текстовые объекты на странице, о которых сообщает прочтение страницы как pvriNonRasterPageContent. Та же проблема страницы срабатывает для векторных путей, затенений и form XObject, поэтому проштампованный номер страницы или нарисованная рамка проваливаются так же, как скрытый текст
Отношение страницы к изображению столь же строгое. Каждая страница обязана нести ровно одно ленточное изображение; pvriPageImageMismatch срабатывает и на странице без изображения, и на странице, чей скан записан двумя изображениями бок о бок. На стороне байтов счёт берётся по каждому объекту с /Subtype равным /Image, поэтому любой лишний объект-изображение — скажем, мягкая маска, прицепленная к ленте, — толкает сумму за число страниц
Геометрия получает две проверки. pvriBadMediaBox сообщает о MediaBox, не начинающемся с [0 0 ...]; байтовое прочтение осматривает встроенные числовые массивы. Прочтение страницы затем сравнивает отрисованные границы ленты с MediaBox и сообщает pvriStripGeometryInvalid, когда любая сторона отклоняется больше чем на GeometryTolerancePoints — 0.5 пункта по умолчанию. Драйвер сканера, оставляющий белое поле масштабированием изображения до 98% страницы, проваливается здесь, хотя страница на экране выглядит прекрасно. Установка RequireFullPageStrip в False выключает тест покрытия для внутренних файлов, где поле допустимо
Какие кодировки изображений проходят
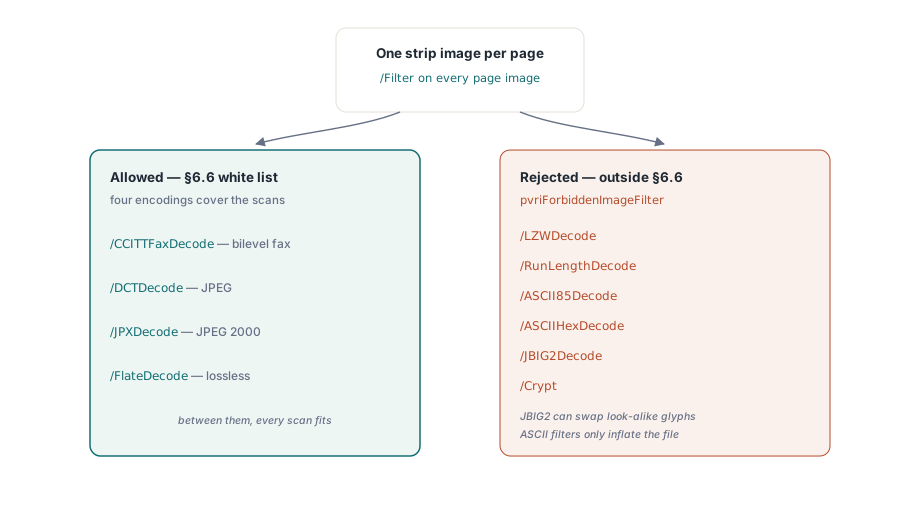
Валидатор принимает четыре фильтра ленты: /CCITTFaxDecode, /DCTDecode, /JPXDecode и /FlateDecode. Байтовое прочтение помечает прочие стандартные фильтры по имени как pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode и /Crypt
JBIG2 — первый отказ, о который спотыкаются команды захвата. Он разрешён в PDF/A и очень хорошо сжимает двухуровневые страницы, поэтому профиль захвата, построенный под PDF/A, может уже выпускать его. Его режим сопоставления с потерями к тому же известен подменой отсканированного глифа похожим на вид — документированная проблема с цифрами на отсканированных формах, — а растровый архив существует именно затем, чтобы то, что было на бумаге, было и в файле. Перекодирование этих страниц в CCITT Group 4 сохраняет их двухуровневыми и без потерь
Прочтение страницы идёт на шаг дальше и смотрит на цепочку фильтров вместе с глубиной цвета и цветовым пространством изображения, сообщая несовпадения как pvriImageCompressionParametersInvalid:
- Цепочка из более чем одного фильтра отвергается, поэтому изображение Flate, завёрнутое в ASCII85, проваливается дважды — один раз на стороне байтов и один раз здесь
/CCITTFaxDecodeобязан сидеть на 1-битной ленте DeviceGray/DCTDecodeобязан сидеть на 8-битной или 24-битной ленте в DeviceGray или DeviceRGB/FlateDecodeпринимается на 1-битных лентах; 24-битная страница Flate проваливает эту проверку/JPXDecodeпринимается при 1, 8 или 24 битах на пиксель
Независимо от фильтра лента, чьё цветовое пространство — не DeviceGray и не DeviceRGB, получает pvriImageColorInvalid. Скан на основе ICC или CMYK поэтому обязан быть преобразован до заворачивания, а самое дешёвое место для этого — профиль сканера, до записи какого бы то ни было PDF
Как вычисляется разрешение ленты
Когда изображение несёт собственное разрешение, прочтение страницы пользуется им. Когда не несёт, эффективное разрешение выводится из пикселей и размера страницы: ширина в пикселях, умноженная на 72 и делённая на ширину MediaBox в пунктах, и так же для высоты. Положим, сканер пишет ленту 2550 на 3300 пикселей на страницу US Letter 612 на 792 пункта. Это выходит ровно 300 dpi в обоих направлениях. Та же страница при 600 на 776 пикселей даёт около 70.6 dpi по горизонтали — ниже минимума по умолчанию 72, поэтому страница получает pvriImageResolutionInvalid
Диапазон по умолчанию в TPdfRValidationOptions — от 72 до 2400 dpi. Эти границы ловят лишь очевидно сломанные страницы. Контракт захвата обычно обещает конкретный минимум — часто 200 или 300 dpi, — и это значение кладётся в MinimumResolutionDpi: страница в 150 dpi проходит диапазон по умолчанию, и это ровно та страница, ради исключения которой контракт писался. Установка любой границы в 0 выключает соответствующую сторону проверки
ValidatePdfRPageFacts публичен, поэтому те же правила могут работать до существования какого бы то ни было PDF — прямо из того, что сканер сообщает о каждом изображении:
uses
  FPdfPdfr;

// Строит факты страниц из вывода сканера; этот хелпер ваш, не часть библиотеки
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // лента покрывает всю страницу
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi оставлен в 0: вычисляется
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // Цветной JPEG 300 dpi на Letter: пустой набор
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // Та же страница, сжатая Flate при 24 битах:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Каталог, словарь Info и XMP
Помимо требуемых /Type и /Pages, ISO 23504-1 допускает в каталоге только Version, ViewerPreferences, PageLayout, PageMode, AcroForm и Metadata. Валидатор сверяет каталог с 21 стандартными ключами вне этого набора и поднимает pvriProhibitedCatalogEntry, когда появляется любой из них, среди них Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties и OutputIntents. Последний важен на практике: файл PDF/A всегда несёт выходное намерение, поэтому один файл не может удовлетворить оба профиля
Словарь Info может держать Creator, Producer, CreationDate и ModDate; Title, Author, Subject, Keywords и Trapped поднимают pvriProhibitedInfoEntry. Каталог без потока /Metadata получает pvriMissingXmpMetadata. Когда поток есть, но его XMP не содержит ни xmp:CreateDate, ни xmp:ModifyDate, ни xmp:MetadataDate, находкой вместо этого становится pvriMetadataInvalid. pvriInfoXmpMismatch сравнивает Producer с pdf:Producer и Creator с xmp:CreatorTool. Даты из этого сравнения исключены, потому что две кодировки законно различаются, а значения Info, хранимые hex-строками, пропускаются. Типичный триггер — инструмент позже переписал Info Producer, не тронув XMP
Оставшиеся контейнерные правила коротки. Заголовок должен быть от %PDF-1.4 до %PDF-1.7 или %PDF-2.0 (pvriBadHeader), любой поток /Type /ObjStm поднимает pvriObjStmPresent, а зашифрованный файл обязан использовать заголовок %PDF-2.0 (pvriEncryptVersionMismatch). При оставленном включённым RequireEncryptedPdf20Profile словарь шифрования также обязан объявлять /V 5 или 6 с /R 5 или новее, иначе файл получает pvriEncryptedPdf20ProfileInvalid
Запись маркеров
TPdfRSaveOptions несёт Creator, Producer, CreationDate, ModDate, DocumentId и InstanceId, и поля для Title, Author, Subject или Keywords у него нет, потому что профиль их запрещает. StripInfoOptionalEntries и StripCatalogOptionalEntries по умолчанию оба True и удаляют исключённые записи из источника; поставьте любой в False — и записи останутся ценой соответствия. TPdf.SaveAsPdfR заполняет пустые поля опций из собственных метаданных и идентификаторов файла загруженного документа, снимает защиту, затем пишет маркер, урезанные словари, XMP-пакет и trailer /ID
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, даты и ID берутся из источника
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Проверяйте записанные байты, а не документ в памяти
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
Заворачивание меняет только метаданные и идентификацию. Исходная страница, рисующая векторный текст или не несущая ленточного изображения, выходит из SaveAsPdfR с тем же содержимым страницы и проваливает те же проверки страниц. Содержимое страницы оставлено в покое намеренно: тихая перерисовка скана изменила бы те самые пиксели, которые архив призван сохранить. Прогон CheckDeliveredScan из первого листинга на OutFile даст полный вердикт, включая прочтения страниц
Где PDF/R уместен в конвейере документозахвата
PDF/R подходит для результатов, где сам скан и есть запись, а точность — весь контракт: доказательная съёмка, захват чеков и платёжных поручений, архивы чертежей с широкоформатного сканера. Стоит документу понадобиться с искомым текстом, разметкой, вложениями или закладками — ему место в PDF/A, потому что каждая из этих возможностей попадает на запрещённые списки выше
Многие команды держат оба. Оригинал PDF/R пишется один раз и никогда не меняется, а производная PDF/A с OCR-слоем обслуживает поиск. Валидаторы независимы, поэтому один пакетный job может проверить каждый файл против профиля, который тот заявляет. Архивная сторона разобрана в статьях об архивном соответствии PDF/A и preflight-валидации PDF/A, а печатный вывод — в разборе валидации печатно-готовых документов PDF/X
Показанные здесь проверки PDF/R — часть редакций Small Business и Enterprise PDFium Component для Delphi, C++Builder и Lazarus, рядом с валидаторами PDF/A, PDF/X, PDF/E и PDF/UA; редакции и поддерживаемые версии IDE — на странице продукта PDFium Component