Входной архивный gate отклонил пакет файлов, объявленных как "PDF/A-2b", хотя на рабочем столе они прекрасно открывались в любом viewer. Поставщик клялся, что они conformant. Это было не так: каждый файл нес JavaScript action, спрятанный в catalog, как раз тот случай, который случайным взглядом почти никогда не ловится, а полноценный validator PDF/A вроде veraPDF отмечает мгновенно. Проблема состояла в том, что никто не хотел прикручивать Java toolchain к batch service на Delphi только ради одного вопроса yes-or-no на файл. Именно этот пробел и закрывает ValidatePdfACompliance в PDFium Component, и полезно понимать, как именно он выносит вердикт, ни разу не выполняя полный parse content stream
Почему сам PDFium не может на это ответить
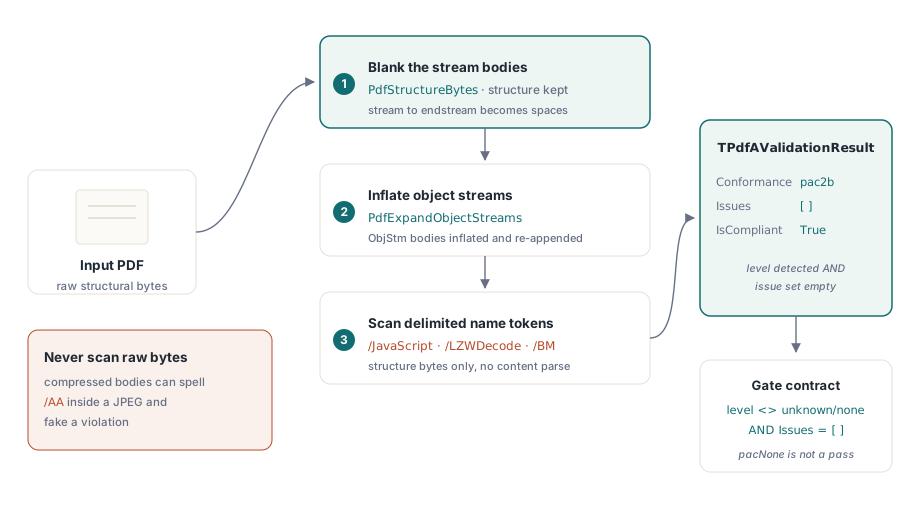
Первое, о чем нужно честно сказать: встроенный pdfium.dll вообще не умеет ничего, связанного с PDF/A. В публичной поверхности нет ни ConvertToPDFA , ни writer для OutputIntent, ни XMP API. Вся логика PDF/A в этой библиотеке, и на стороне записи, и на стороне проверки, живет в pure Pascal внутри FPdfPdfa.pas и работает как byte-level parsing плюс incremental update. Поэтому, когда вы вызываете validator, вы не спрашиваете ничего у Chromium renderer. Вы запускаете Pascal token scanner по структурным байтам файла
Публичный API намеренно минимален. Одна функция читает stream с позиции 0 и возвращает запись:
function ValidatePdfACompliance(Source: TStream): TPdfAValidationResult;

type
  TPdfAValidationResult = record
    Conformance: TPdfAConformance;        // pacUnknown, pacNone, pac1b, pac2u, ...
    Issues: TPdfAValidationIssues;        // множество TPdfAValidationIssue
    function IsCompliant: Boolean;        // True только когда level <> unknown/none
  end;                                    // И Issues пуст
IsCompliant кодирует главное правило для gate: файл считается прошедшим только тогда, когда был найден настоящий уровень conformance и набор issues пуст. Parse, который технически удался, но не нашел pdfaid marker, возвращает pacNone , а это явно не считается pass. Ровно ту же мысль со внешней стороны формулирует batch preflight report CLI : пустой список findings у нераспознанного файла не является чистым счетом здоровья
Удаление тел потоков до любого token scan
Это самая важная деталь реализации и именно то место, где проще всего ошибиться, если писать собственный scanner. Детектор ищет нарушения через delimited name token, вещи вроде /JavaScript , /LZWDecode , /BM . Если сканировать сырые байты файла, встроенные binary stream body, сжатые изображения, ICC profile и программы шрифтов случайным образом будут содержать последовательности байтов, похожие на эти token. Вы начнете рапортовать о найденных /AA или /3D только потому, что три байта внутри JPEG случайно сложились именно в эту подпоследовательность. Это фабрика ложных срабатываний
Исправляет это PdfStructureBytes : она проходит по файлу и заменяет байты между каждым ключевым словом stream и endstream пробелами, оставляя структуру словарей нетронутой. Только после этого запускается scan. Каждая проверка по name token в validator работает уже на этой очищенной копии. Если вынести из статьи одну идею, то именно эту. Та же дисциплина отражена и в validator PDF/UA, который держит собственную копию этой процедуры, потому что оба стандарта развиваются независимо
29 issues и смысл каждого из них
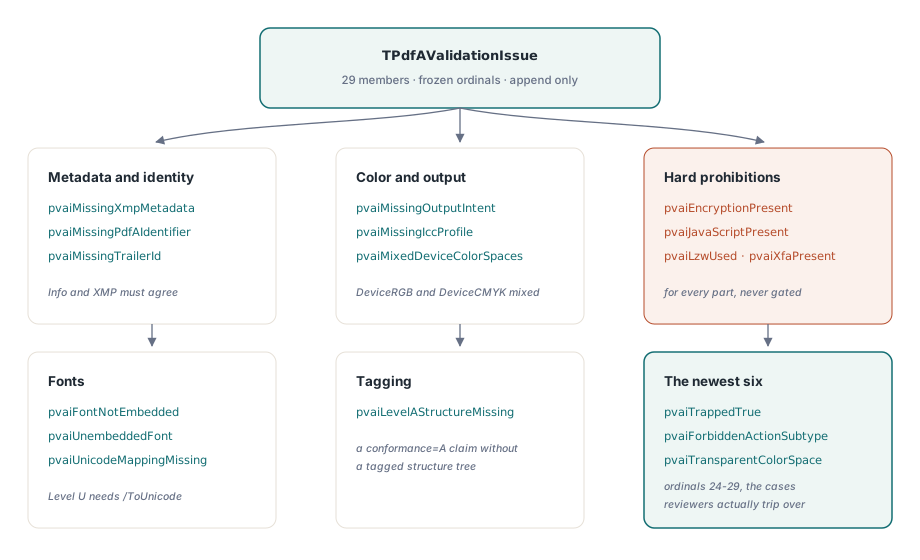
TPdfAValidationIssue является документированным контрактом. Порядковые номера зафиксированы, потому что от них зависят callers, demo и report layer, поэтому новые findings всегда только добавляются в конец. По состоянию на v1.63.0 в наборе 29 участников. Их удобно разбить на несколько семейств:
- Metadata и identity :
pvaiMissingXmpMetadata,pvaiMissingPdfAIdentifier,pvaiMissingTrailerId, ISO 19005-1 6.1.3,pvaiMissingXmpDates - Цвет и output :
pvaiMissingOutputIntent,pvaiMissingIccProfileиpvaiMixedDeviceColorSpaces, когда в документе одновременно встречаются DeviceRGB и DeviceCMYK, 6.2.3.3 - Жесткие запреты, действующие для всех частей :
pvaiEncryptionPresent, словарь/Encryptзапрещен безоговорочно,pvaiJavaScriptPresent,pvaiForbiddenAction,pvaiAdditionalActions,pvaiLzwUsed,pvaiXfaPresent,pvaiNeedAppearancesTrue,pvaiForbiddenAnnotation - Шрифты :
pvaiFontNotEmbeddedи более строгийpvaiUnembeddedFont, а такжеpvaiUnicodeMappingMissingдля случая, когда заявлен Level U, но отсутствует/ToUnicode - Tagging :
pvaiLevelAStructureMissing, когда заявление conformance=A не сопровождается tagged structure
Шесть самых новых элементов, добавленных под номерами 24-29, покрывают как раз те тонкие случаи, на которых регулярно срываются проверки: pvaiTrappedTrue , то есть /Trapped /True в Info dictionary, ложный друг, потому что значение там должно быть False или Unknown, pvaiForbiddenActionSubtype , то есть использование Sound или Movie как action, а не только как annotation, pvaiTransparentColorSpace , то есть blend mode, отличный от Normal, или /CA / /ca , не равные 1.0, а также pvaiAnnotationDictViolation , pvaiUnembeddedFont и pvaiMixedDeviceColorSpaces
Чувствительные к части правила: A-1 строгий, A-2 и A-3 мягче
PDF/A - это не одна книга правил. Три вещи, запрещенные в PDF/A-1, начиная с PDF/A-2 явно разрешены: transparency, группа /Transparency или активный /SMask , 6.4, optional content /OCProperties , 6.1.13, и embedded file /EmbeddedFiles или /EF , 6.1.11. Наивный validator, который будет помечать все три пункта у любого файла, массово отвергнет вполне корректные документы PDF/A-2
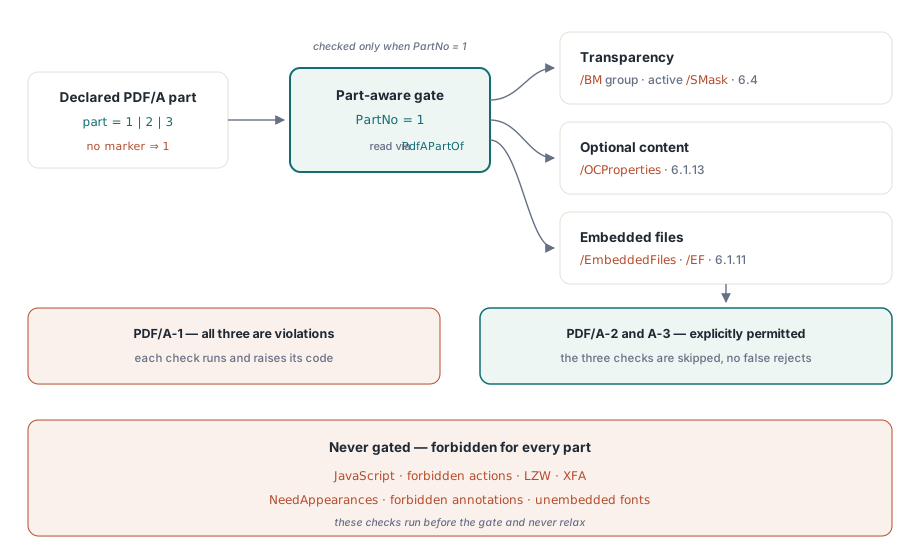
Поэтому validator считывает номер части из pdfaid marker через PdfAPartOf и ставит эти проверки под PartNo = 1 . Проверки blend mode и annotation alpha для новых проблем прозрачности по той же причине ограничены только part 1
if PartNo = 1 then
begin
  if PdfHasName(Struct, '/BM') then
    if not PdfHasBMNormal(Struct) then          // only /Normal or /Compatible allowed
      Include(Result.Issues, pvaiTransparentColorSpace);
  if PdfHasCaNotOne(Struct, '/CA') or PdfHasCaNotOne(Struct, '/ca') then
    Include(Result.Issues, pvaiTransparentColorSpace);
end;
Один консервативный default стоит упомянуть отдельно: если pdfaid marker вообще отсутствует, part считается равной 1, то есть применяется самый строгий режим. Логика проста: неидентифицированный файл лучше держать по самым жестким правилам, чем пропускать его из вежливости. JavaScript, запрещенные action, LZW, XFA, NeedAppearances, запрещенные annotation и невстроенные шрифты при этом остаются запрещенными для всех частей, поэтому эти проверки никогда не сидят за gate
Раскрытие object stream, чтобы ничего не спряталось
PDF 1.5 ввел cross-reference stream и object stream /Type /ObjStm , и они создают слепую зону для наивного byte scanner. Catalog, OutputIntent, action dictionary и вообще все, что само не является stream, может быть Flate-compressed внутри ObjStm. Если сканировать только сырую структуру, вы не увидите ничего из этого и сообщите о чистом файле, который на самом деле далеко не чист
PdfExpandObjectStreams закрывает этот пробел. До запуска любой проверки validator выполняет Data := PdfExpandObjectStreams(Data) . Эта процедура находит каждый ObjStm, считывает его заголовок /N и /First , чтобы узнать номера и смещения вложенных объектов, распаковывает тело через PdfInflate , это RTL zlib, System.ZLib на Delphi и zstream на FPC, и дописывает каждый вложенный объект в виде обычного N 0 obj ... endobj в конец копии байтов. После этого существующие token checks находят эти объекты без каких-либо изменений своей логики
Два ограничения делают этот прием чистым, а не хрупким. Stream object, Metadata, ICC profile и программы шрифтов не могут жить внутри object stream, там допускаются только non-stream dictionaries, поэтому после раскрытия мы по-прежнему работаем только со словарями, а у добавленных объектов нет ключевого слова stream, которое могло бы нарушить фазу удаления body. И поскольку добавленный контент приземляется после %%EOF, обратный поиск из startxref по-прежнему находит исходный trailer. Trailer у cross-reference stream обрабатывается отдельно, за счет чтения Root, Size и ID прямо из plaintext dictionary xref-stream — это подробнее разобрано в сопутствующем материале о validating object and cross-reference streams; раскрытие object stream добавляет поверх этого шаг inflate
Для чего нужен byte-level checker
Это preflight tool, а не сертифицированный validator. Встраивание шрифтов определяется эвристикой по счету, и очевидный счет оказывается неверным. PdfCountName('/FontDescriptor') видит два token /FontDescriptor на шрифт: одну ссылку из font dictionary и один /Type в самом descriptor object, поэтому счет выходит 2N против N встроенных program, и тест всегда true. PdfCountDescriptorRefs считает только форму ссылки /FontDescriptor N G R, одну на шрифт, и поднимает pvaiUnembeddedFont, только когда встроенных program действительно меньше:
K := PdfCountDescriptorRefs(Struct);                 // по одному на каждый словарь шрифта
Emb := PdfCountName(Struct, '/FontFile')
     + PdfCountName(Struct, '/FontFile2')
     + PdfCountName(Struct, '/FontFile3');
if (K > 0) and (Emb < K) then
  Include(Result.Issues, pvaiUnembeddedFont);
Это сигнал, основанный на счете, а не per-font audit, поэтому подтверждайте font findings полным validator, включая стандартные ресурсы standard-14 вроде /Helv, которые вытаскивает раскрытый AcroForm /DR и которые veraPDF пропускает, потому что они никогда не используются для рендеринга. Проверки на уровне операторов content stream, 6.2.10, требуют полноценного разбора содержимого и остаются вне byte scan. Рассматривайте validator как быстрые первые ворота без зависимостей, который ловит нарушения, не исправляемые одним только внедрением marker, а полноценный validator оставляйте для финальной сертификации
Это проверяющая половина истории. Дополняющая ее половина записи, где SaveAsPdfA внедряет XMP, OutputIntent и профиль sRGB ICC и честно понижает запрос Level A, если у документа нет tagged structure, построена на той же byte-level machinery. Обе половины поставляются в PDFium Component for Delphi , одном VCL package поверх pure-Pascal реализации PDF/A без какого-либо внешнего runtime