Архив счетов может чисто рендериться, печататься, встраивать все шрифты и нести валидный output intent — и валидатор PDF/A всё равно отвергнет его, потому что один словарь ресурсов держит 4 096 записей. Потолок — 4 095. PDF/A наследует из PDF Reference небольшую таблицу лимитов реализации, и файл, превысивший любой из них на единицу, проваливает соответствие, хотя ни один вьювер не жалуется
Другой провал, попадающий в ту же корзину «но выглядит же нормально», — символический TrueType-шрифт, несущий запись /Encoding. Чек-боксы, штрих-коды и Dingbats выходят на экран правильно, а валидатор всё равно мечет метку на словарь шрифта. Обе проблемы живут в графе объектов, а не в чём-то видимом человеком на странице, поэтому стоит проверять их механически, прежде чем файл отправится в архив
Числа, которые PDF/A наследует, и где проходит граница
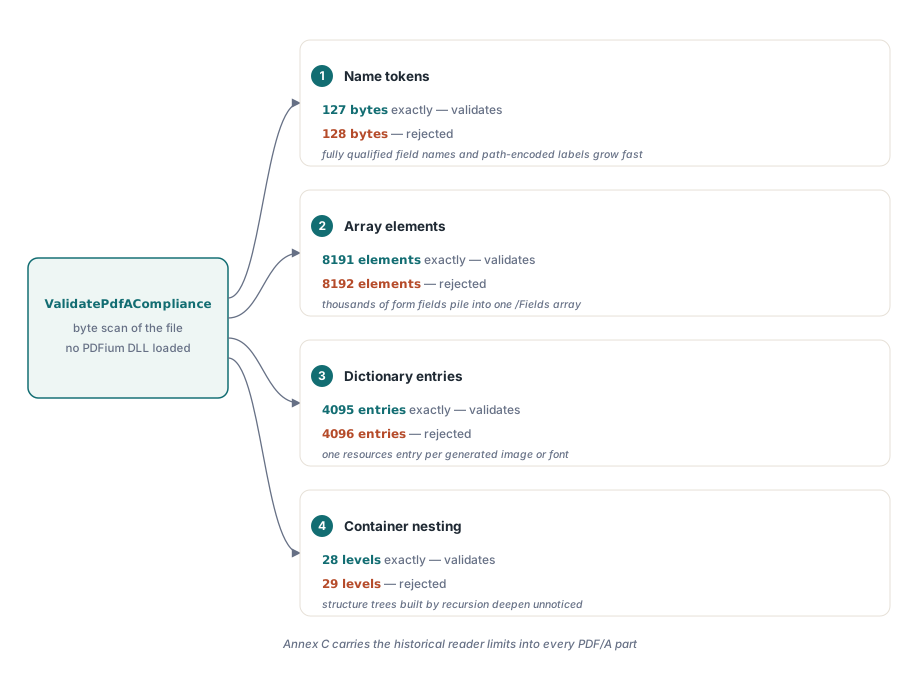
PDFium Component проверяет четыре лимита контейнеров на каждой валидации PDF/A: токен имени может быть длиной не более 127 байт, массив может держать не более 8 191 элемента, словарь — не более 4 095 записей, а массивы и словари могут вкладываться не глубже 28 уровней. Все четыре границы включительные. Имя в 127 байт проходит, в 128 — проваливается; массив ровно из 8 191 элемента проходит, а ещё один элемент валит его
Лимиты имён, массивов и словарей родом из эпохи, когда соответствующий читатель обязан был обрабатывать структуры лишь до этих размеров. Современный настольный вьювер может открыть куда больший массив без жалоб, но архивный файл должен открываться в читателях, с которыми никто ещё не тестировал, — включая старые, которые система документооборота может всё ещё гонять. Потому PDF/A и держит исторические потолки вместо того, чтобы их ослаблять
Включительность против исключительности — место, где самодельные проверки обычно ошибаются. Тест, написанный как Count >= 8191 вместо Count > 8191, отвергает соответствующие файлы, а валидатору, отвергающему соответствующие файлы, всё равно почему-то верят, поэтому генератор «чинят» от проблемы, которой у него не было. Функция ValidatePdfACompliance в юните FPdfPdfa считает строго за пределом и читает байты файла напрямую, так что проверка идёт без загрузки DLL PDFium
uses
  System.Classes, FPdfPdfa;

procedure CheckContainerLimits(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Res: TPdfAValidationResult;
begin
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfACompliance(Src);   // байтовый скан, DLL PDFium не нужна
    if pvaiNameOverLimit in Res.Issues then
      Log.Add('A name token is longer than 127 bytes');
    if pvaiArrayOverLimit in Res.Issues then
      Log.Add('An array holds more than 8191 elements');
    if pvaiDictOverLimit in Res.Issues then
      Log.Add('A dictionary holds more than 4095 entries');
    if pvaiNestingOverLimit in Res.Issues then
      Log.Add('Arrays and dictionaries nest deeper than 28 levels');
    if Res.IsCompliant then
      Log.Add('No PDF/A findings');
  finally
    Src.Free;
  end;
end;
Четыре флага — члены множества Issues на TPdfAValidationResult, рядом со всеми прочими находками PDF/A, а IsCompliant возвращает True, только когда найдена PDF/A-идентификация и множество пусто. Файл, не несущий PDF/A-идентификации вовсе, проверяется по строгому набору правил PDF/A-1, так что лимиты контейнеров к нему тоже применяются
Какие генераторы упираются в эти лимиты?
Почти всегда те, что строят структуру в цикле. Форма с несколькими тысячами полей порождает массив AcroForm /Fields или массив /Annots страницы, уходящий за 8 191 записей. Генератор отчётов, регистрирующий по одному ресурсу шрифта или изображения на каждый сгенерированный объект и никогда не переиспользующий существующую запись, растит суб-словарь /Resources за 4 095 ключей. Размеченный документ, чьё дерево структуры построено рекурсией по вложенной модели данных, может пройти 28 уровней, пока никто не смотрит
Длинные имена родом из другого места: данные, запихиваемые в токены имён. Краска сепарации, названная по клиентской ссылке, группа опционального содержимого, названная по пути файла, метка поля, собранная из шести уровней иерархии. Имена ничего не стоят в генерации, а 127 байт утекают быстро, стоит появиться UTF-8-метке с акцентированными символами: каждый из них занимает два-три байта. 127 байт считаются после вводного /, до следующего разделителя или пробела
Лекарство каждый раз структурное. Разбейте массив, разбейте словарь, сплющите рекурсию, укоротите имя. Впрыскивание PDF/A-маркеров в файл не поможет ни с одной из этих находок: проблема — форма графа объектов, а XMP-метаданные о ней молчат
Как скан считает элементы и записи
Правило счёта важно, когда вы пытаетесь воспроизвести находку в hex-редакторе. Вложенный массив или словарь считается одним элементом родителя — так и сформулирован лимит: массив из 10 массивов по 1 000 элементов в каждом — норм, потому что ни один отдельный массив не превышает 8 191. Внутри словаря считаются только ключи, поэтому значение, оказавшееся именем, не раздувает счёт записей. Hex-строки вроде <FEFF0041> пропускаются как одиночные токены, поэтому их угловые скобки никогда не путают с вложенностью словарей
Скан покрывает объектную структуру всего файла, включая объекты, хранящиеся внутри сжатых object-потоков, — они распаковываются до счёта. Тела самих потоков, вроде содержимого страниц и данных изображений, сперва замазываются, поэтому серия бинарных байтов, случайно содержащая / или [, не может вызвать ложную находку имени или массива
Есть смежный числовой лимит, который та же валидация сообщает под собственным флагом. Когда файл объявляет PDF/A-2 или более позднюю часть, pvaiIntegerImplementationLimit поднимается для любого целочисленного токена вне 32-битного знакового диапазона — то есть вне −2 147 483 648 … 2 147 483 647. Генераторы, пишущие байтовые смещения или большие счётчики простыми целыми, — обычный источник
Почему символический TrueType-шрифт обязан сбросить /Encoding?
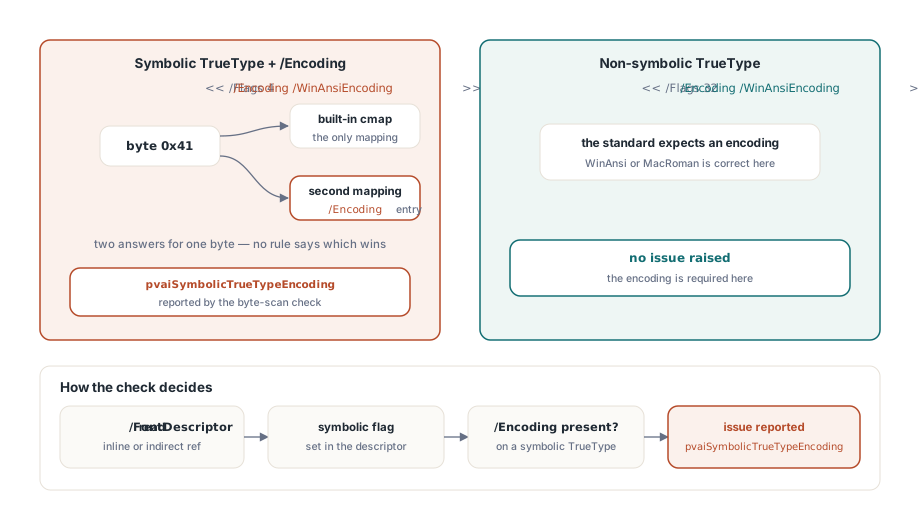
ISO 19005-1, §6.3.7 допускает в качестве отображения символов символического TrueType-шрифта только встроенный cmap шрифтовой программы. Символический шрифт отображает коды в глифы на собственных условиях — именно это и объявляет флаг Symbolic. Добавьте запись /Encoding — и файл даёт два ответа на вопрос «какой глиф выбирает байт 0x41», и ничего в файле не говорит, кто побеждает. Читатели разрешают конфликт по-разному, и один и тот же чек-бокс может выйти галочкой в одном вьювере и буквой A в другом
ValidatePdfACompliance находит каждый словарь шрифта с /Subtype /TrueType, проверяет, есть ли у него ключ /Encoding, а затем читает бит 3 (значение 4) записи /Flags в дескрипторе шрифта. Дескриптор отслеживается и записанный инлайн, и указанный непрямым объектом. Несимволический TrueType-шрифт, хранящий /WinAnsiEncoding или /MacRomanEncoding, эта проверка не мечет: для несимволических шрифтов PDF/A ждёт именно такую кодировку
// Res приходит из ValidatePdfACompliance, как в первом примере
if pvaiSymbolicTrueTypeEncoding in Res.Issues then
  Log.Add('A symbolic TrueType font carries /Encoding; PDF/A admits only ' +
    'the font''s built-in cmap (ISO 19005-1 6.3.7)');

// Соседнее шрифтовое правило с другим триггером: НЕсимволический
// TrueType-шрифт, чей словарь Encoding несёт /Differences
if pvaiTrueTypeDifferencesForbidden in Res.Issues then
  Log.Add('A non-symbolic TrueType Encoding dictionary carries /Differences');
Шрифты, спотыкающие это правило, предсказуемы: Symbol, Wingdings, штрих-кодовые шрифты, иконочные шрифты. Они появляются в деловых документах как чек-боксы, звёзды рейтингов и штрих-коды, и шаг сабсетирования, обращающийся со всяким TrueType одинаково, пишет для них кодировку тоже. Они же — шрифты, на которые никто не смотрит, когда валидатор говорит «проблема со шрифтом», потому что сперва проверяют шрифты основного текста
Обратная ошибка тоже встречается в дикой природе: производитель ставит флаг Symbolic на обычный текстовый шрифт, который на деле закодирован WinAnsi. Проверка PDF/A следует пункту так, как он написан, и сообщает тот шрифт, и тут ремонт принадлежит дескриптору: исправьте флаг в дескрипторе, а не удаляйте кодировку. Удалить /Encoding из текстового шрифта, который неверно пометили, — значит оставить текст зависимым от того cmap, что случайно оказался в сабсете, а это файл хуже исходного. Посмотрите на набор глифов шрифта, прежде чем выбирать, какую половину противоречия убрать
Чтение находок в preflight-отчёте
Юнит preflight-отчёта поставляется с редакцией Enterprise, а ValidatePdfACompliance — в каждой редакции. Отчёт в юните FPdfPreflightReport раскладывает четыре лимита контейнеров в категорию Structure, а проблему кодировки символического TrueType — в категорию Content. Разделение нарочно. Находки структуры обычно возвращаются тому, кто обслуживает генератор, находки содержимого — тому, кто поставлял шрифты и шаблоны, а отчёт, смешивающий их, отправляет обоих гоняться за чужими проблемами
Каждая проблема несёт имя своего enum как Code и рекомендацию, называющую лекарство конкретно, например «Split dictionaries so none carries more than 4095 entries». Учтите, что категория Structure держит ещё две находки — отсутствие размеченной структуры при заявке Level A и cross-reference или object-потоки PDF 1.5 в файле PDF/A-1, — так что фильтруйте по коду, когда вам нужны только четыре лимита
uses
  System.SysUtils, System.Classes, PDFium, FPdfPreflightReport;

procedure ReportStructureFindings(const FileName: string; Log: TStrings);
var
  Pdf: TPdf;
  Report: TPdfPreflightReport;
  Issues: TPdfPreflightIssues;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;          // этот путь загружает DLL PDFium
    if not Pdf.Active then
      Exit;
    Report := BuildPdfPreflightReport(Pdf, [ppsPdfA]);
    Issues := Report.FilterByCategory('Structure').FlattenIssues;
    for I := 0 to High(Issues) do
      Log.Add(Issues[I].Code + ': ' + Issues[I].Recommendation);
    Report.SaveJsonToFile(ChangeFileExt(FileName, '.preflight.json'));
  finally
    Pdf.Free;
  end;
end;
Два пути отвечают на слегка разные вопросы. BuildPdfPreflightReport идёт через TPdf.ValidatePdfA, который сохраняет открытый документ во временную копию, гоняет по ней тот же байтовый скан и затем добавляет проверки, требующие движка PDFium, — например, шрифты, используемые на странице, но не встроенные. ValidatePdfACompliance судит точные байты на диске. Для лимитов реализации доверять стоит байтовому пути по исходному файлу: он рапортует о файле, который вы вот-вот заархивируете, и работает в шаге сборки или зажатой службе, куда нативную DLL не развернёшь. Путь отчёта берите, когда нужны ещё и проверки уровня движка и вывод JSON, SARIF или JUnit для конвейера
Куда двигаться дальше
Прогон этих проверок по папке, решение, какие находки блокируют релиз, и превращение результата в отчёт, который люди будут читать, разобраны в материале о preflight-валидации PDF/A в Delphi и в CLI пакетного preflight-отчёта. Какую часть PDF/A и уровень соответствия целить с самого начала — предмет заметок о архивном соответствии PDF/A; тот выбор решает, между прочим, применяется ли целочисленный лимит
Показанные здесь валидаторы поставляются с PDFium Component для Delphi, C++Builder и Lazarus — вместе с рендерингом, заполнением форм и редактированием поверх движка PDFium. Поддерживаемые стандарты соответствия, редакции и версии компиляторов перечислены на странице продукта PDFium Component