Извлечение таблиц в PDFium Component начиная с версии 3.117.0 считает тонкий залитый прямоугольник линейкой таблицы. При включённом DetectFilledRulings, а он включён по умолчанию, залитый выровненный по осям прямоугольник толщиной не больше MaxRulingThickness (3 пункта) становится одной линейкой вдоль своей длинной оси, более крупный залитый прямоугольник отдаёт свои четыре края, а каждая координата линейки схлопывается в пределах RulingSnapTolerance (4 пункта) до того, как собирается сетка. Поэтому таблицы, экспортированные из Word, Google Docs и браузеров, доходят до детектора сеток полными сетками, а не проваливаются в обнаружение по пробелам фрагментами
Более ранняя статья про обнаружение и извлечение таблиц утверждала, что обнаружение по линейкам использует нарисованные линии и что каждый штрихованный сегмент пути переводится в координаты страницы. Фраза была верной и неполной. Подсчёт объектов путей по набору из 13 реальных образцов показал, что в 9 из них нет ни одного штрихованного пути, а на каждой их странице лежат сотни залитых прямоугольников толщиной от 0,5 до 1 пункта. Детектор, смотревший только на штрих, не видел ничего, каждая страница проваливалась в обнаружение по пробелам, и вывод получался россыпью мелких фрагментов вместо таблиц. Пресет компактных столбцов, добавленный в 3.116.4, смягчал это на уровне фрагментов; корень же был в том, что детектор читал не тот оператор рисования
Почему у таблицы из Word нет штрихованных линий?
Текстовый процессор мыслит рамку не линией, а блоком с шириной и закрашивает этот блок заливкой. ISO 32000-1 §8.5.2.1 определяет оператор re как добавляющий подпуть прямоугольника, а §8.5.3 разделяет операторы рисования: S обводит путь текущей толщиной линии, f заливает его внутренность. Рамка ячейки в 0.5 пункта выходит как x y w 0.5 re f, и вся машинерия обводки — толщина линии, соединения, штриховой узор — не запускается вообще. Заливка ячейки — та же конструкция с блоком побольше. Штрихованная сетка, нарисованная через m, l и S, — это то, что ожидал исходный детектор, и то, что не выдаёт почти ни один экспорт из офисного приложения:
% рамка одной ячейки из экспорта текстового процессора: залитый блок высотой 0.5 пт
72 700 468 0.5 re f
% заливка ячейки: залитый блок размером с ячейку
72 676 117 24 re f
% штрихованная линия сетки, под которую писался исходный детектор
72 700 m 540 700 l S
Для детектора, который спрашивает у FPDFPath_GetDrawMode только про выставленный флаг обводки, оба залитых блока невидимы. Слова внутри ячеек тогда доходят до обнаружения по пробелам, где столбцы, разделённые промежутком в 6 пунктов, не дотягивают до MinColumnGap по умолчанию в 12 пунктов, и назад возвращается то подмножество строк, которое случайно выровнялось достаточно, чтобы пройти MinRows. Это и есть поведение фрагментов, и никакая настройка параметров не превратит его в сетку, которую нарисовал автор
Как PDFium Component превращает залитый блок в линейку?
TableCollectObjectRulings осматривает каждый объект пути по одному подпути за раз. Режим рисования берётся из FPDFPath_GetDrawMode; путь считается залитым, когда DetectFilledRulings включён и режим заливки не none. Каждая точка преобразуется через матрицу объекта и собирается, до MaxSubpathPoints (8) на подпуть, и любой сегмент кривой помечает подпуть как кривой. Когда подпуть замыкается или начинается новый MoveTo, FlushSubpath решает, чем он был: кривой подпуть отбрасывается, как и любой замкнутый многоугольник, чьи точки не лежат все в пределах PointTolerance (0.05 пункта) от краёв ограничивающего блока хотя бы по одной оси. Треугольник, шеврон или скруглённый ярлычок линейкой не становится, и именно это не пускает декоративную графику в сетку
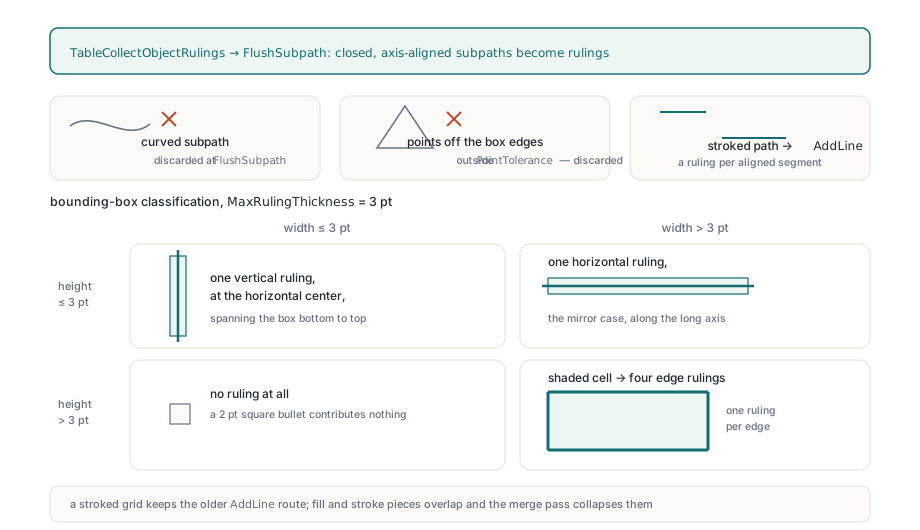
Выживает выровненный по осям прямоугольник, классифицируемый по своему ограничивающему блоку. Ширина не больше MaxRulingThickness при большей высоте даёт одну вертикальную линейку по горизонтальному центру, тянущуюся через блок снизу вверх; зеркальный случай даёт одну горизонтальную линейку. Оба размера выше порога означают залитую ячейку, и блок отдаёт четыре линейки, по одной на край. Оба размера не больше порога не дают ничего, так что квадратный маркер списка в 2 пункта за линию не принимается. Штрихованный путь идёт старым маршрутом через AddLine, по одной линейке на выровненный по осям сегмент, так что сетка, нарисованная через S, обрабатывается ровно как раньше, а путь, закрашенный и заливкой, и обводкой, даёт перекрывающиеся куски, которые схлопывает проход слияния:
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  Mode: string;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;                     // с отсчётом от 1

    Options := TPdfTableExtractionOptions.Default;
    // это значения по умолчанию 3.117.0, выписаны для наглядности
    Options.DetectFilledRulings := True;     // тонкие залитые блоки становятся линейками
    Options.MaxRulingThickness := 3.0;       // пункты; более толстые блоки считаются заливкой
    Options.RulingSnapTolerance := 4.0;      // пункты; 0 отключает схлопывание
    Options.IncludeFormXObjects := True;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
    begin
      if Tables[I].DetectionMode = ptdmRuled then
        Mode := 'ruled'
      else
        Mode := 'whitespace';
      Writeln(Format('%dx%d %s, confidence %.2f',
        [Tables[I].RowCount, Tables[I].ColumnCount, Mode,
         Tables[I].Confidence]));
    end;
  finally
    Pdf.Free;
  end;
end;
Что делает RulingSnapTolerance для таблиц из залитых ячеек?
RulingSnapTolerance — то, что заставляет таблицу, построенную на одной только заливке, соединиться в единую сетку. Некоторые экспорты не рисуют рамок вообще: каждая ячейка — залитый блок своего цвета, а соседние блоки разделены белым промежутком в 1–3 пункта. Каждый блок даёт четыре линейки по краям, но правый край одной ячейки и левый край следующей стоят в 2 пунктах друг от друга, а проверка связности использует RulingTolerance, по умолчанию равный 1 пункту. Без схлопывания каждая ячейка образует свою связную компоненту из четырёх линеек, ни одна компонента не дотягивает до MinRows, и страница не сообщает ничего. TableSnapRulings собирает все задействованные координаты X (положение каждой вертикальной линейки плюс начало и конец каждой горизонтальной) и точно так же все координаты Y, сортирует каждый список, кластеризует его, сцепляя значения, чьи соседи отличаются не больше допуска, заменяет каждый кластер его средним и затем сдвигает каждое положение, начало и конец к ближайшему центру кластера. Две стороны промежутка становятся одной линией, и связность держится
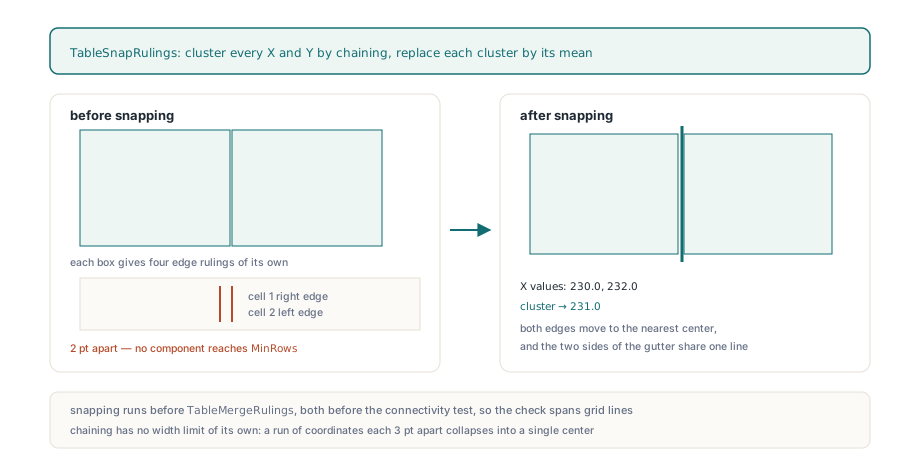
Схлопывание идёт до TableMergeRulings, который сортирует линейки и сращивает коллинеарные куски, соприкасающиеся или перекрывающиеся в пределах RulingTolerance, и оба прохода идут до того, как TableDetectRuled вообще увидит данные, поэтому попарная проверка связности пропорциональна числу линий сетки, а не числу поячеечных фрагментов. На штрихованной сетке эти проходы безвредны, потому что уже одинаковые координаты схлопываются сами в себя. Держать в голове стоит одно: у цепной кластеризации нет собственного ограничения ширины — серия координат с шагом 3 пункта сольётся в один центр. При значении по умолчанию в 4 пункта это затрагивает только столбцы уже одного символа, но если в документе есть настоящие трёхпунктовые промежутки, которые должны остаться раздельными, уменьшите допуск или выставьте 0, чтобы отключить схлопывание:
// Изолируем стратегию по линейкам и сравним, что каждая настройка видит на одной странице
function CountRuledTables(Pdf: TPdf; FilledRulings: Boolean;
  SnapTolerance: Double): Integer;
var
  Options: TPdfTableExtractionOptions;
begin
  Options := TPdfTableExtractionOptions.Default;
  Options.DetectWhitespaceTables := False;
  Options.DetectFilledRulings := FilledRulings;
  Options.RulingSnapTolerance := SnapTolerance;
  Result := Length(Pdf.ExtractTables(Options));
end;

// Экспорт из Word обычно даёт 0, N и затем меньше N:
// вариант только по штрихам не видит ничего, схлопывание связывает залитые ячейки,
// а отключение схлопывания оставляет каждую залитую ячейку отдельным островом
Writeln(CountRuledTables(Pdf, False, 4.0));
Writeln(CountRuledTables(Pdf, True, 4.0));
Writeln(CountRuledTables(Pdf, True, 0.0));
Линейки внутри form XObject
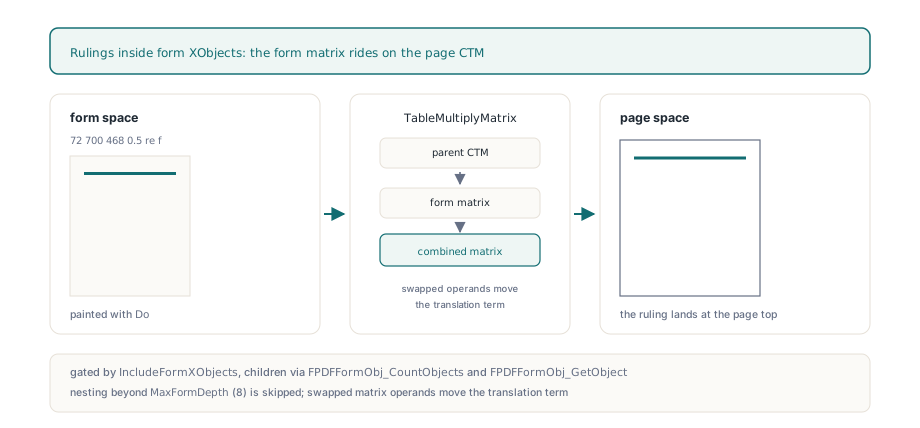
Инструменты вёрстки часто заворачивают таблицу или всё тело страницы в form XObject и рисуют его через Do. ISO 32000-1 §8.10.1 указывает, что матрица формы присоединяется к текущей матрице преобразования, когда форма отрисовывается, поэтому прямоугольник внутри формы живёт в пространстве формы и попадает на страницу только после двух или более преобразований. TableCollectObjectRulings рекурсивно спускается в объекты форм, когда выставлен IncludeFormXObjects: он читает матрицу объекта, объединяет её с родительской матрицей через TableMultiplyMatrix, чей порядок аргументов означает «отобразить через первую матрицу, затем через вторую», и перечисляет детей через FPDFFormObj_CountObjects и FPDFFormObj_GetObject, передавая объединённую матрицу вниз. Вложенность глубже MaxFormDepth (8) молча пропускается — это защита от патологических файлов, а не предел, к которому подбирается хоть какой-то реальный экспорт. Порядок умножения важен по той же причине, что разобрана в материале про prepend и append матриц: перестановка операндов сдвигает член переноса, и линейка, которая должна попасть в верх страницы, попадает вместо этого в начало координат
Почему бюджет линеек вырос в четыре раза?
Значение MaxRulingSegments по умолчанию выросло с 4096 до 16384 в 3.117.0, потому что поячеечные рамки приходят в куда большем количестве, чем штрихованные линии сетки. Штрихованная таблица на 30 строк и 6 столбцов — это 38 сегментов линий. Та же таблица, экспортированная залитыми блоками, — до четырёх рамок на ячейку, 720 кусков до слияния, а форма с залитыми ячейками удваивает это. Две такие таблицы на странице исчерпали бы старый бюджет. Бюджет проверяется в TableAppendRuling через Check, который возбуждает EPdfError с сообщением «Table ruling-segment budget exceeded»; деградировавшего результата нет, частичной сетки нет, и проход по пробелам тоже не запускается. Если вы задаёте свой, более тесный бюджет для недоверенного ввода, ловите исключение и решайте сами, а не читайте пустой результат как «таблиц нет»:
Options := TPdfTableExtractionOptions.Default;
Options.MaxRulingSegments := 2048;        // намеренно тесно для недоверенного ввода
try
  Tables := Pdf.ExtractTables(Options);
except
  on E: EPdfError do
  begin
    Log(E.Message);                       // 'Table ruling-segment budget exceeded'
    Options.MaxRulingSegments := 16384;   // значение по умолчанию 3.117.0
    Tables := Pdf.ExtractTables(Options);
  end;
end;
Измеренные результаты и где подход останавливается
На тех же 13 образцах извлечение прошло путь от 43 таблиц, из которых 9 были по линейкам, а 34 — фрагментами по пробелам или ложными срабатываниями, до 41 таблицы по линейкам и полного отсутствия ложных срабатываний по пробелам. Часть этой чистки принадлежит двум сопутствующим изменениям в 3.117.0: слова, уже занятые сеткой по линейкам, удаляются до запуска обнаружения по пробелам, так что таблица никогда не сообщается дважды, а граница столбца по пробелам теперь должна быть свободным от текста коридором по всем строкам, которые она разделяет, — именно это не дало выключенным по формату абзацам засчитаться как таблицы 5x4. Читатель залитых прямоугольников — то, что перевело сами таблицы из колонки фрагментов в колонку линеек
Границы стоит назвать прямо. Страница без текстового слоя всё равно даёт скелет сетки, но все ячейки пустые, потому что линейки берутся из геометрии, а текст — с текстовой страницы; сканированным страницам сначала нужен OCR. Залитые фигуры с кривыми, скруглёнными углами или непрямоугольными контурами отбрасываются целиком, так что таблица, чьи рамки нарисованы контурами со скруглёнными углами, по-прежнему нуждается в обнаружении по пробелам. Таблица без рамок и без заливки от всего этого не меняется и остаётся вотчиной стратегии по пробелам, описанной в статье про извлечение таблиц; когда и этого не хватает, рамки слов и блоки из материала про структурированный текст и порядок чтения служат сырьём для читателя под конкретную предметную область. Демо TableExtractionLab, поставляемое с компонентом, выставляет DetectFilledRulings на своей панели параметров — это самый быстрый способ увидеть, как выглядит конкретный экспорт с ним и без него; полный API описан на странице PDFium Component для Delphi