Таблица, бегущая через три страницы экспорта Word, никогда не подходит ближе 72 точек к нижнему краю бумаги. Поля в один дюйм — это 72 точки, и текстовый процессор прекращает класть строки на полях. Связыватель, соединяющий фрагменты, только когда они сидят в 36 точках от краёв страницы, видит три несвязанные таблицы с одинаковыми колонками. Работающий вопрос другой: сидит ли что-то, кроме бегущего колонтитула, между концом одного фрагмента и началом следующего?
Тот вопрос приносит две собственные ловушки. Форма может кончить одну таблицу внизу страницы 1 и открыть другую таблицу с той же шириной колонок наверху страницы 2. А линованная сетка может перегнать одиночную строку через разрыв — слишком короткую для детектора, желающего две строки, прежде чем назвать что-то таблицей
Две проверки краёв в ExtractDocumentTables
PDFium Component помечает продолжения в TPdf.ExtractDocumentTables — документном собрате постраничного ExtractTables из статьи о детектировании и извлечении таблиц. С выставленным DetectContinuations, как в TPdfTableExtractionOptions.Default, метод извлекает каждую страницу, сортирует таблицы по номеру страницы и затем сверху вниз внутри страницы, и проверяет каждую пару соседей в том списке. Сравниваются только соседи. Кандидат в продолжения потому всегда — нижняя таблица страницы N в паре с верхней таблицей страницы N+1, и маленькая таблица, поставленная под длинной на странице N, занимает место длинной в той паре. Когда короткая таблица-заметка сидит под длинной, связывайте те фрагменты в собственном коде по номерам страниц и ColumnCount
Первая проверка чисто геометрическая. Нижняя грань раннего фрагмента обязана лежать в пределах ContinuationMargin точек от низа страницы, а верхняя грань позднего — на том же расстоянии от верха следующей страницы. Дефолт — 36 точек, полдюйма. Отчёты движков вёрстки, заполняющих фиксированный content box, проходят её легко. Экспорт Word с полями в один дюйм промахивается минимум на 36 точек с каждой стороны, а раздвигать поля до прохода — путь неверный, потому что тем же числом задаются полосы колонтитулов второй проверки
Вторая проверка, учитывающая содержимое, — та, что справляется с выводом текстовых процессоров. Две комбинируются через OR: любая одна открывает ворота
Что считается текстом между двумя фрагментами?
Каждое слово на странице считается текстом тела, если только оно не лежит целиком внутри полосы бегущего верхнего или нижнего колонтитула, и обе полосы ContinuationMargin точек в глубину. На каждой странице ExtractDocumentTables записывает наинизшую нижнюю грань среди слов, чей верх выше полосы нижнего колонтитула, и наивысшую верхнюю грань среди слов, чей низ ниже полосы верхнего, включая собственный текст ячеек таблицы. Когда таблица — последнее содержимое тела на странице N, её нижняя грань сидит на уровне наинизшего слова или ниже, и проверка проходит в пределах AlignmentTolerance, дефолт которого 3 точки. Поздний фрагмент обязан выполнить зеркальное условие наверху страницы N+1
Игнорирование полос имеет опору в спецификации. ISO 32000-1 §14.8.2.2 трактует бегущие головы, ноги и номера страниц как артефакты пагинации — содержимое, существующее лишь потому, что документ был разрезан на страницы. Тегированный файл может объявить их через /Artifact, как объясняет статья о marked content, но экспорты, больше всех нуждающиеся в сшивании таблиц, редко несут теги, поэтому позиция замещает тег. С дефолтной полосой номер страницы, чьи глифы кончаются в 30 точках над нижним краем, игнорируется. Строка отказа, дотягивающаяся до 40 точек, — текст тела, и она блокирует связь
На странице без текстового слоя сохранённые экстремумы откатываются к границам страницы, проверка по содержимому проходит тривиально, и решают оставшиеся ворота. Ноги, нарисованные картинками или векторными контурами, невидимы по той же причине и никогда не блокируют связь
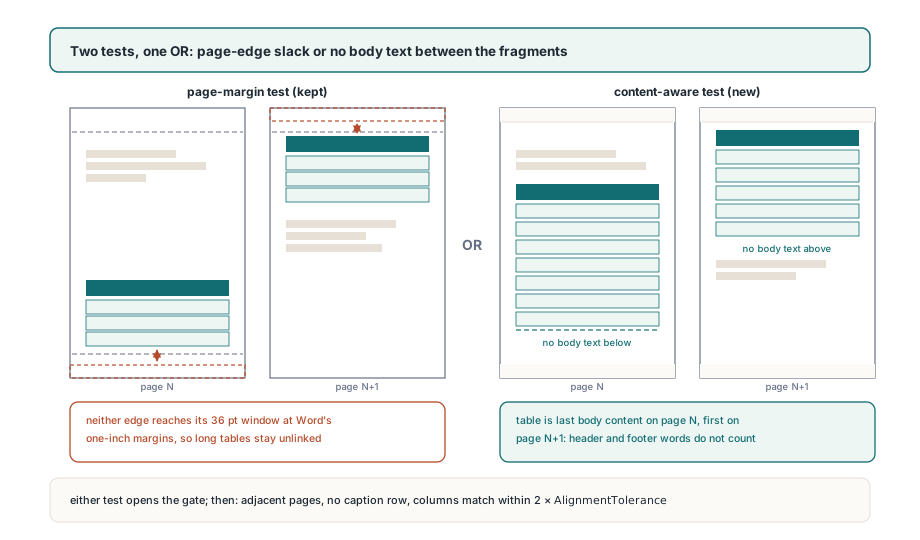
Прохождение проверки краёв лишь открывает ворота. Страницы обязаны быть последовательными, поздний фрагмент не должен открываться строкой подписи, а границы колонок обязаны сойтись в пределах удвоенного AlignmentTolerance — 6 точек при дефолтах. Когда всё это держится, ранний фрагмент становится ptcStart со свежим номером группы или переходит из ptcEnd в ptcMiddle, если уже закрывал цепочку, а поздний фрагмент становится ptcEnd в той же группе. Таблица на трёх страницах читается start, middle, end. Номера групп стартуют с 1; группа 0 с ptcNone означает, что таблица стоит одна. ToJson пишет те же данные как "continuationGroup" и "continuation" (none, start, middle или end), так что сервис, принимающий JSON, может сшивать сам
Листинг ниже предполагает экспорт Word с двухстрочным нижним колонтитулом глубиной около 50 точек, поэтому поле поднято до 54, чтобы обе строки сидели внутри полосы
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // нижний колонтитул принят глубиной ~50 пт

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
Как полноширинная первая строка разводит две таблицы
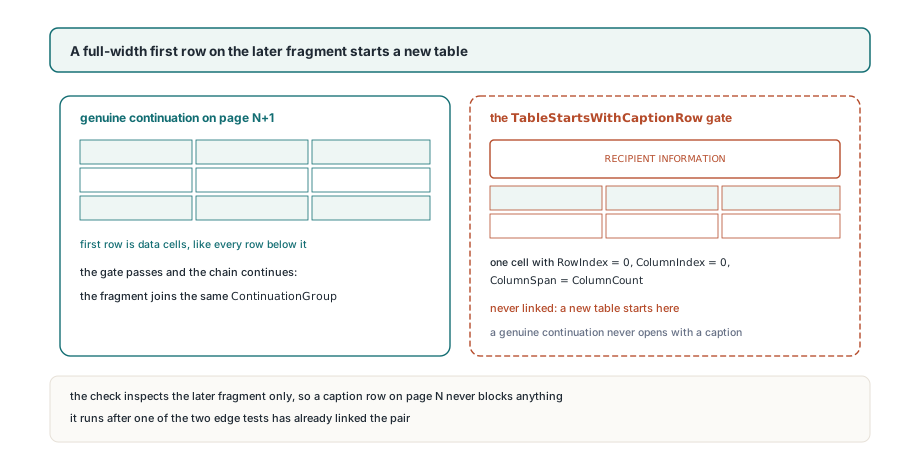
Поздний фрагмент, чья первая строка — одиночная ячейка через все колонки, докладывается новой таблицей, даже когда проверка краёв прошла и колонки совпали. Формы — то место, где проверка по содержимому перегнула бы: одна таблица кончается у низа страницы 1, следующий раздел открывается на странице 2 с идентичными ширинами колонок, и каждая геометрическая проверка проходит. Разница — открывающая строка второй таблицы, подпись раздела вроде RECIPIENT INFORMATION, выложенная одной слитой ячейкой на всю ширину. Настоящее продолжение так не открывается, потому что подпись таблицы остаётся на странице, где таблица начинается
Правило читает только ячейки позднего фрагмента. Тому фрагменту нужно минимум две колонки и ячейка с RowIndex = 0, ColumnIndex = 0 и ColumnSpan = ColumnCount. Ранний фрагмент никогда не инспектируется, поэтому таблица, чья собственная подпись сидит наверху страницы N, нормально связывается со своим продолжением на странице N+1
Следующее сравнение колонок строже равного количества колонок. Позиции границ каждого фрагмента перестраиваются из прямоугольников его ячеек; граница, спрятанная под слитой ячейкой, достраивается равномерным распределением между ближайшими известными границами по обе стороны. Затем сравнивается каждая пара границ, и разница выше 6 точек отвергает связь. Две четырёхколоночные таблицы с разными пропорциями остаются врозь. Как и настоящее продолжение, чей генератор сдвинул колонку на 8 точек между страницами; поднять AlignmentTolerance, чтобы принять его, значит заодно ослабить кластеризацию, используемую при детектировании
Одна линованная строка через разрыв страницы
Линованная сетка, перегнавшая одиночную строку на следующую страницу, сохраняет ту строку, когда вливается в цепочку, и теряет её, когда нет. Дефолтный MinRows в 2 не даёт паре случайных линеек докладываться таблицей. Строка, перегнанная через разрыв, — другое: это настоящие данные, и выбросить её — оставить сшитую таблицу короче на строку без всякого фрагмента, объясняющего прореху
Документный скан справляется с этим в три шага. Когда DetectContinuations и DetectRuledTables включены оба, линованный детектор гоняется на каждой странице с полом строк, опущенным до 1. Затем продолжения помечаются по всему результату. Наконец, каждая таблица с числом строк меньше пользовательского MinRows, не оказавшаяся в цепочке, удаляется. Однострочная сетка посреди обычной страницы проходит тот фильтр и исчезает — ровно для того MinRows и существует
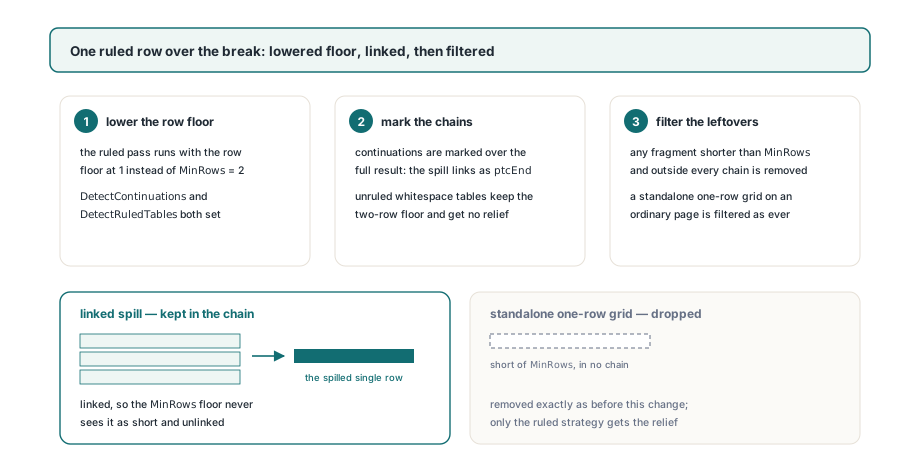
Оставьте MinRows на 2. Выставив его в 1 сами, вы выключаете финальный фильтр, и каждая однострочная линованная сетка на каждой странице возвращается
Исключение касается только линованных сеток. Стратегия пробелов требует минимум двух выровненных строк, чтобы признать таблицу, поэтому держит внутренний пол 2, что бы ни говорил MinRows; ExtractTables принимает MinRows = 1, но чтит его только линованное детектирование. Для нелинованной таблицы, перелившей строку, боксы слов страницы или блоки из статьи о структурных текстовых блоках и порядке чтения дают позиции, чтобы вернуть ту строку самому
Сшивание цепочки обратно в одну таблицу
Цепочки возвращаются сплошными. Связи делаются только между соседями в отсортированном массиве, поэтому за фрагментом ptcStart напрямую идут его фрагменты ptcMiddle и ptcEnd, и цикл, сбрасывающийся на ptcNone или ptcStart и записывающий на ptcNone или ptcEnd, не ищет ничего по номеру группы
Повторяемая строка заголовка — хитрая часть: Word может повторять её на каждой странице, прочие генераторы — нет. Флаг IsHeader на TPdfTableCell того не решит, потому что назначается по позиции, RowIndex < HeaderRowCount, отдельно для каждого фрагмента. Строка 0 продолжения помечается как заголовок — повторяет ли она заголовок или несёт данные, — и однострочный перелив из предыдущего раздела помечен тоже. Процедура ниже сравнивает текст первой строки каждого продолжения с первой строкой цепочки и отбрасывает её только при точном совпадении
Она вдобавок строит строки из Cells, а не режет вывод ToCsv на строки. Ячейка, чей текст переносится внутри ячейки, возвращается с CR LF между визуальными строками, ToCsv хранит тот разрыв внутри квотированного поля, а удаление первой строки CSV-текста разрезало бы двухстрочную ячейку заголовка пополам
// Помощники на стороне чтения (не часть библиотеки): пересоберите каждую цепочку
// в один файл с табуляцией, отбрасывая заголовки, повторённые на поздних страницах
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // заголовок, повторённый на этой странице
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
Точное сравнение — правильный выбор. Заголовок, повторенный текстовым процессором, совпадает посимвольно, тогда как нечёткий матч рано или поздно проглотит строку данных, похожую на заголовок. Лишний случайный заголовок легко заметить в выводе; недостающую строку данных — нет
Измерение полосы нижнего колонтитула вместо гадания
ContinuationMargin делает три работы одним числом: слабину по краям страницы для первой проверки, глубину полосы нижнего колонтитула и глубину полосы верхнего для второй. Нога глубже полосы оставляет свою верхнюю строку в зоне тела, ранний фрагмент выглядит так, будто за ним следует текст, и цепочка рвётся на той странице. Полоса, выставленная слишком глубоко, начинает глотать настоящее содержимое: короткая закрывающая строка прямо над нижним полем падает внутрь неё, и таблица над той строкой может тогда связаться с чем угодно, открывающим следующую страницу
Число может подать сам документ. TPdf.PageWordBoxes возвращает каждое слово текущей страницы с Rect в пространстве страницы, чей Top больше его Bottom, поэтому наивысший Top среди слов ниже поля тела — глубина нижнего колонтитула. Проба ниже берёт значение чуть под нижним полем вёрстки — 70 для страницы в один дюйм — и держит 36 точек полом для документов без колонтитула
// Помощник на стороне чтения (не часть библиотеки): наивысший верх слова,
// найденный ниже BodyMargin на любой странице, то есть глубина зоны нижнего колонтитула
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// нужен System.Math ради Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
Полоса одинаковой глубины на обоих краях, поэтому измерьте глубокий бегущий верхний колонтитул тоже от верха страницы и возьмите большее значение. Держите слабину в пару точек: каждая лишняя точка — точка текста тела, которую проверка по содержимому перестаёт видеть
Одна вёрстка побеждает правило подписей по построению: генератор, пишущий слитый баннер «continued» первой строкой каждого фрагмента-продолжения. Каждый такой фрагмент докладывается новой таблицей, так что связывайте их в собственном коде по последовательным номерам страниц, равному ColumnCount и тексту баннера в строке 0
Пометка продолжений, правило подписей и однострочное исключение — всё внутри ExtractDocumentTables, которое ведёт себя одинаково в сборках Delphi, C++Builder и Lazarus. Полный набор опций извлечения таблиц перечислен на странице PDFium Component for Delphi