Загрузчик Delphi, разбирающий пакет XLSX из восьми листов на восьми рабочих потоках, может показывать график CPU, едва поднимающийся выше одного ядра, а прогон числа потоков от двух до восьми оставляет секундомер почти на месте. С двумя потоками загрузка может выйти даже медленнее простого последовательного цикла. Код парсинга не берет блокировок сам и листы не делят данных, так что ожидание происходит там, где исходный код его не упоминает: внутри менеджера памяти, к которому каждый из этих воркеров обращается за каждым именем элемента, значением атрибута и ячейкой
Число потоков — ручка, за которую все тянут первой. Для кода, связанного аллокациями, она почти ничего не двигает. Кривую двигает число выделений памяти в куче на каждую ячейку
Как HotXLS делит Open на три фазы
HotXLS по умолчанию разбирает листы многолистового пакета XLSX на рабочих потоках. TXLSXWorkbook.ParallelParse стартует как True, а ParallelParseThreads стартует с 0, что означает по одному воркеру на каждый логический процессор, о котором сообщает операционная система, и никогда больше воркеров, чем есть листов для разбора. Из трех фаз Open на этих воркерах выполняется только одна. Фаза A последовательна: она читает часть workbook, общие строки (shared strings) и стили, создает каждый лист с его именем и видимостью и разбирает файл отношений каждого листа, так что цели гиперссылок и таблиц уже разрешены. К моменту старта воркера каждая таблица поиска, к которой он обращается, полна и только читается
Фаза B отдает каждый лист воркеру. Воркеры разбирают индексы листов из общего счетчика с помощью interlocked-инкремента, так что книга с одним большим листом и семью маленькими балансируется сама, без планировщика: кто закончил маленький лист, просто берет следующий индекс. ZIP-контейнер — та часть, которую нельзя наивно расшарить, потому что deflate-поток несет состояние от блока к блоку, и два потока не могут двигать один декомпрессор. Поэтому каждый воркер открывает свой собственный декомпрессор над своей записью листа и льет XML прямо в свой собственный ридер. Файловый хэндл — единственный общий ресурс, и блокировка вокруг него покрывает один seek-and-read сжатых байтов за раз. Распаковка и разбор идут параллельно, и XML ни одного листа никогда не держится в памяти полностью распакованным. Когда разбор заканчивается, воркер дочитывает свою запись до конца, чтобы проверки размера и CRC ZIP все же выполнились
Фаза C возвращается в один поток для частей, которые висят на каждом листе: комментариев и цепочек комментариев (threaded comments), рисунков и диаграмм, таблиц и настроек печати. В большинстве книг они малы по сравнению с XML ячеек
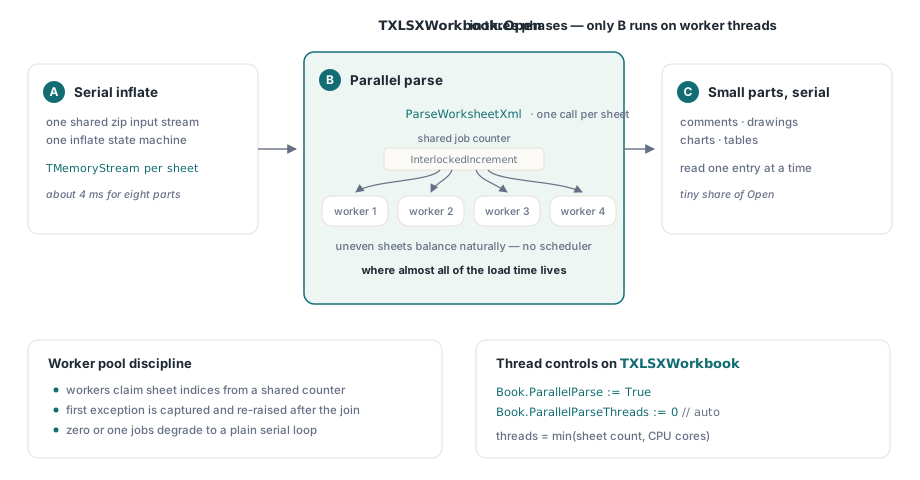
Ошибки возвращаются на вызывающий поток. Когда лист падает во время разбора, пул перестает выдавать новые индексы, дожидается еще работающих воркеров и затем повторно бросает из Open исключение листа с наименьшим номером из упавших, так что отчет следует порядку листов, и вызывающему коду никогда не приходится иметь дело с исключением, вырвавшимся из рабочего потока. С RecoveryMode равным True лист, который не удалось разобрать, пропускается, предупреждение попадает в Diagnostics, а остальные листы грузятся как обычно. Установка ParallelParse в False гоняет тот же парсер по листам по одному и дает идентичные результаты
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Оба значения — значения по умолчанию; прописать их явно — значит
    // оставить выбор видимым при ревью кода
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = по воркеру на логический CPU, не больше числа листов
    Book.RecoveryMode := False;      // лист, который не удалось разобрать, бросает исключение из Open
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // здесь каждый лист загружен полностью; читайте ячейки как обычно
  finally
    Book.Free;
  end;
end;
Почему лишние потоки замедляют парсер, завязанный на аллокации?
Разбор листов — это в основном мелкие аллокации, и менеджер памяти Delphi по умолчанию заставляет потоки ходить по очереди. Наивный XML-ридер создает строку для каждого имени элемента, еще одну для каждого имени и значения атрибута, Variant для ячейки и строку для ее текста. Менеджер памяти по умолчанию держит маленькие блоки в пулах, сгруппированных по размеру, и охраняет каждый пул блокировкой. Поток, заставший блокировку занятой, отступает и засыпает перед повторной попыткой. Когда восемь воркеров просят одну и ту же горстку крошечных размеров, они постоянно сталкиваются на одних пулах, и потоки, выглядящие независимыми в исходнике, оказываются выполняющимися один за другим
Это объясняет оба симптома из вступления. Процессорное время остается близким к астрономическому, потому что спящий поток не жжет CPU, а прогон потоков остается плоским, потому что темп задают блокировки пулов, а не ядра. Два потока могут всухую проиграть одному: каждая аллокация теперь платит за перекидывание блокировки между ядрами, а последовательный цикл вообще ни с кем не конкурирует
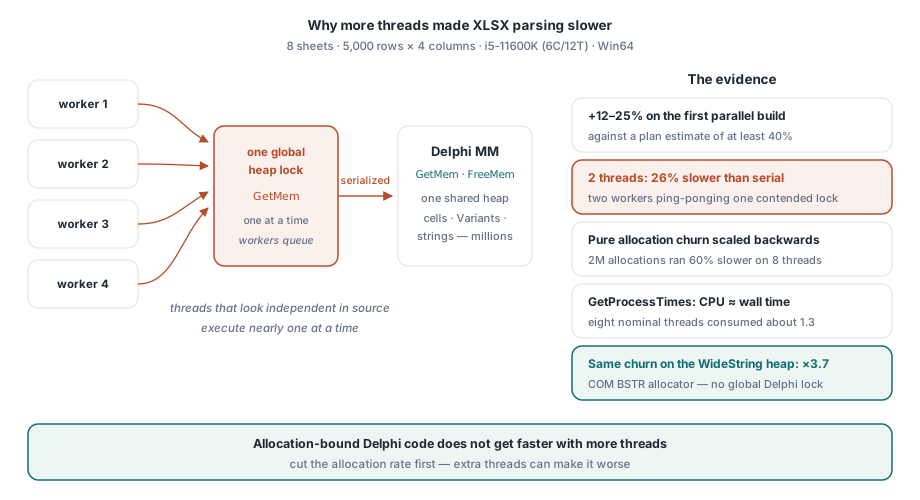
Один строковый тип стоит вне всего этого на Windows. WideString — это COM BSTR, выделяемый системным OLE-аллокатором строк, а не менеджером памяти Delphi, поэтому трафик WideString никогда не стоит в очереди к пулам Delphi. HotXLS хранит текст ячеек как WideString, что для параллельной загрузки важнее, чем это когда-либо было для последовательного пути
Измеряем конкуренцию на своих книгах
Два числа говорят, завязана ли загрузка на аллокации: как меняется астрономическое время с ростом числа воркеров и сколько CPU процесс потребил за тот же интервал. Если процессорное время, деленное на астрономическое, держится около 1.0 при восьми номинально занятых воркерах, они стоят в очереди, а не разбирают. Прогон ниже открывает тот же файл с одним по восемь воркеров и печатает обе цифры. Это измерительный стенд для вашего собственного тестового проекта; из HotXLS приходят только члены TXLSXWorkbook
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Ваш собственный помощник: user + kernel время CPU этого процесса, в миллисекундах
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // тики по 100 нс в миллисекунды
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 запускает обычный последовательный цикл
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Прогоните развертку несколько раз и оставьте лучшую цифру для каждого числа воркеров, потому что первый прогон платит еще и за холодный дисковый кэш. Плоская кривая астрономического времени с CPU/wall около 1 означает, что потолок — менеджер памяти. Если астрономическое время продолжает падать, пока CPU/wall ползет к числу воркеров, файл связан разбором, и лишние воркеры оправдывают свое место
Плоская кривая ведет к следующему вопросу: какие аллокации виноваты? Обертка над менеджером памяти, считающая вызовы по размерам, отвечает за несколько минут безо всякого профайлера. Версия ниже считает только GetMem, оставляя FreeMem и ReallocMem указывающими на оригинальный менеджер — этого достаточно, чтобы увидеть, откуда идет трафик
// Диагностика, которую вы добавляете в свой тестовый стенд; не часть HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // тот избыток мелких блоков, за которым стоит следить
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Установите счетчик прямо перед Open, снимите сразу после и поделите AllocCount на число ячеек в файле. Вот эту цифру на ячейку и надо отслеживать от сборки к сборке, а доля блоков размером до 32 байт покажет, доминируют ли короткие строки. Проверьте ее до того, как писать пул объектов ячеек: каждый объект ячейки — одна аллокация, а короткоживущие строки, созданные при разборе той же ячейки, легко превосходят ее числом в несколько раз
Где в XML листа прячутся аллокации
Ячейка вроде <c r="B7" s="3" t="s"><v>42</v></c> выглядит крошечной на диске. Прямолинейный ридер все равно превращает ее в россыпь свежих строк: имена элементов c и v, три имени атрибутов, три значения атрибутов и текстовое содержимое. Конвертация каждого UTF-8 токена через RTL добавляет промежуточный UnicodeString до того, как появится финальный WideString. Ни одна из этих строк не переживает ячейку, и каждая — поездка через менеджер памяти
XML-ридер HotXLS бьет по двум крупнейшим источникам. Имена элементов в XML листов берутся из очень маленького словаря (row, c, v, f, is), поэтому ридер держит короткий кэш уже встреченных имен, сравнивает сырые байты каждого нового имени с этим кэшем и при совпадении возвращает кэшированную строку. Кэшированные копии нарочно AnsiString. AnsiString учитывает ссылки, поэтому выдача кэшированного экземпляра стоит одного инкремента счетчика и нуля аллокаций. Кэш имен WideString не купил бы ничего: у WideString нет счетчика ссылок, и каждое присваивание делает новую системную аллокацию
Имена атрибутов, значения атрибутов и текст ячейки идут другим маршрутом. Ридер декодирует UTF-8 прямо из буфера сканирования в два прохода: первый считает кодовые единицы UTF-16, второй заполняет WideString, выделенный один раз ровно той длины. Это одна аллокация на токен, и она попадает на системный аллокатор строк, а не в пулы Delphi. Символьные ссылки вроде A и предопределенные сущности разрешаются сканером до начала декодирования, так что декодер видит только чистый UTF-8. Для байтовых последовательностей, не являющихся корректным UTF-8, декодер копирует проблемные байты по одному там, где RTL-конвертация выбросила бы или заменила их, так что поврежденный файл все равно дает читаемый ASCII вокруг плохого места. Корректный вход декодируется в тот же текст в обоих случаях
Оба приема переносятся в ваш собственный код разбора на Delphi. Кэширование строк экономит аллокации, только когда строковый тип учитывает ссылки, а декодирование сразу в целевой тип убирает временную строку, которую удобные RTL-функции конвертации создают при каждом вызове
Какие книги выигрывают и какие настройки выбрать
Параллельный разбор работает на гранулярности листа, так что форму книги решает большую часть исхода. Несколько листов сопоставимого размера — лучший случай, включая файлы, которые вы получаете дублированием листа-шаблона раз за регион или за месяц. Книга из одного гигантского листа разбирается одним воркером, что бы ни говорил ParallelParseThreads; для такой формы лучше подходит потоковый прямой ридер, потому что он вообще не строит книгу в памяти. Время на комментариях, диаграммах и рисунках остается в последовательной фазе C. Файл с нулем или одним листом для разбора пропускает пул и гоняет обычный последовательный цикл
Когда важны только некоторые листы, перечислите их имена в SelectedSheets перед вызовом Open. Остальные листы все еще создаются с именами и видимостью, но без ячеек, воркеры их перепрыгивают, а LoadSheet заполнит такой лист позже, если пользователь его откроет
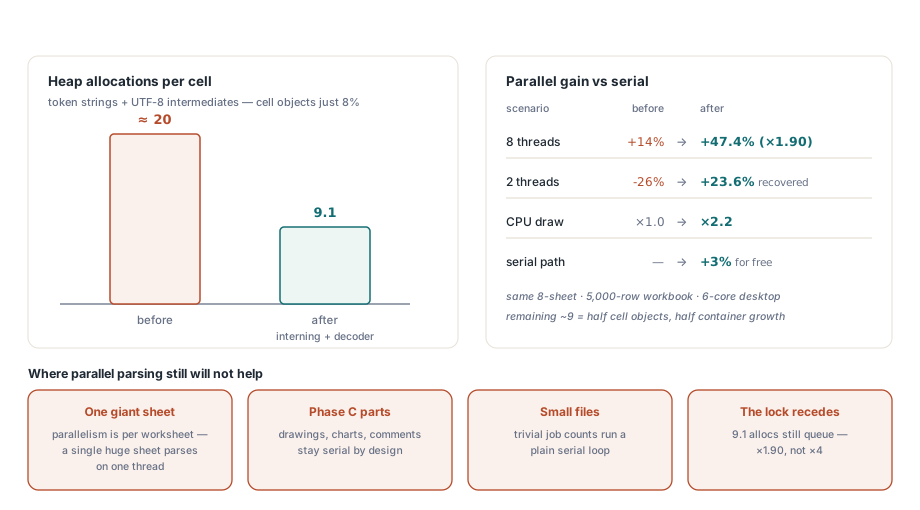
Держите ParallelParse включенным для настольных инструментов и батчей, открывающих одну книгу за раз. Это значение по умолчанию безопаснее: результаты совпадают с последовательным путем, а одно свойство выключает его, если когда-нибудь встанет вопрос о потоках. Сервер, который и так открывает несколько книг параллельно, — другое дело. Каждый поток запросов тоже аллоцирует, так что каждый лишний воркер разбора добавляет еще одного претендента на те же пулы менеджера памяти; поставьте там ParallelParseThreads в 2 и поднимайте только после того, как прогон выше, выполненный на этом сервере под его нормальной нагрузкой, покажет, что лишние воркеры окупаются. Меньше аллокаций на ячейку поднимает потолок, но не убирает его. Объекты ячеек и рост контейнеров все еще идут через пулы Delphi, поэтому выигрыш от восьми воркеров остается намного ниже восьми раз. Об остальном инструментарии загрузки и сохранения, от переиспользования стилей до батчевых колбэков строк, читайте в руководстве по производительности больших книг в Delphi
Пул воркеров, переключатели ParallelParse и ParallelParseThreads и экономный на аллокации XML-ридер поставляются в составе HotXLS Delphi Excel Component, который читает и пишет XLS, XLSX и ODS прямо из кода Delphi и C++Builder без установленного Excel на машине